
Au début de la semaine, une nouvelle plutôt inquiétante a frappé le monde de la technologie : certaines grandes entreprises technologiques utilisaient les sous-titres YouTube pour entraîner leurs modèles d'IA sans le consentement des créateurs de leurs vidéos. L'un de ces géants était censé être Apple, pour laquelle il a été initialement affirmé que les données obtenues de cette manière, qui cependant nestahl hein, mais une certaine startup, qui était la couverture de facto du géant californien, l'a également utilisé pour la formation Apple Intelligence. Mais maintenant Apple dans sa déclaration pour 9to5mac refusé.
Cela pourrait vous intéresser
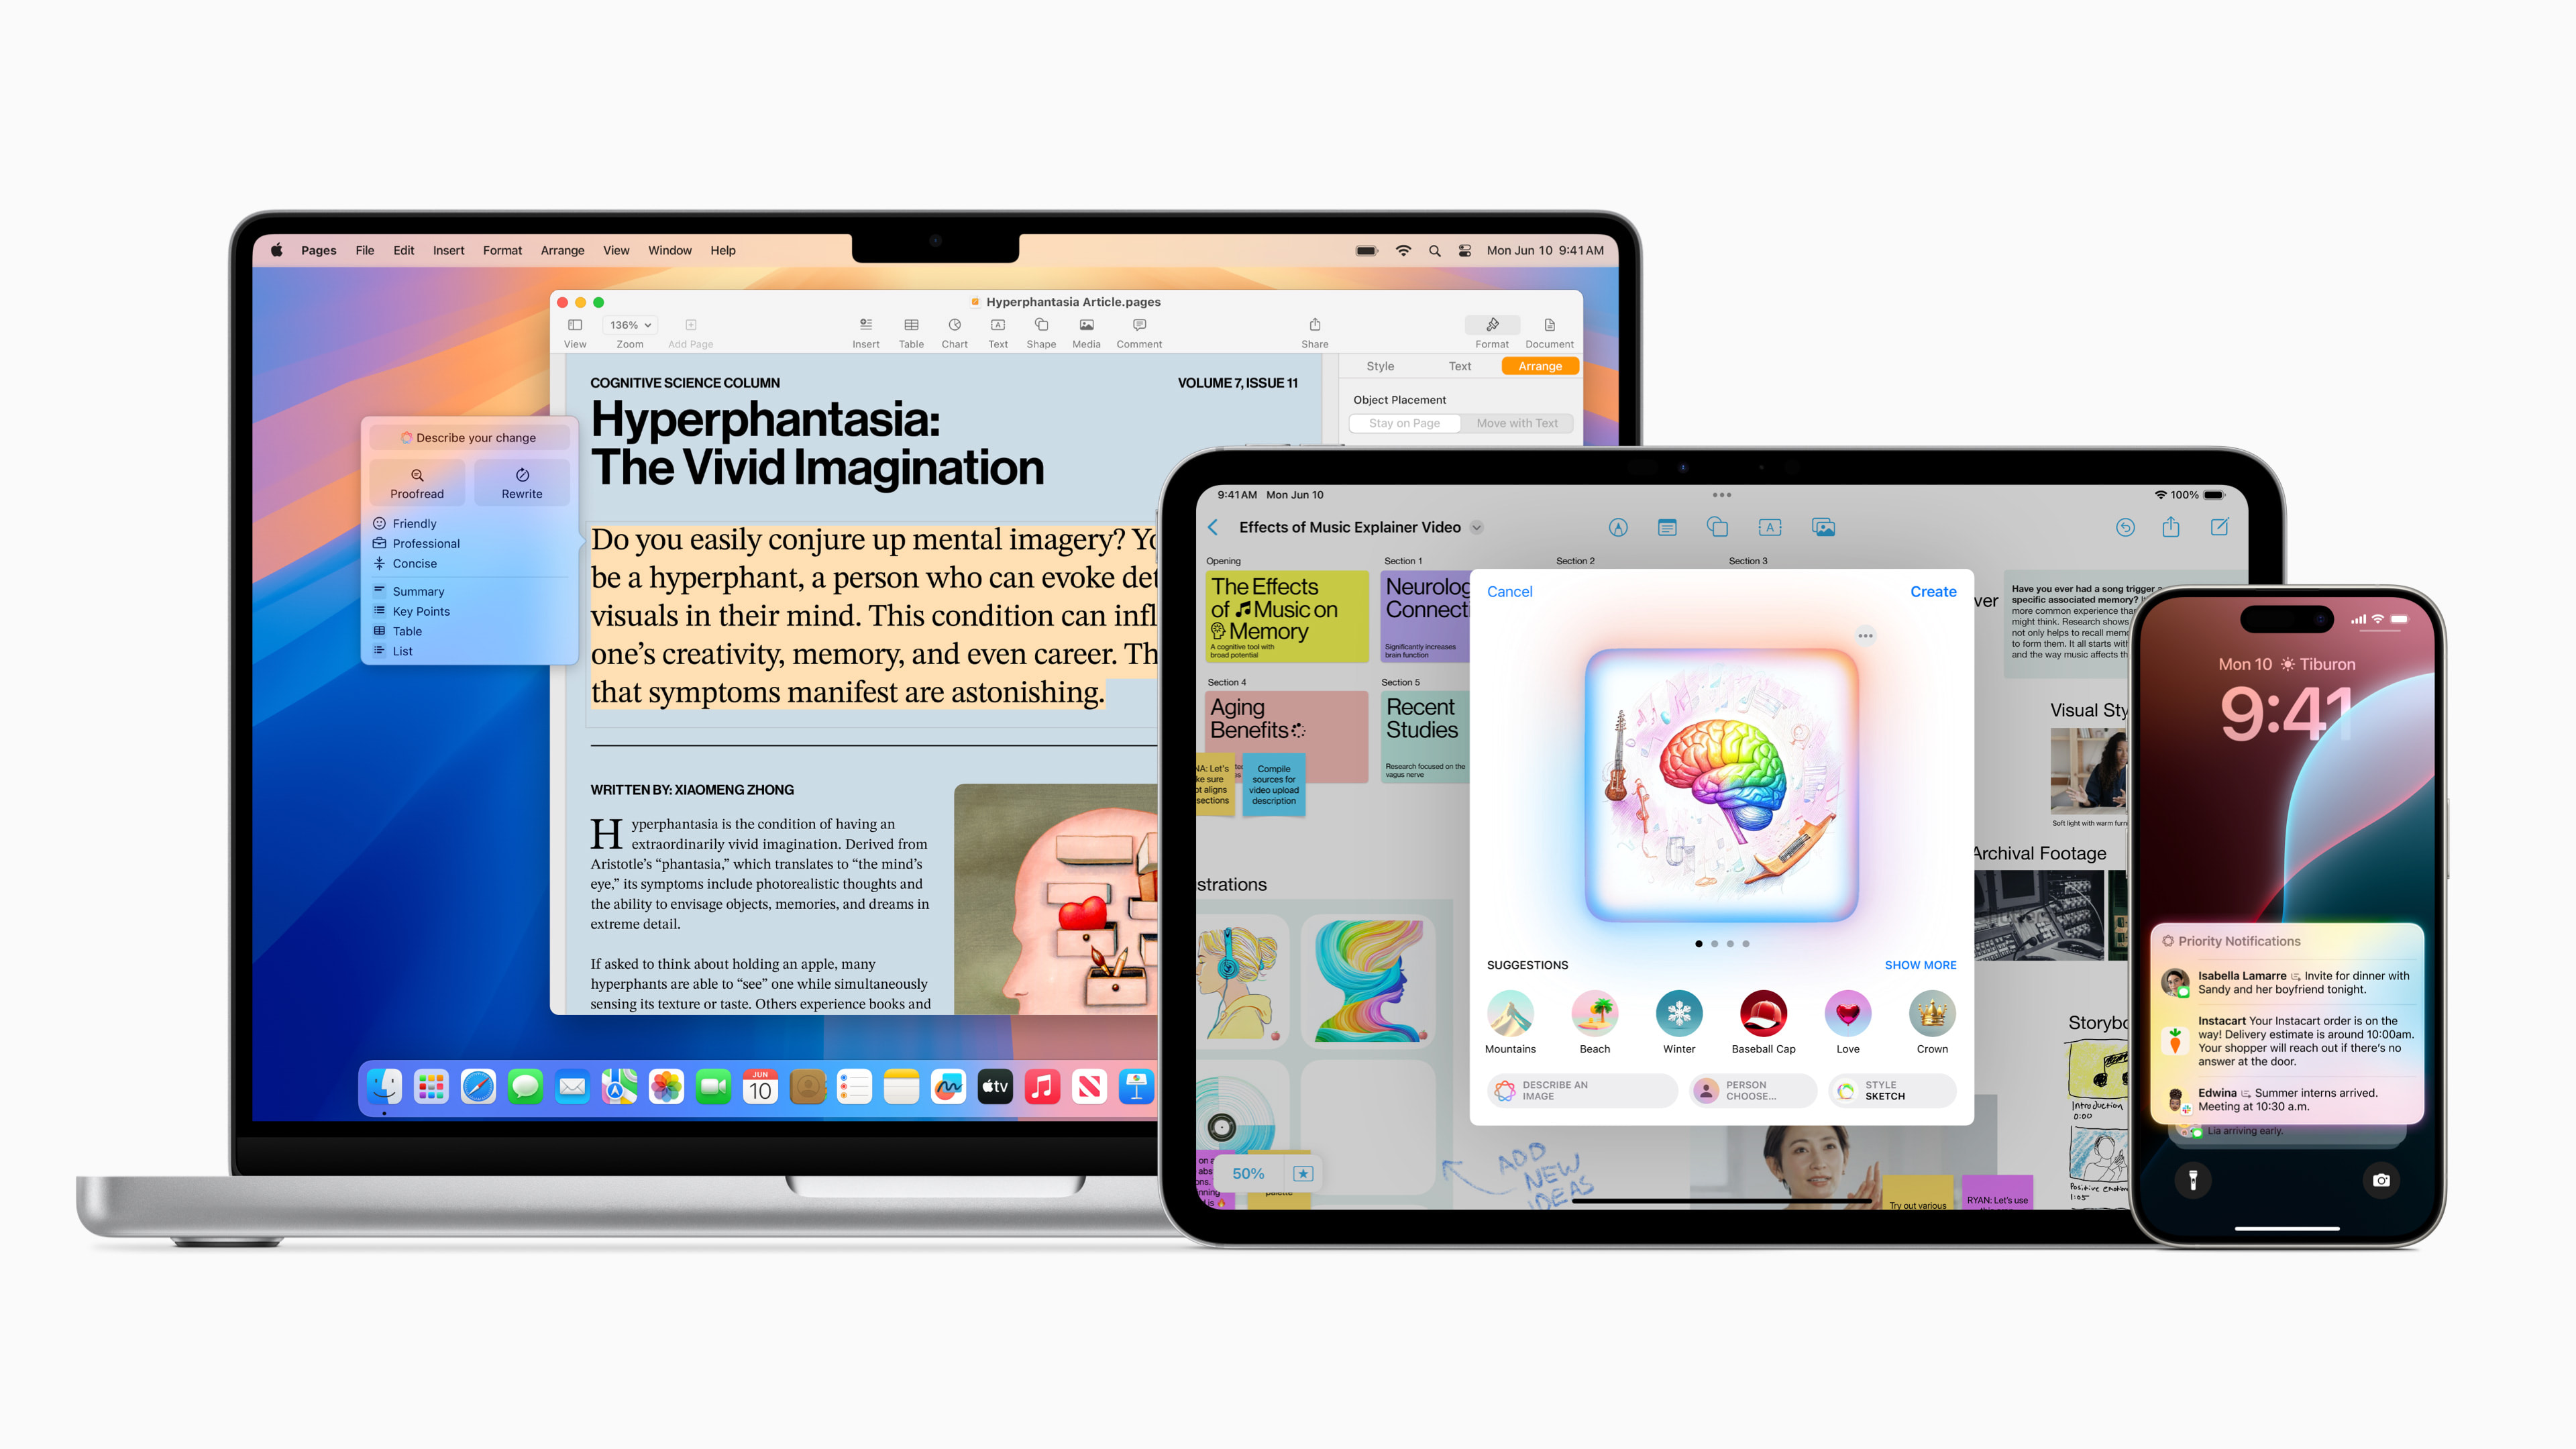
Apple bien qu'il ait confirmé avoir bien utilisé cet ensemble de sous-titres YouTube téléchargés par la startup pour entraîner ses modèles open source OpenELM, disponibles gratuitement sur Internet, il ne savait pas qu'il s'agissait de données obtenues de cette manière, et qu'il n'a-t-il pas utilisé la solution open source pour autre chose que la formation. Et depuis qu'OpenELM a été créé, selon ses propres mots, pour contribuer aux progrès de la communauté des chercheurs dans le domaine de l'IA et, plus globalement, pour faire avancer le développement d'un grand modèle de langage open source, l'utilisation de données de formation dont l’origine n’a pas été entièrement vérifiée est quelque peu pardonnable.
Galerie photo
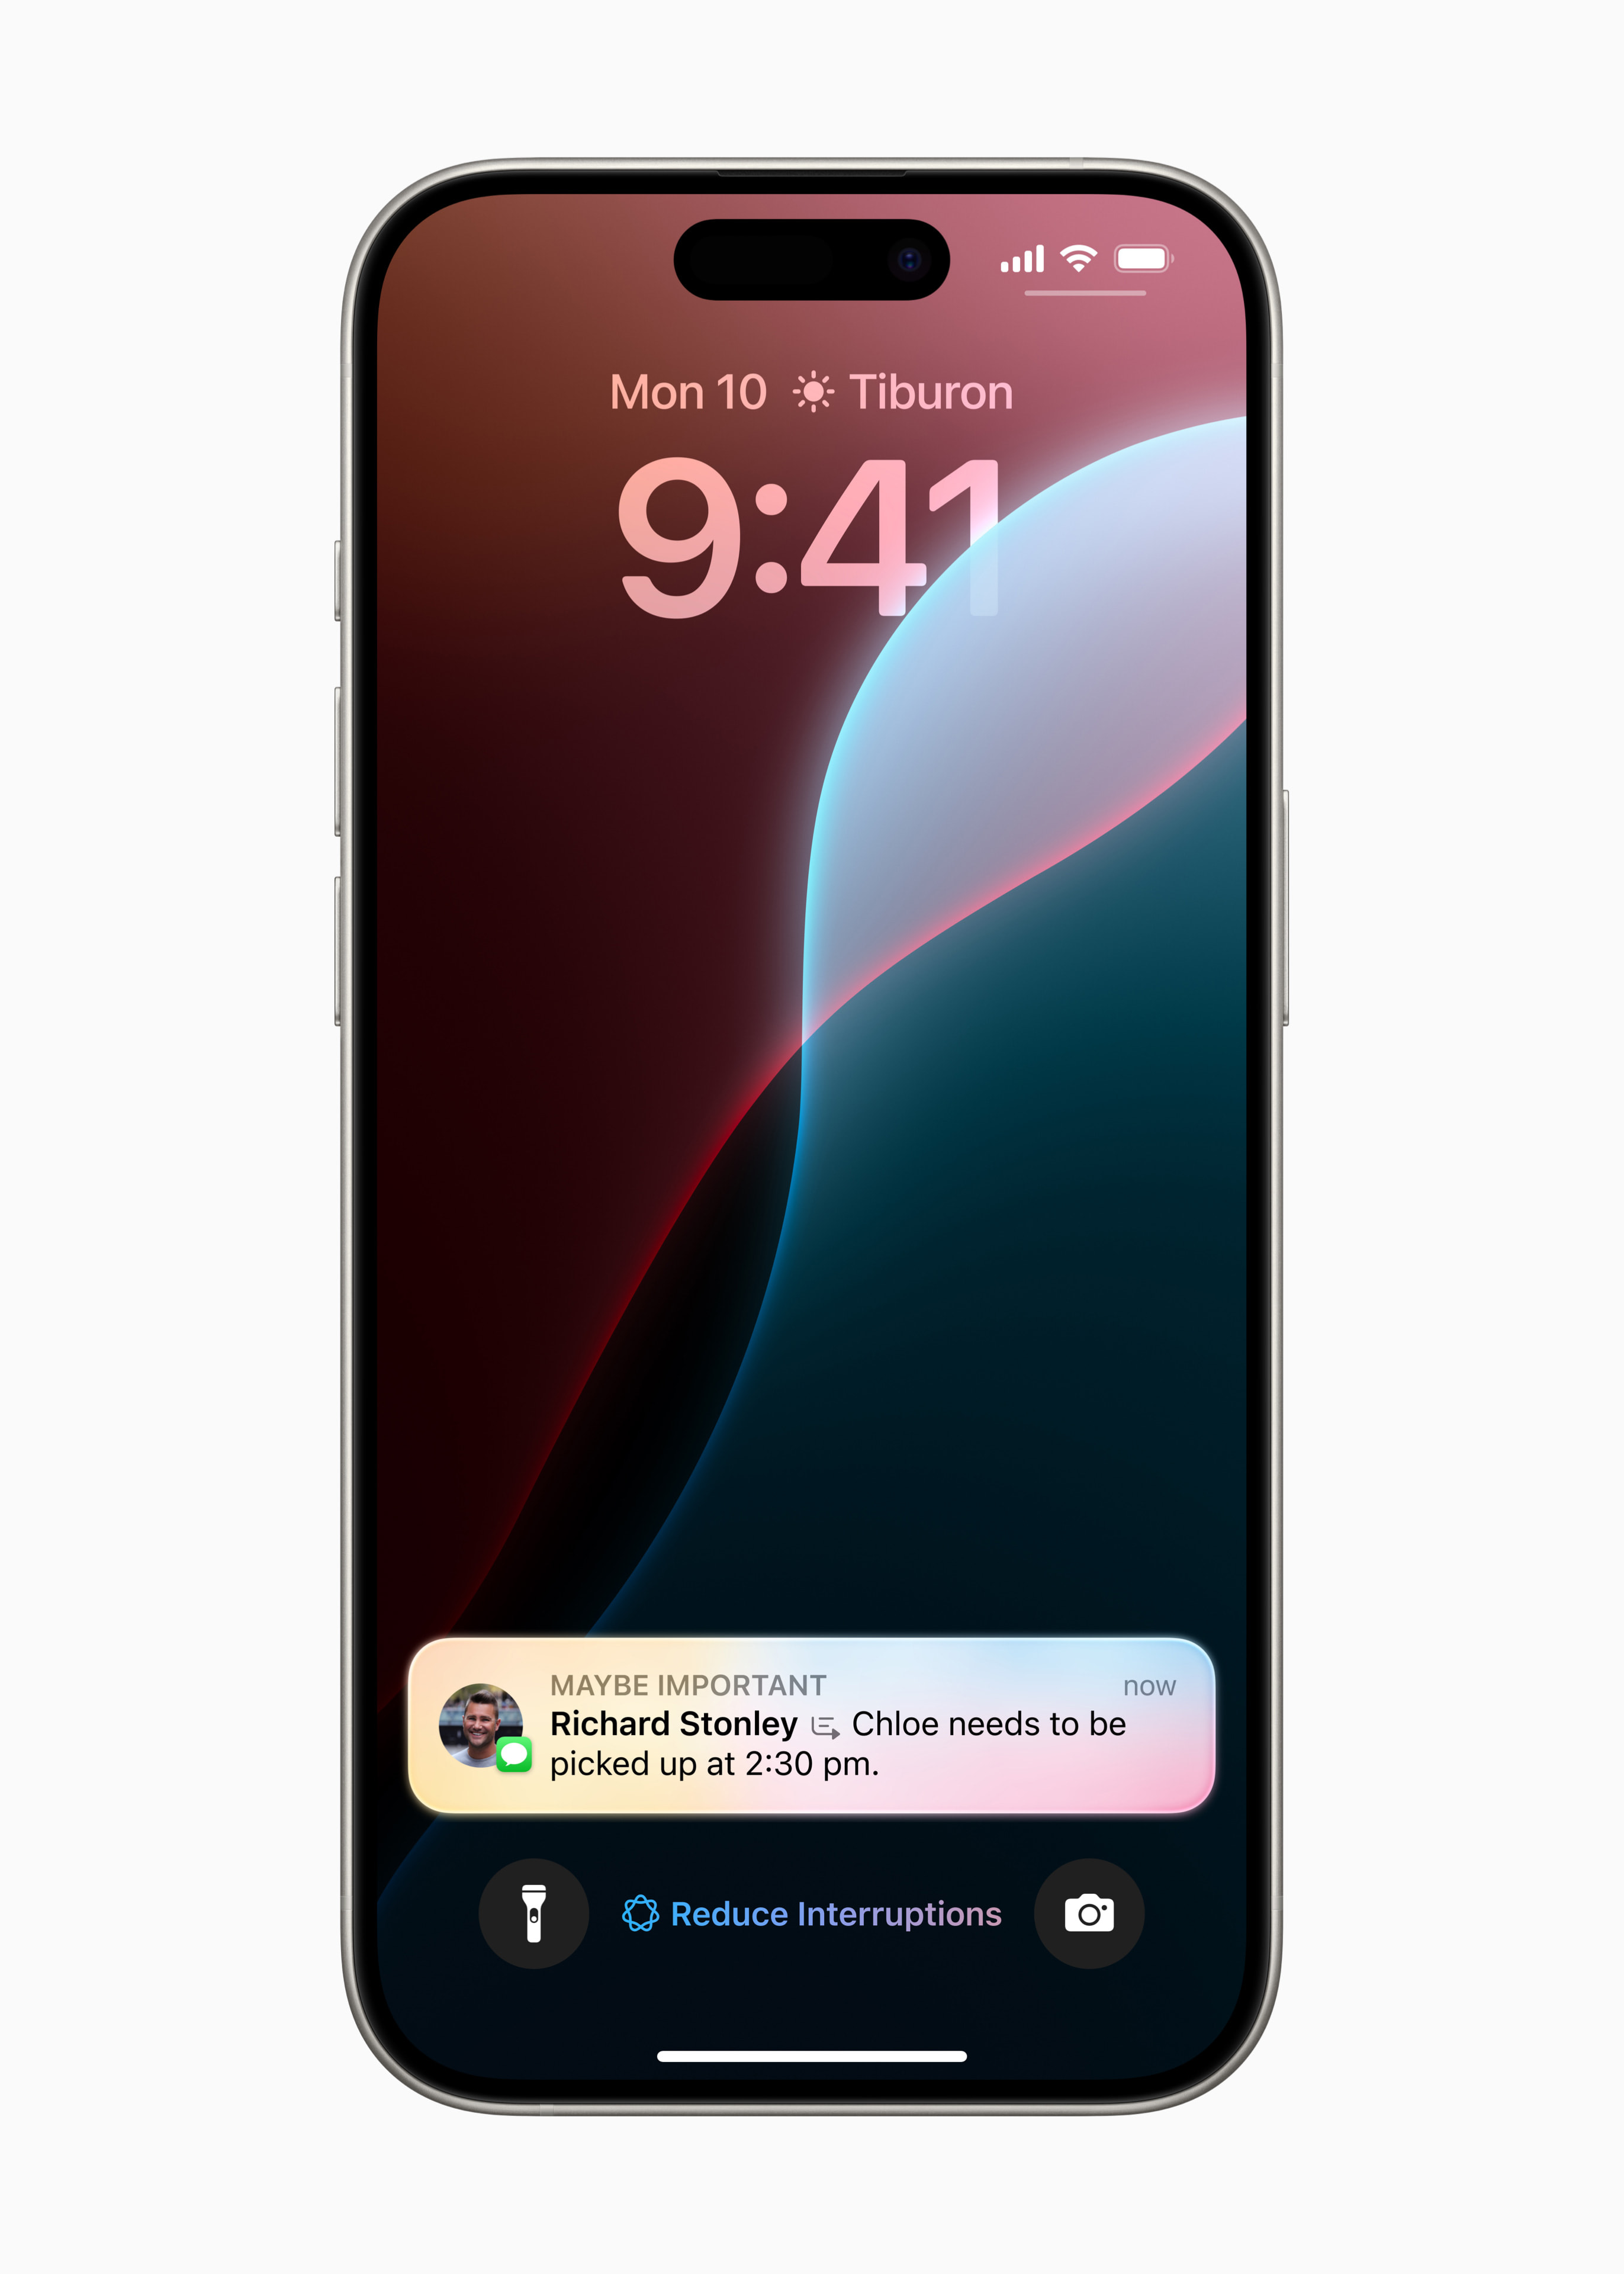
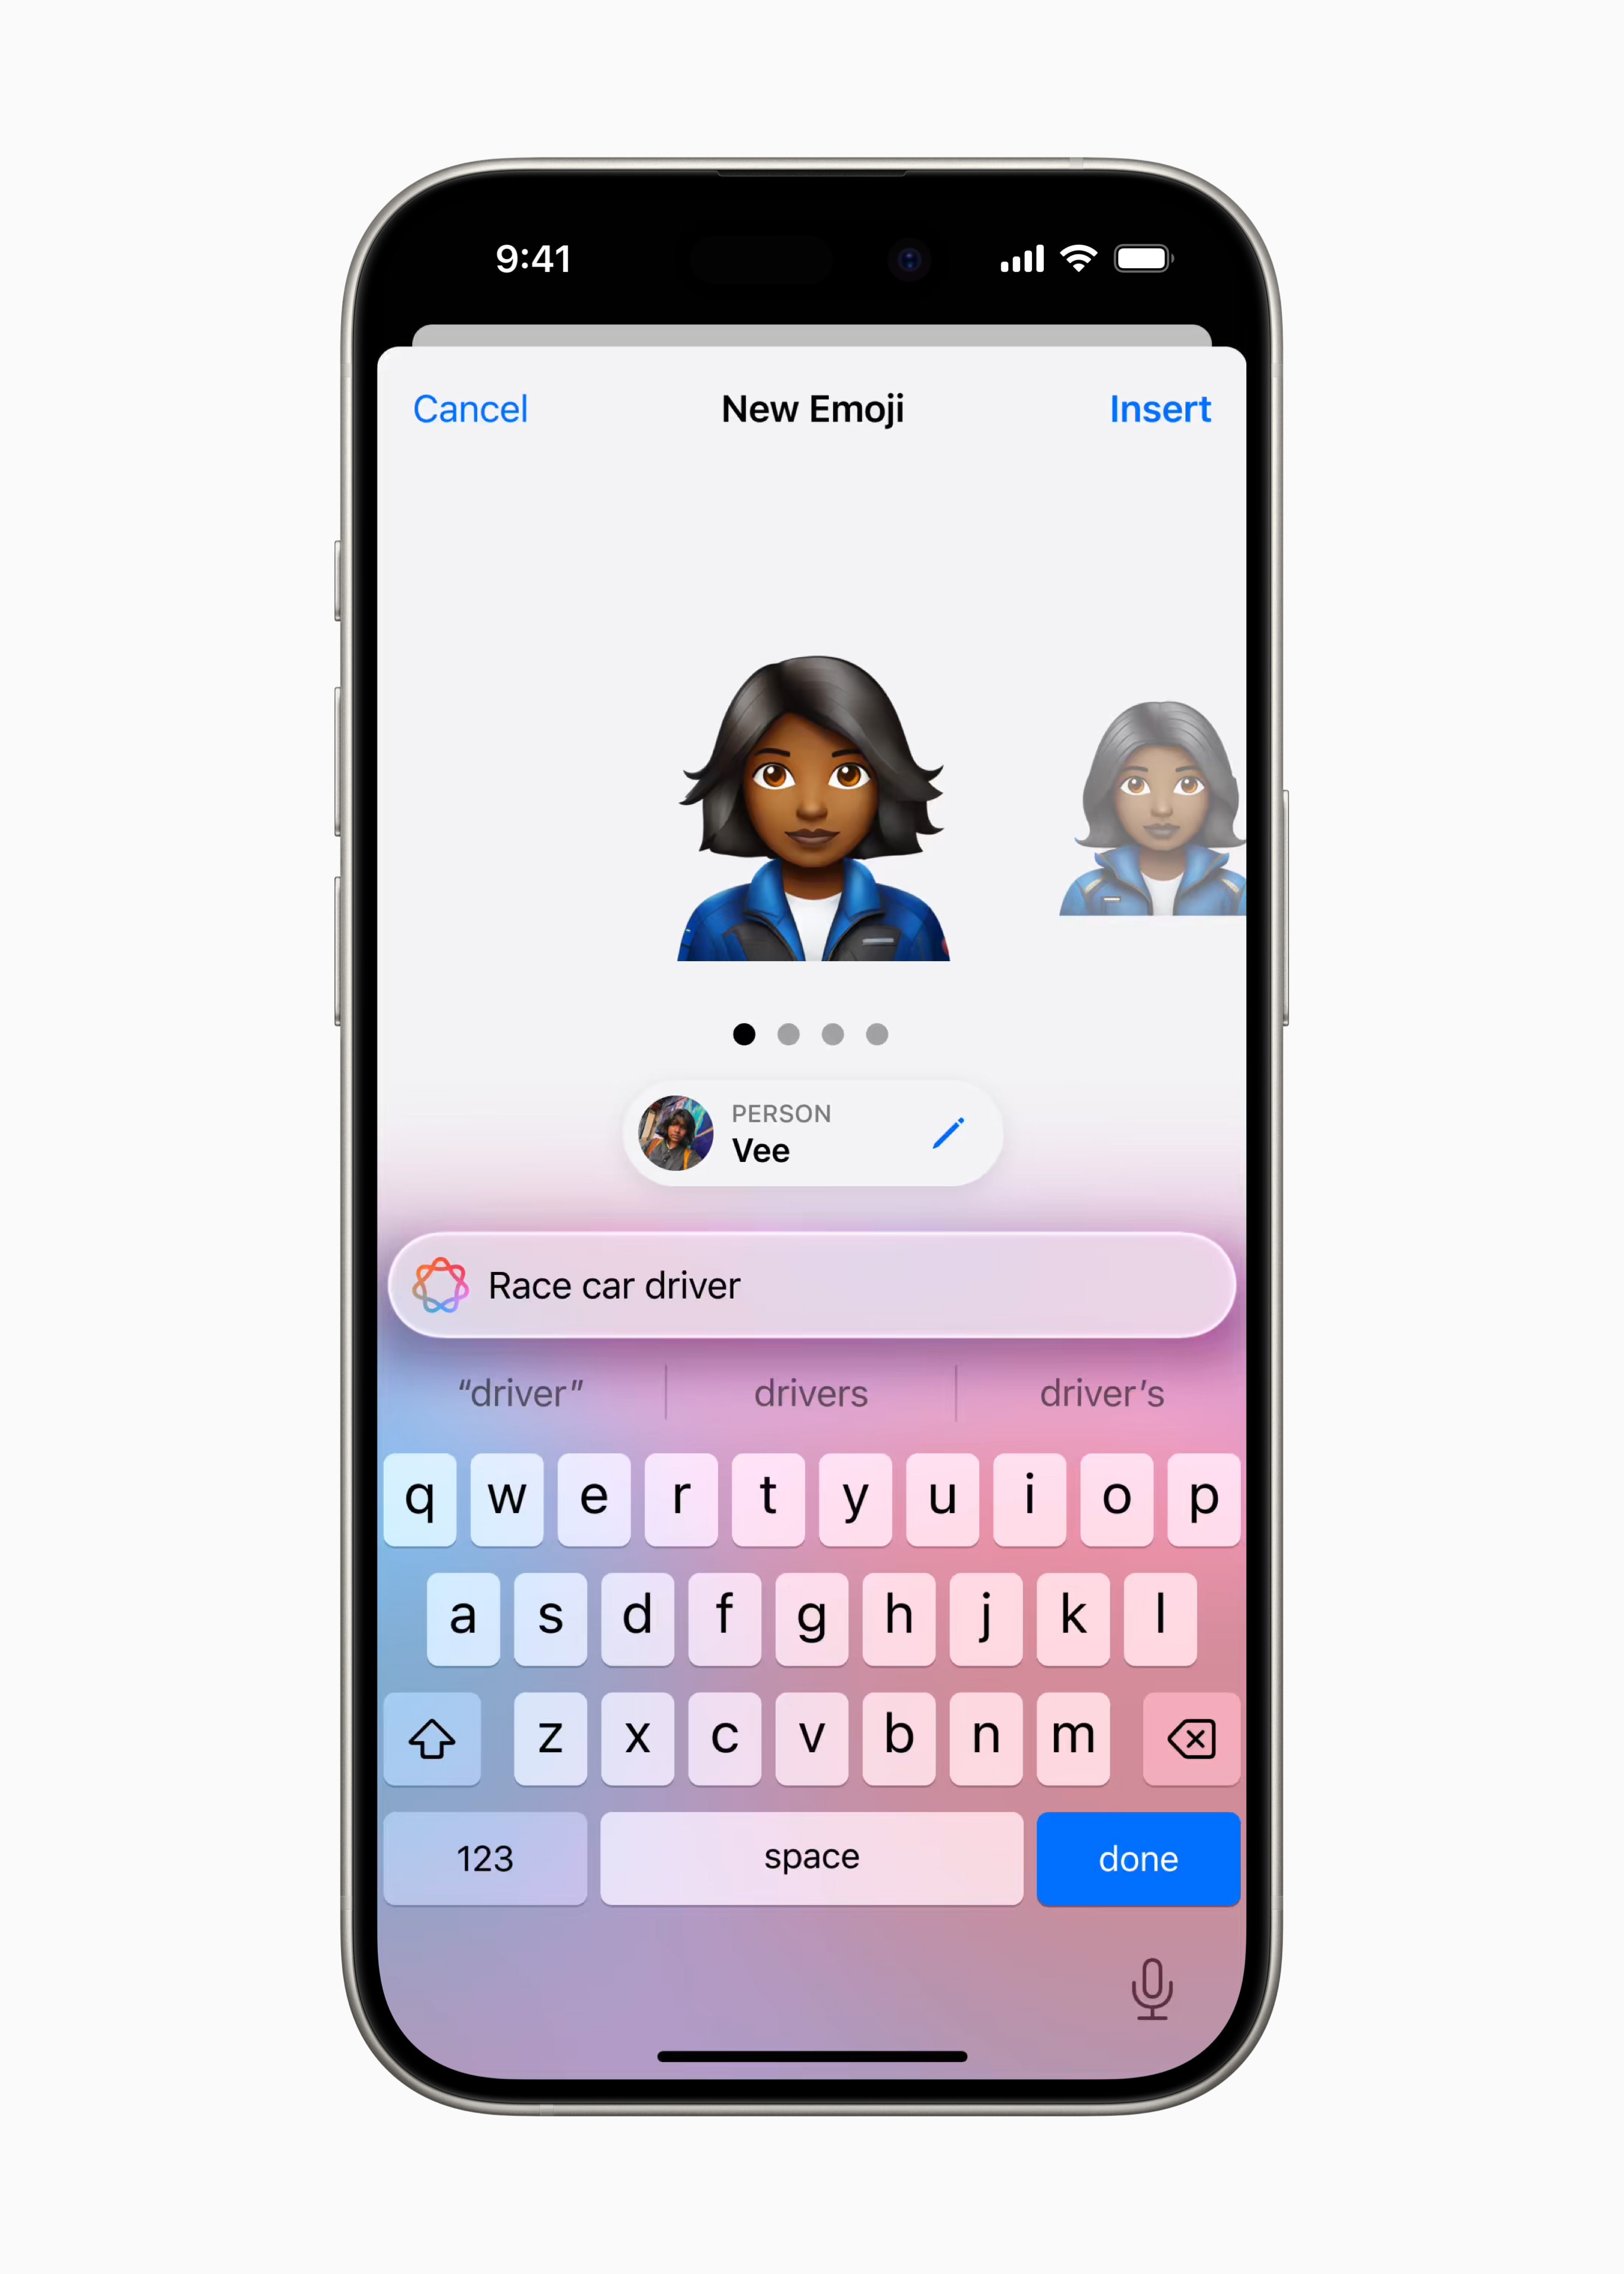
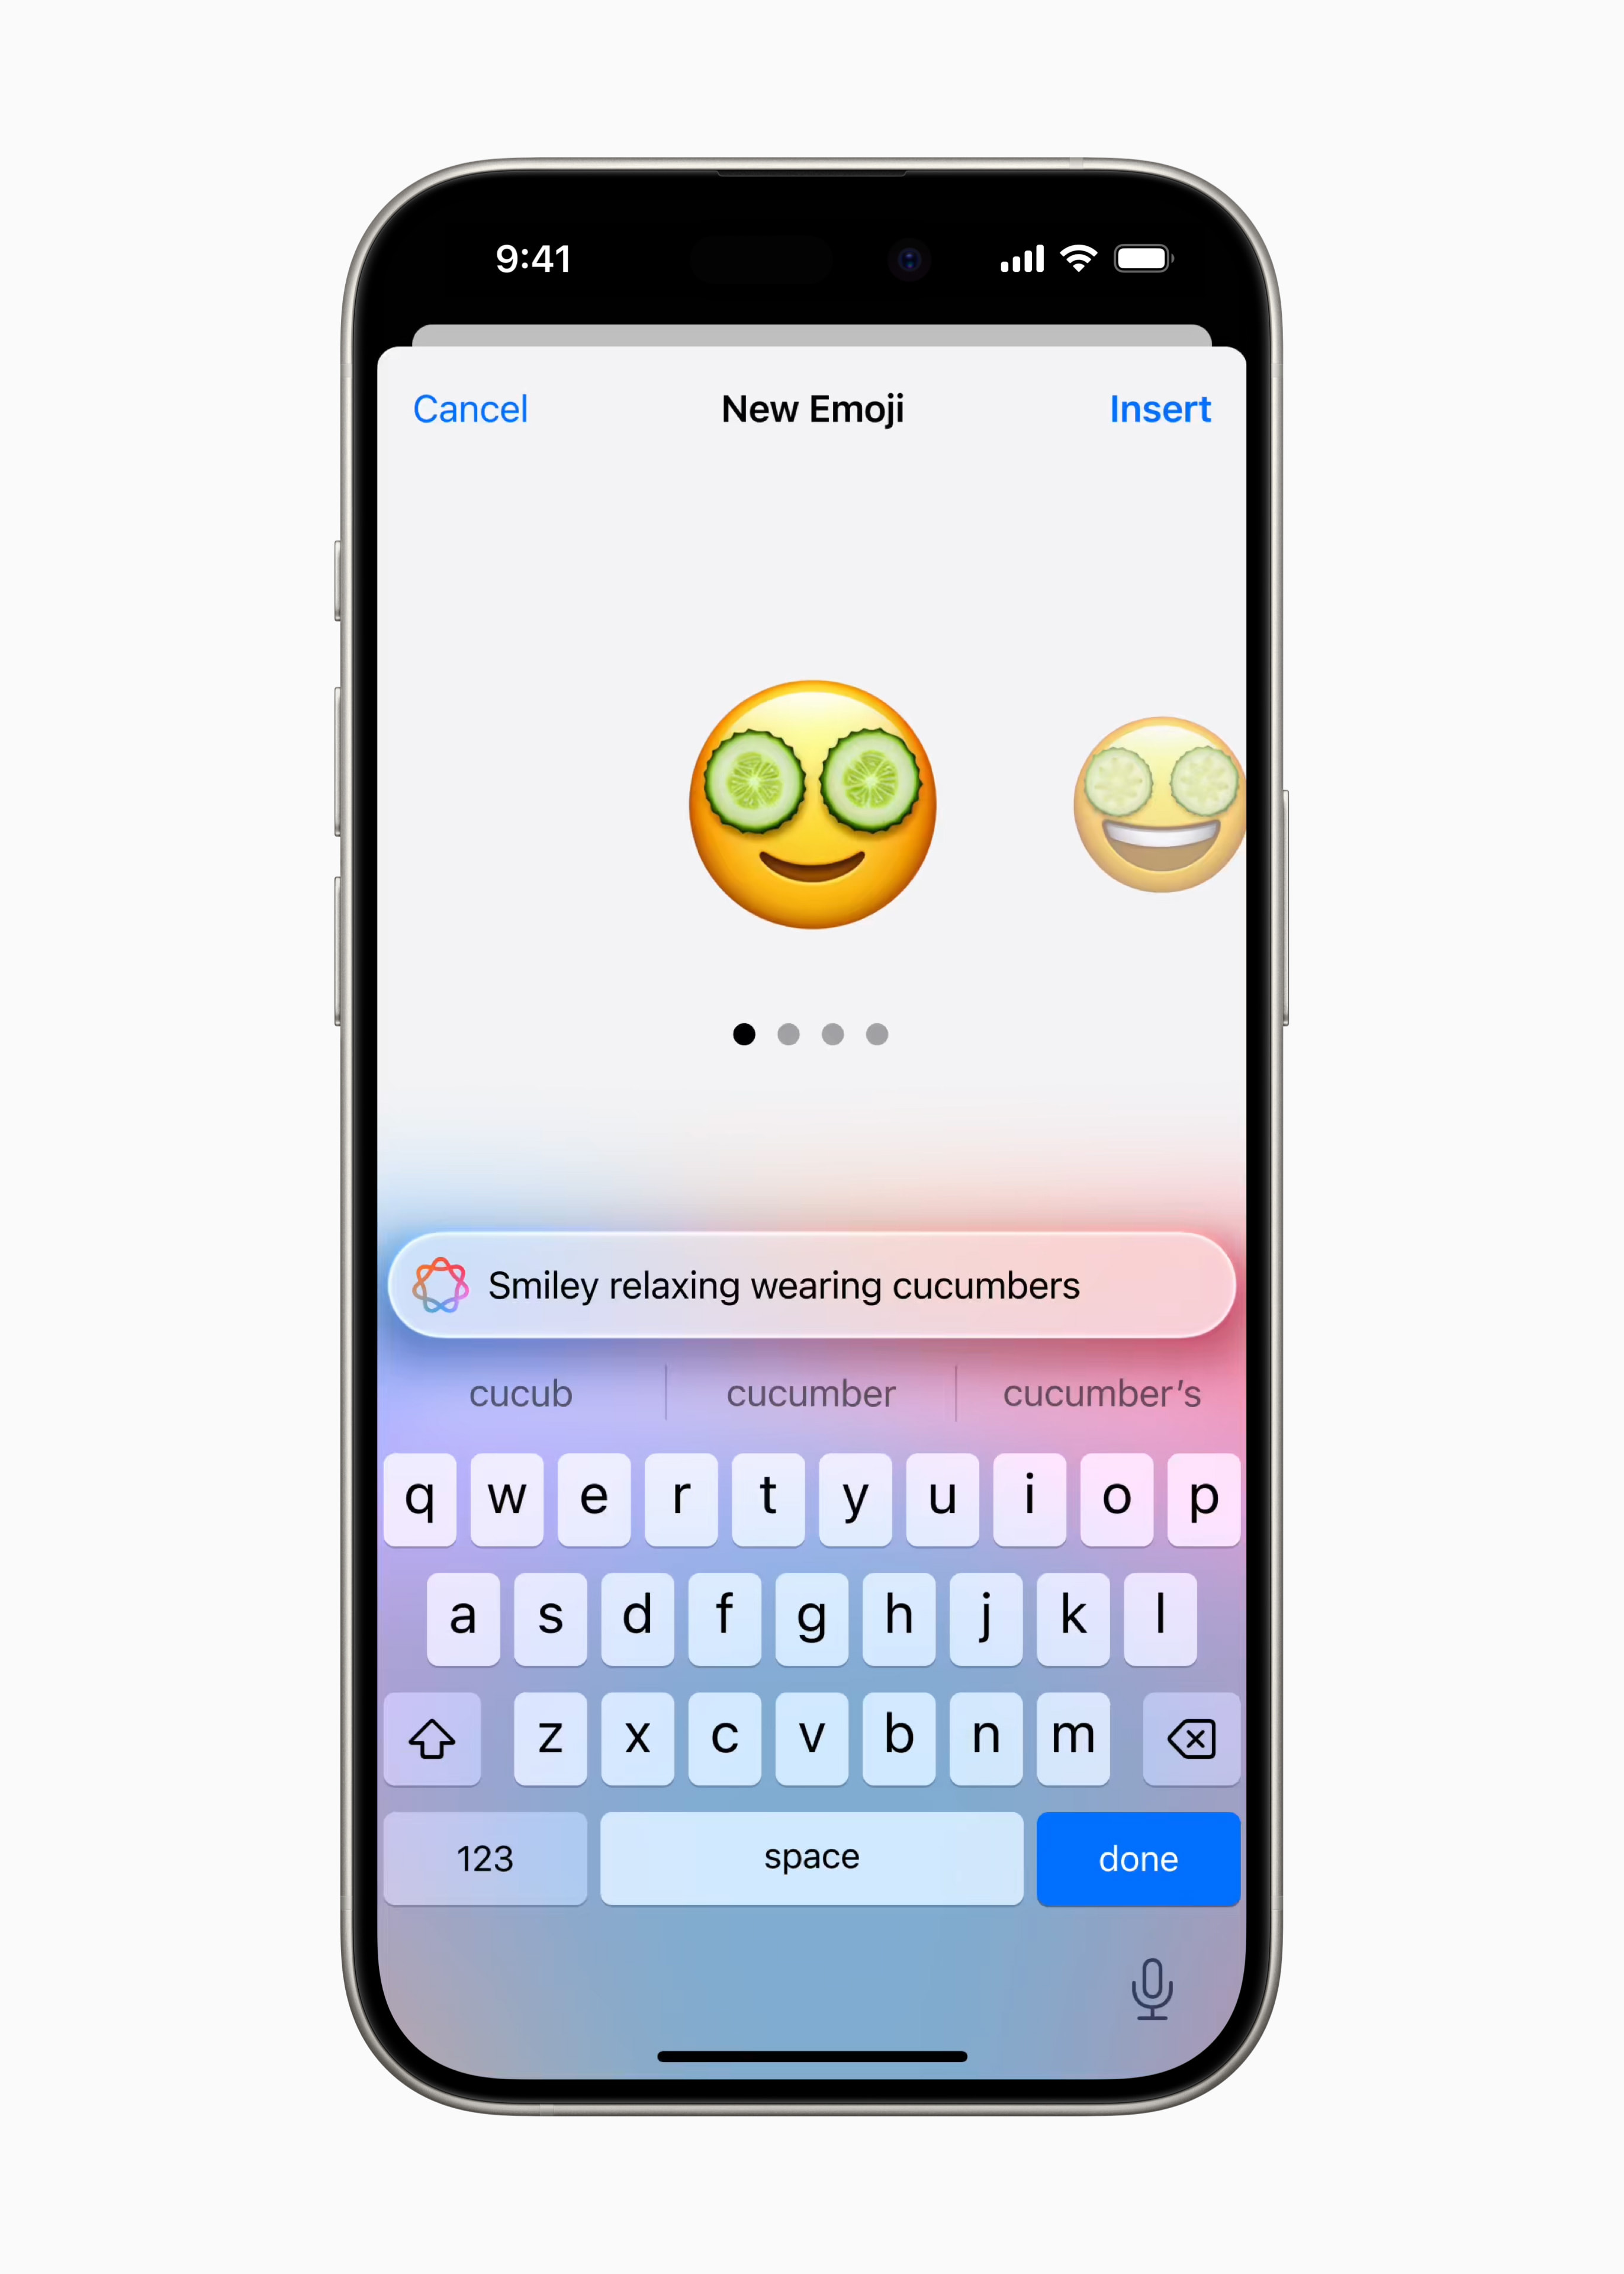
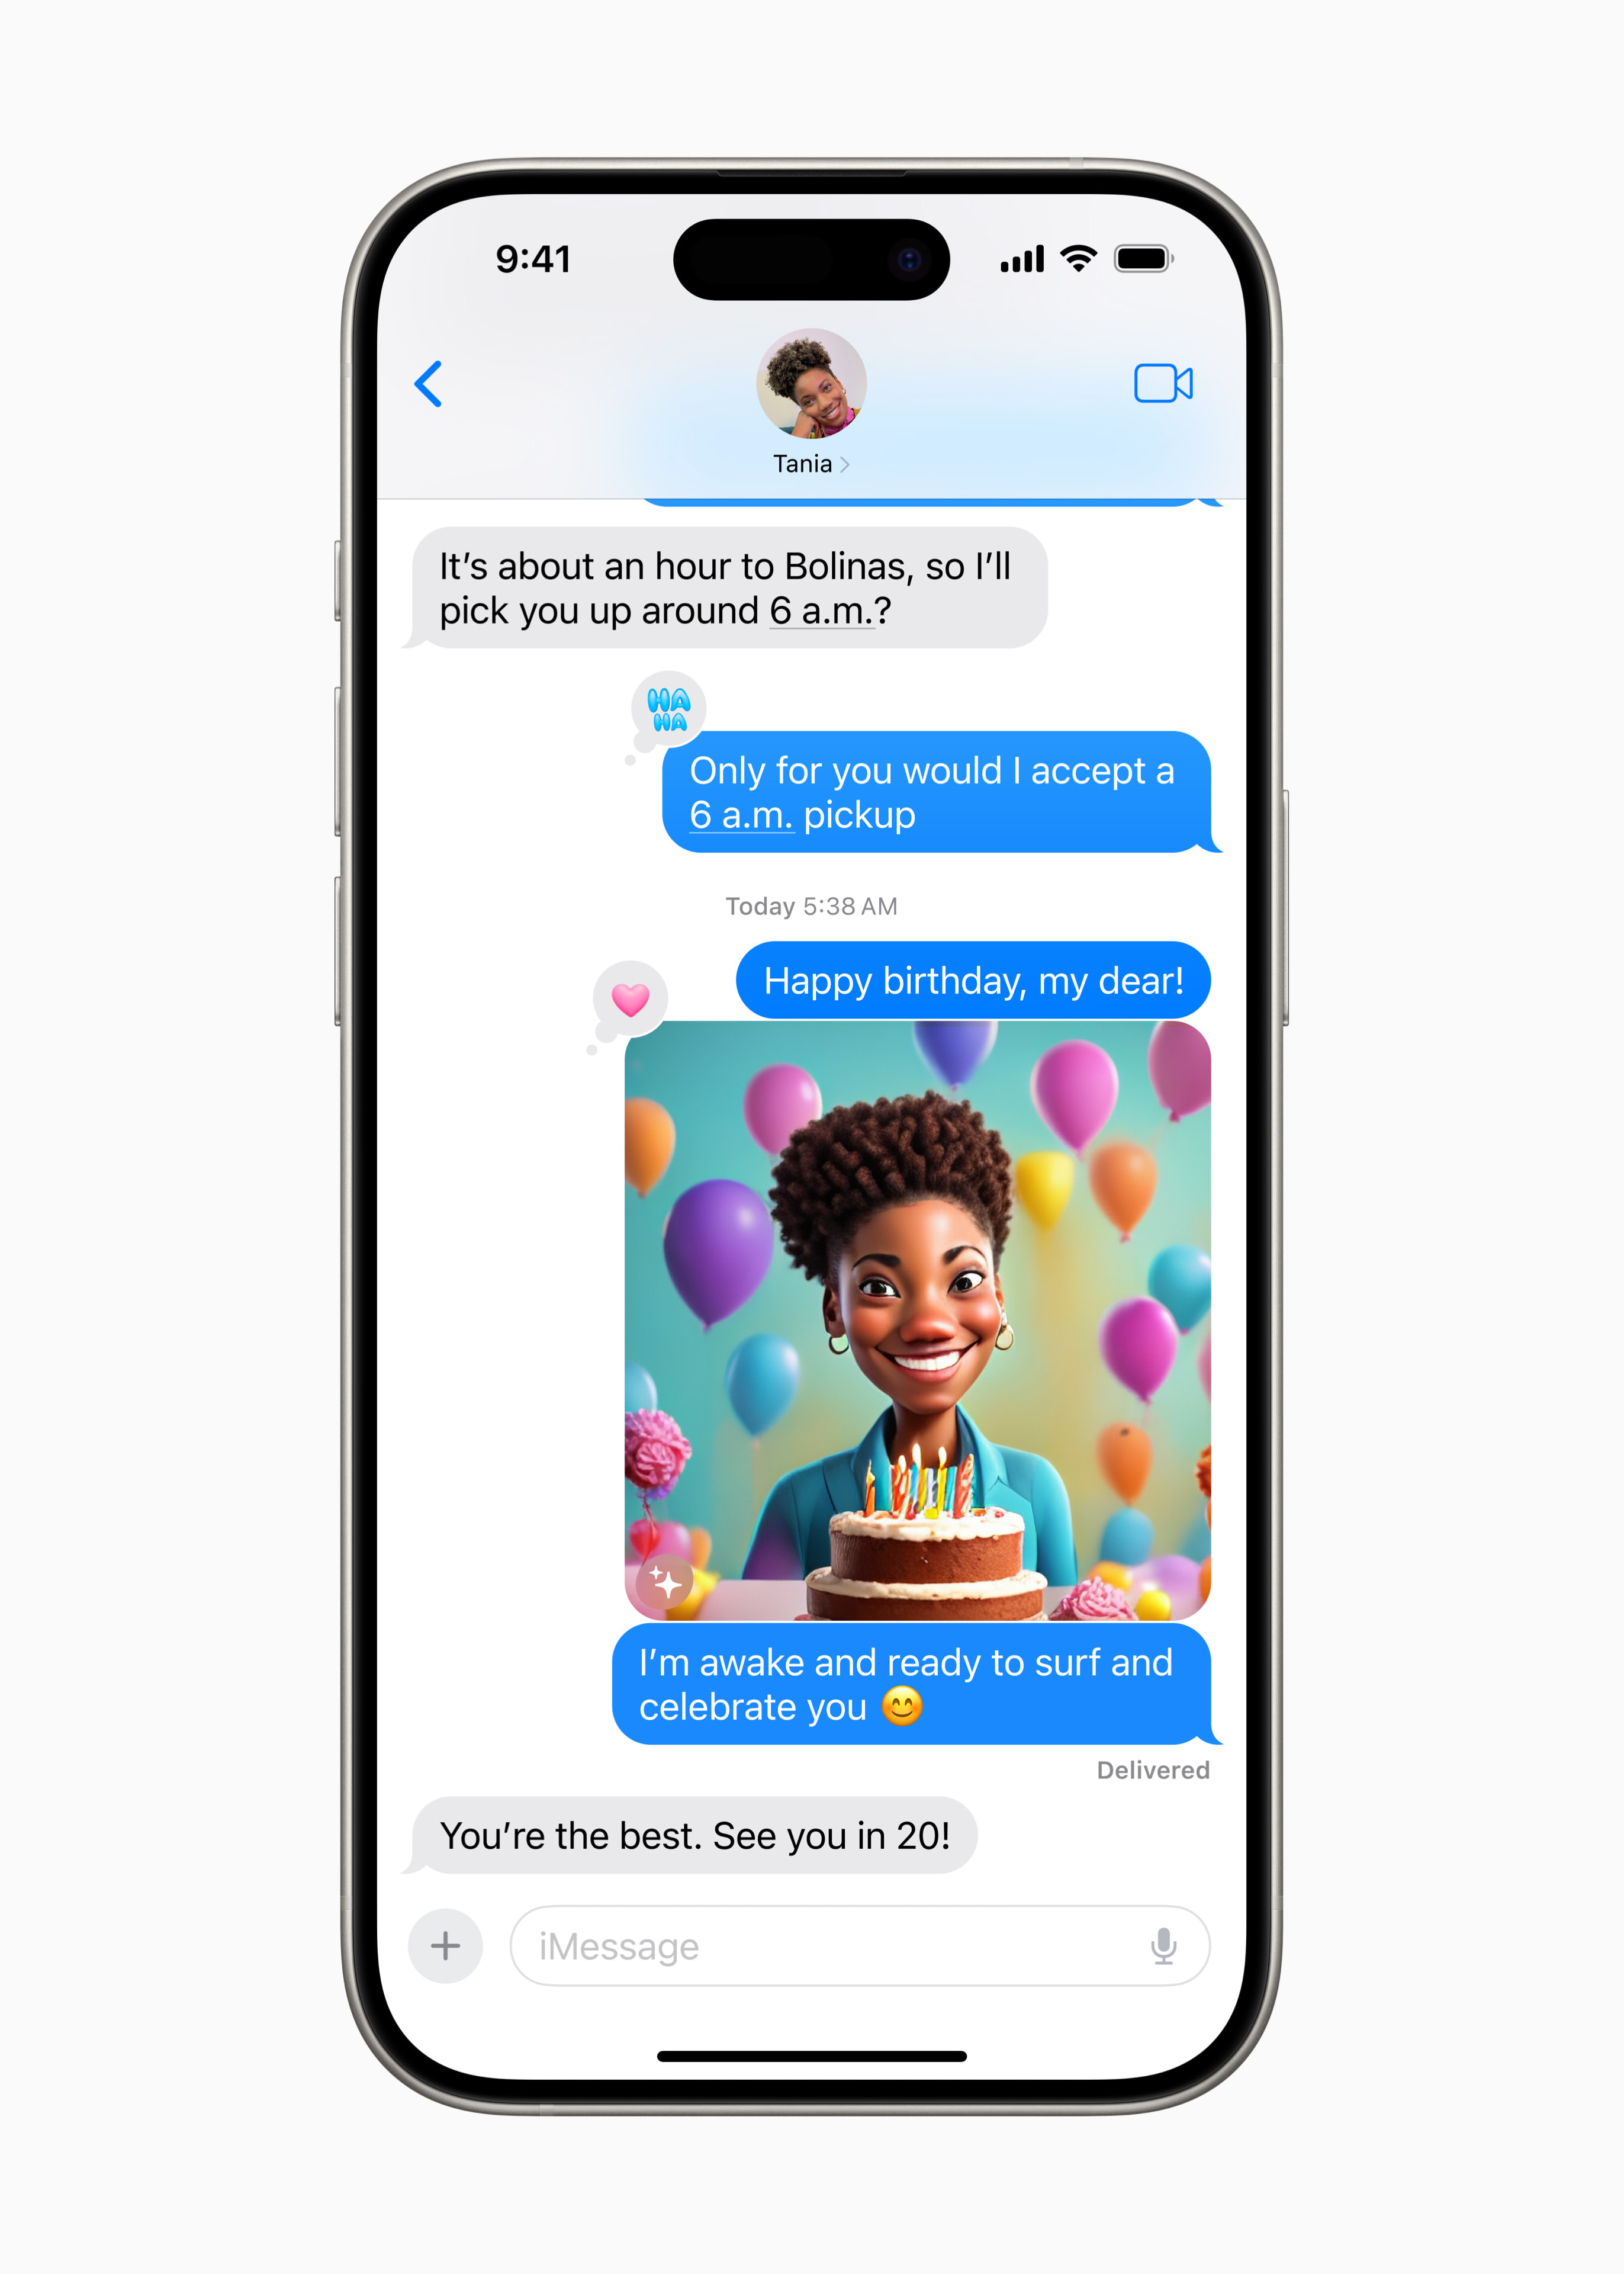
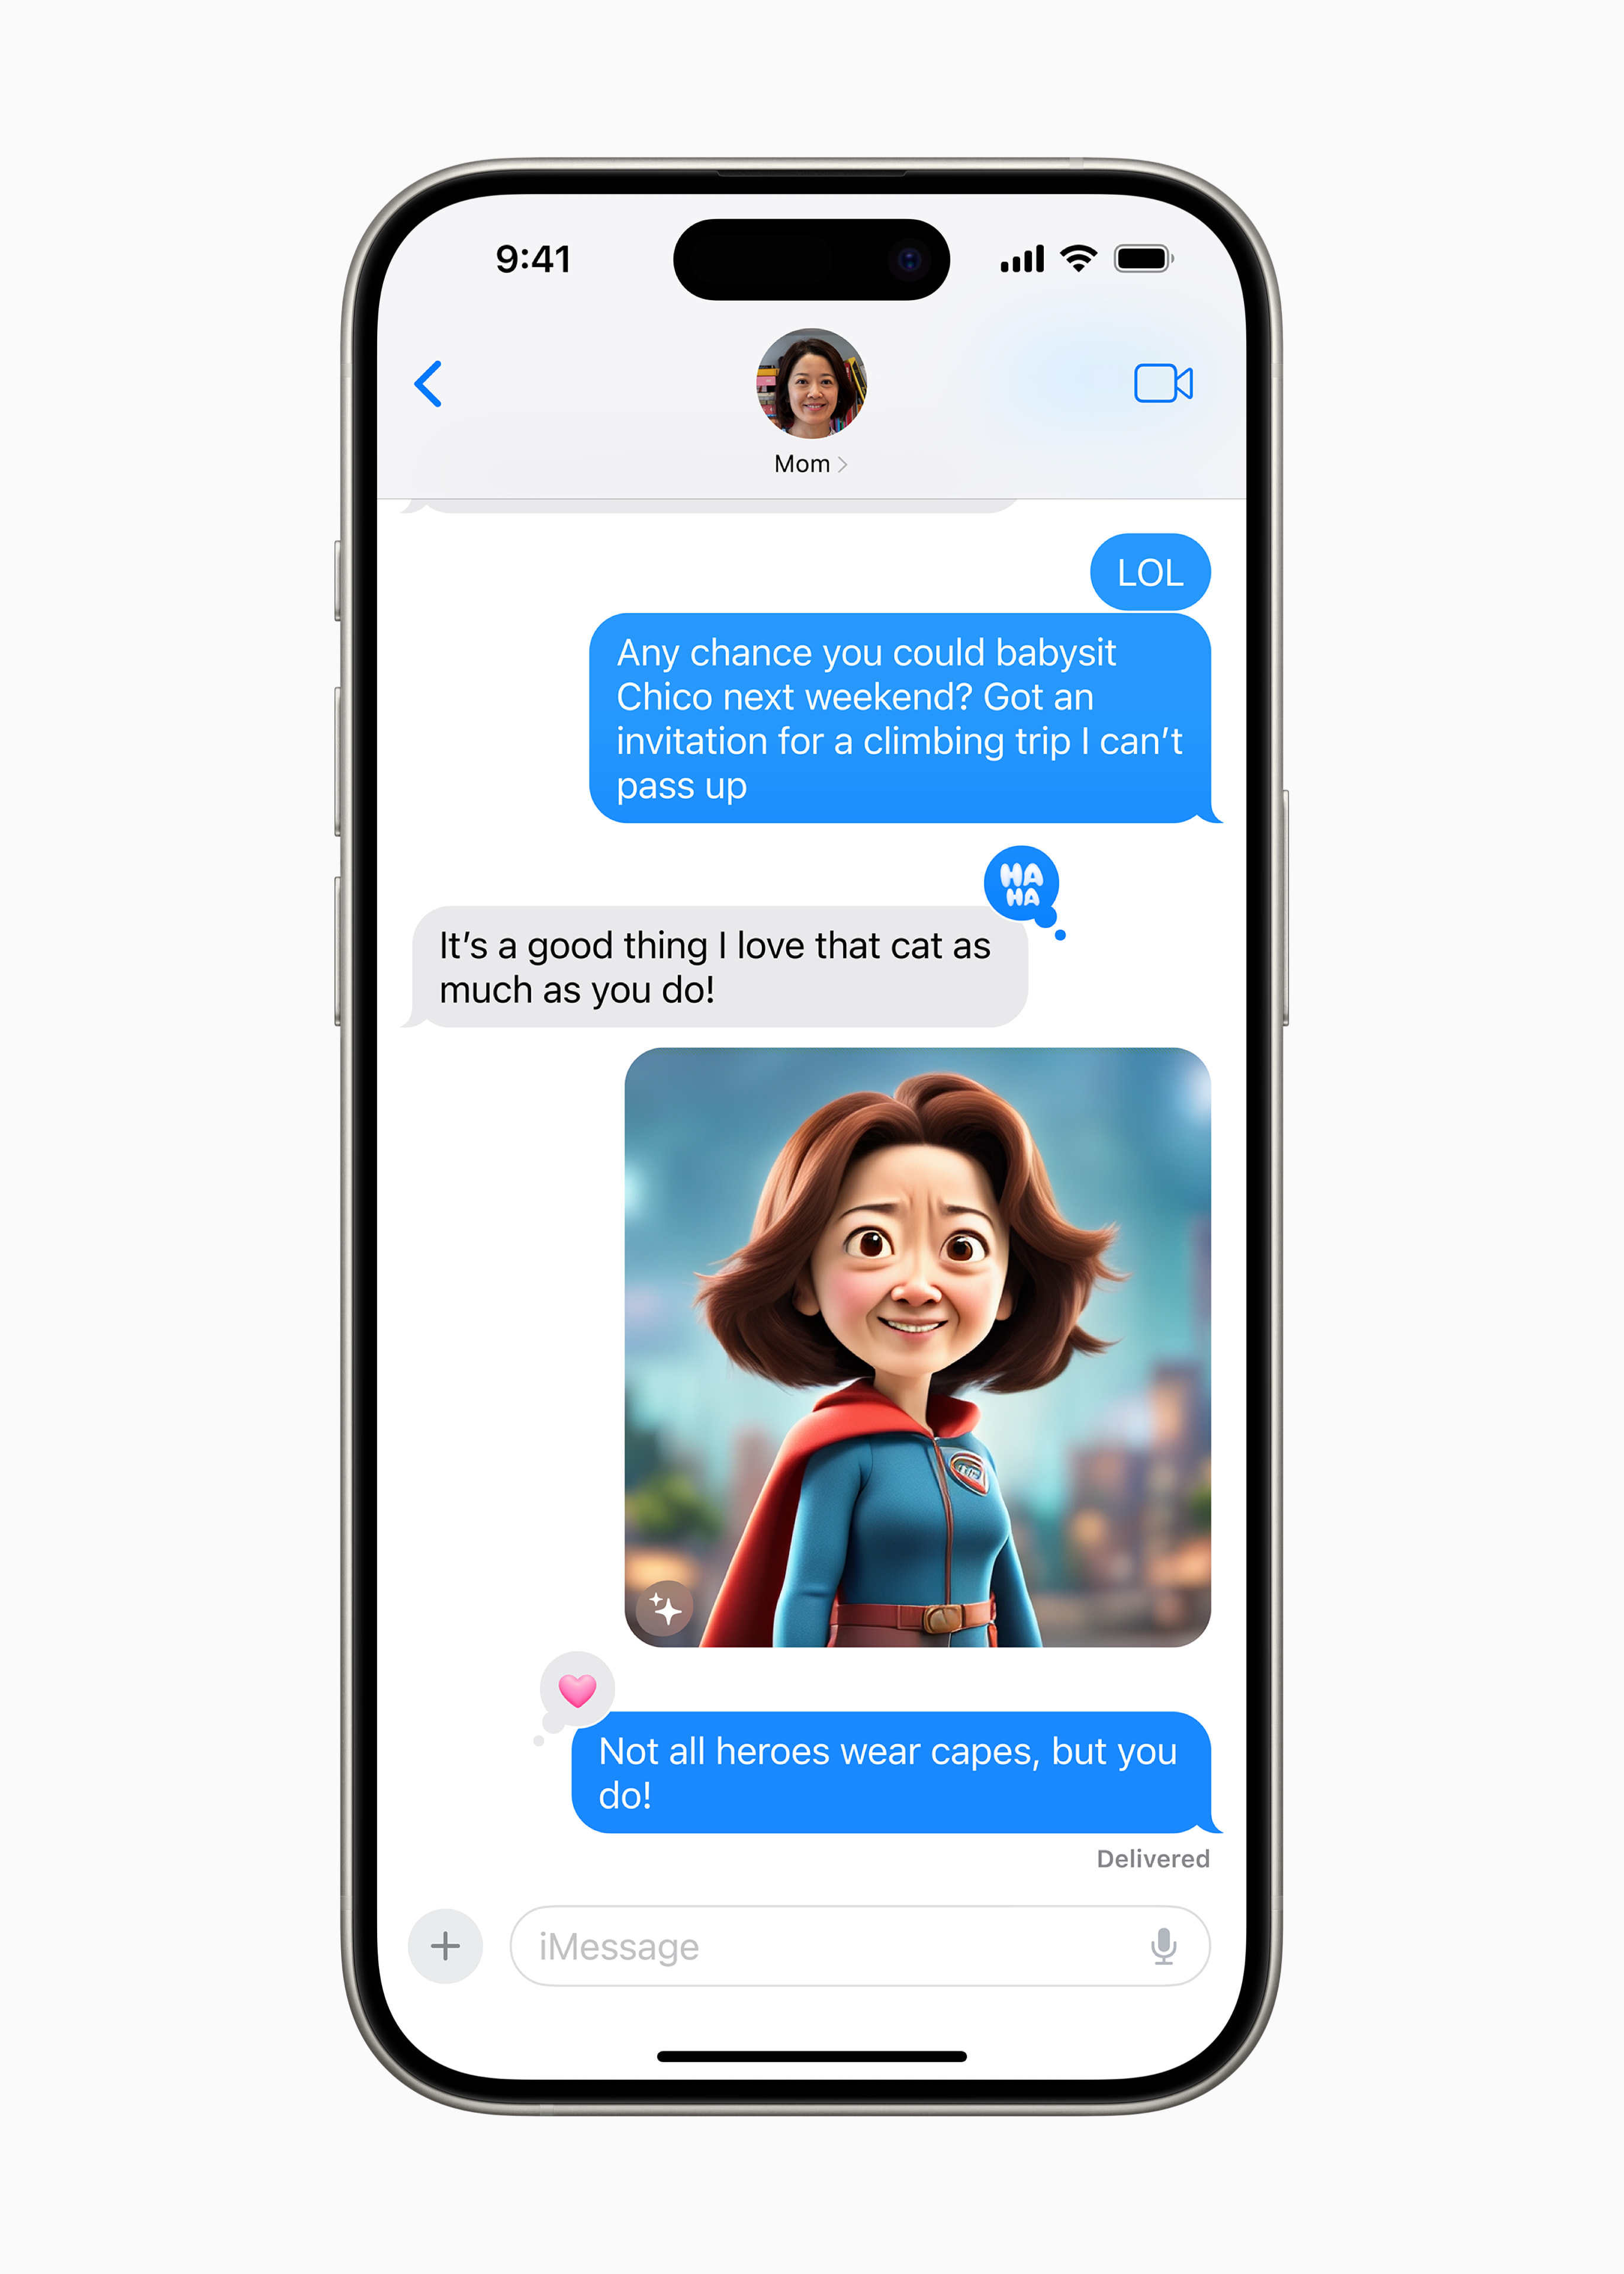
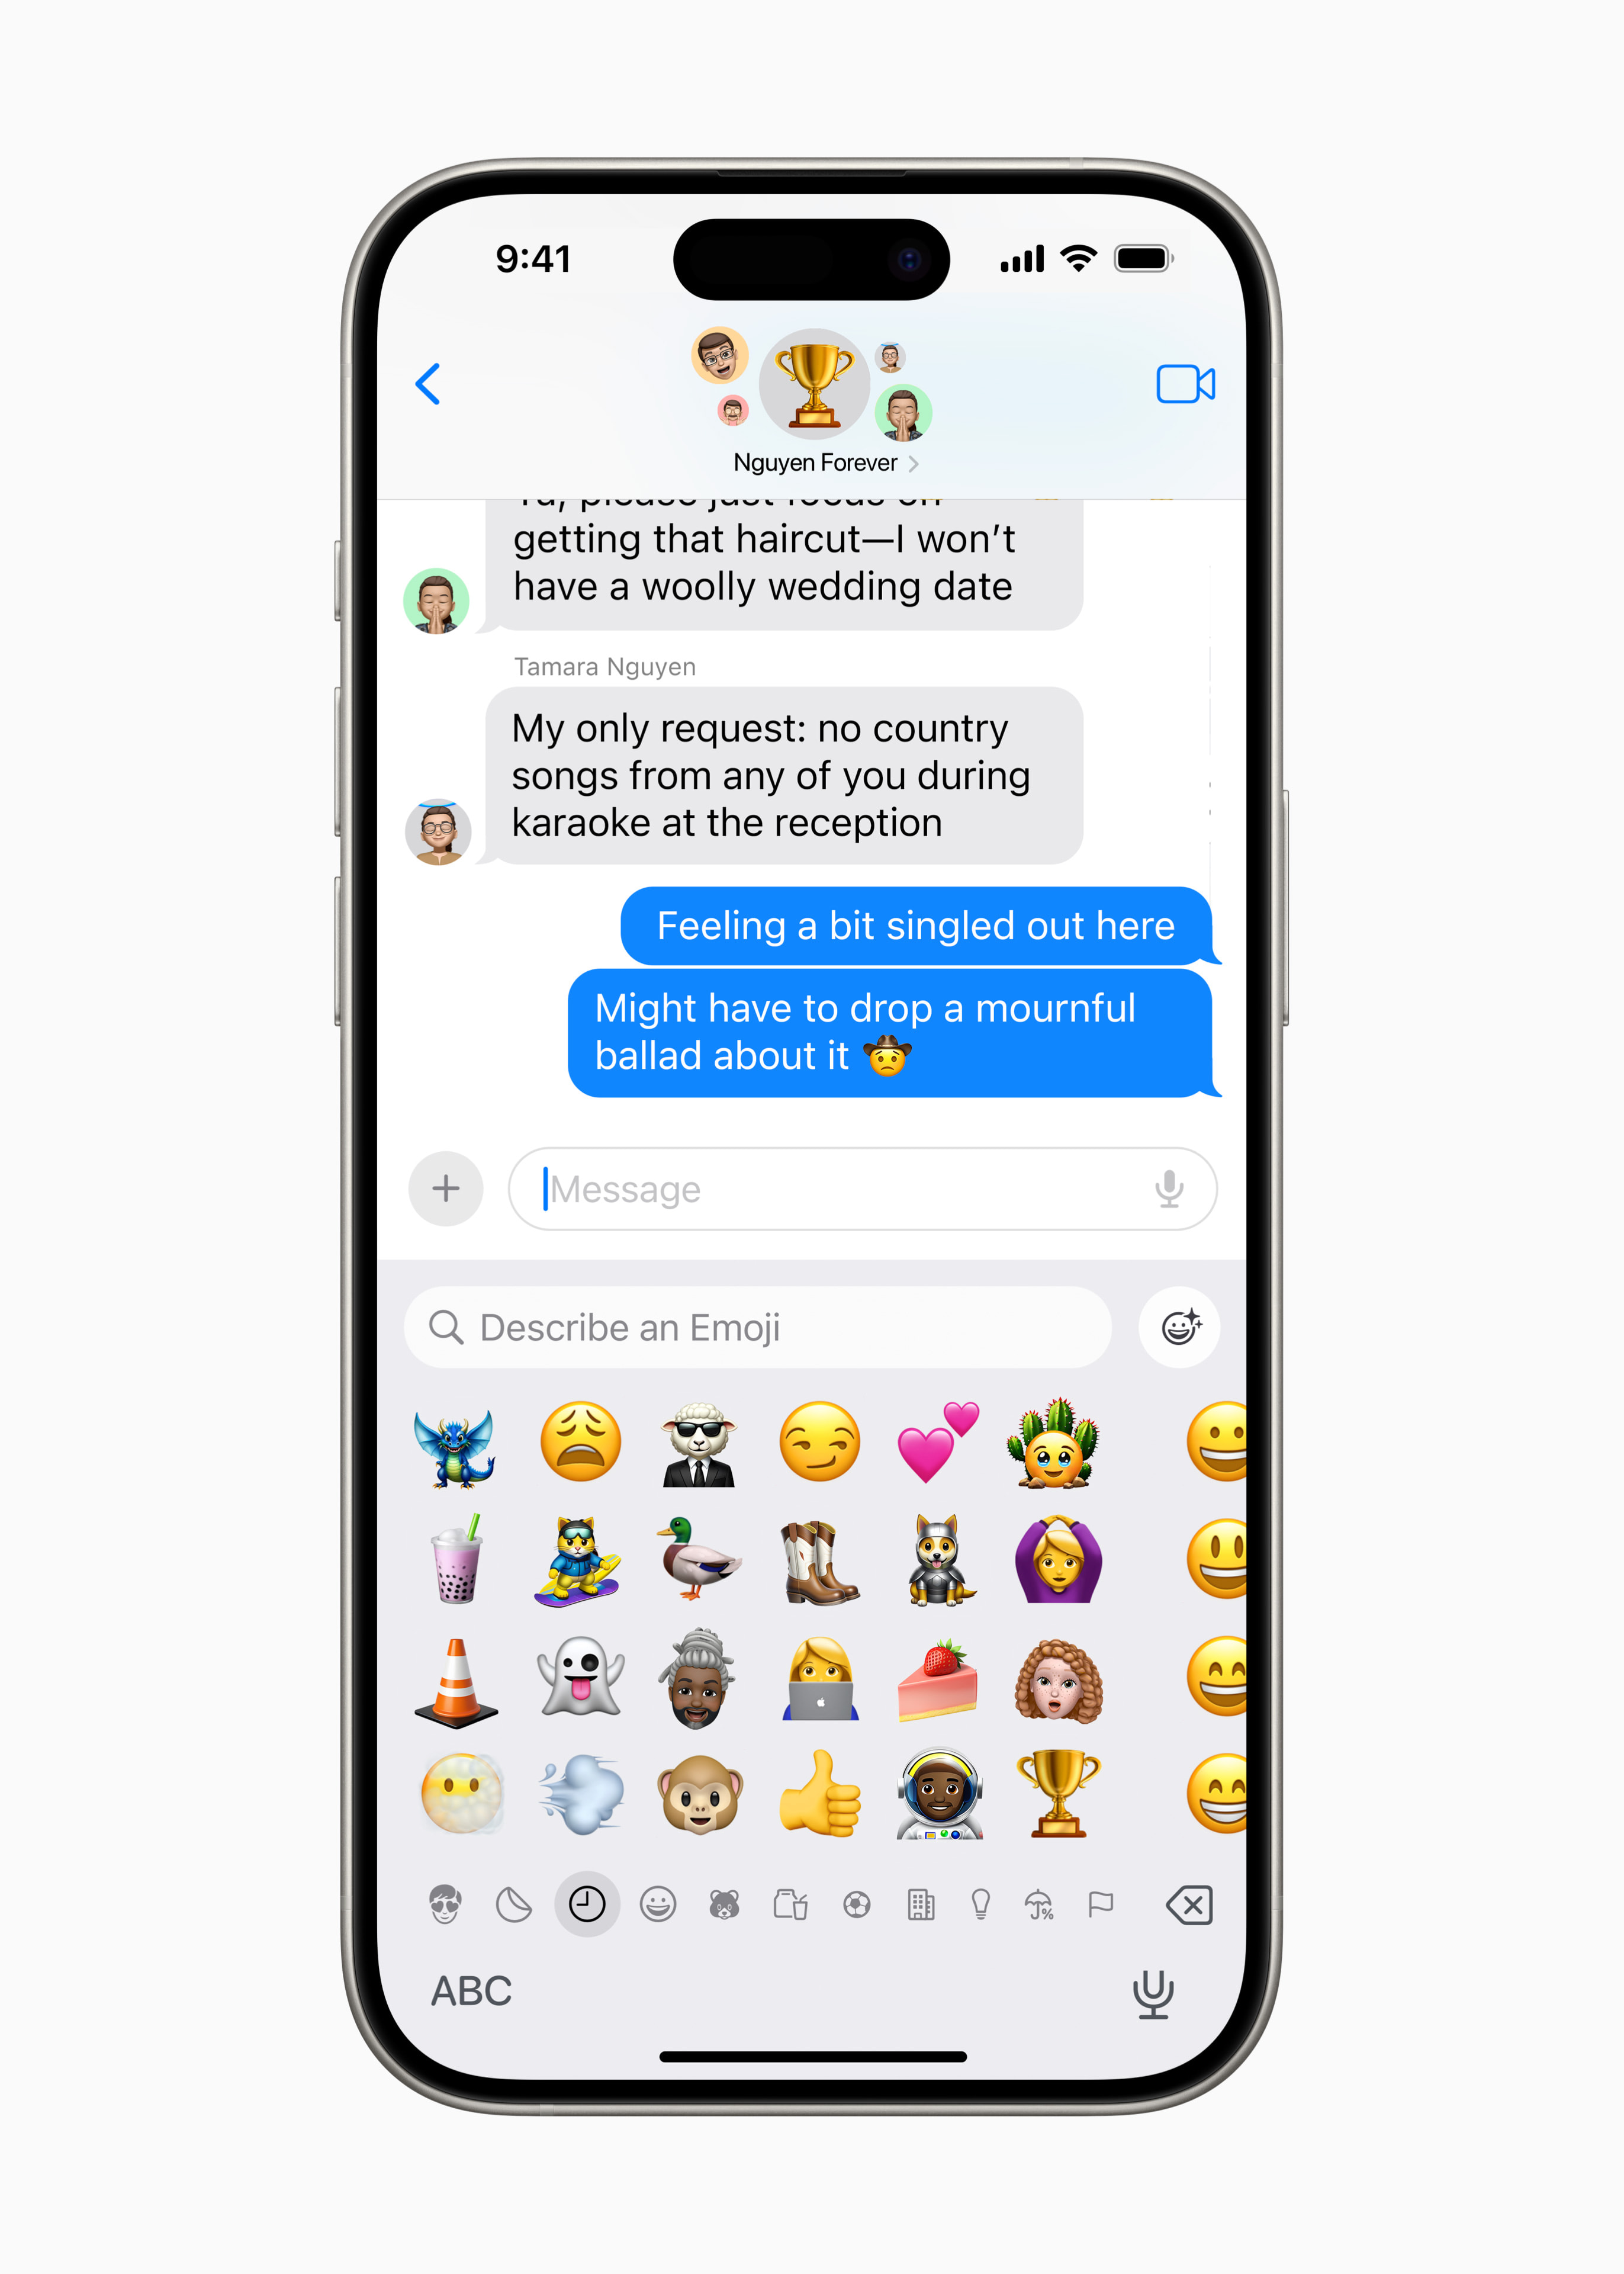
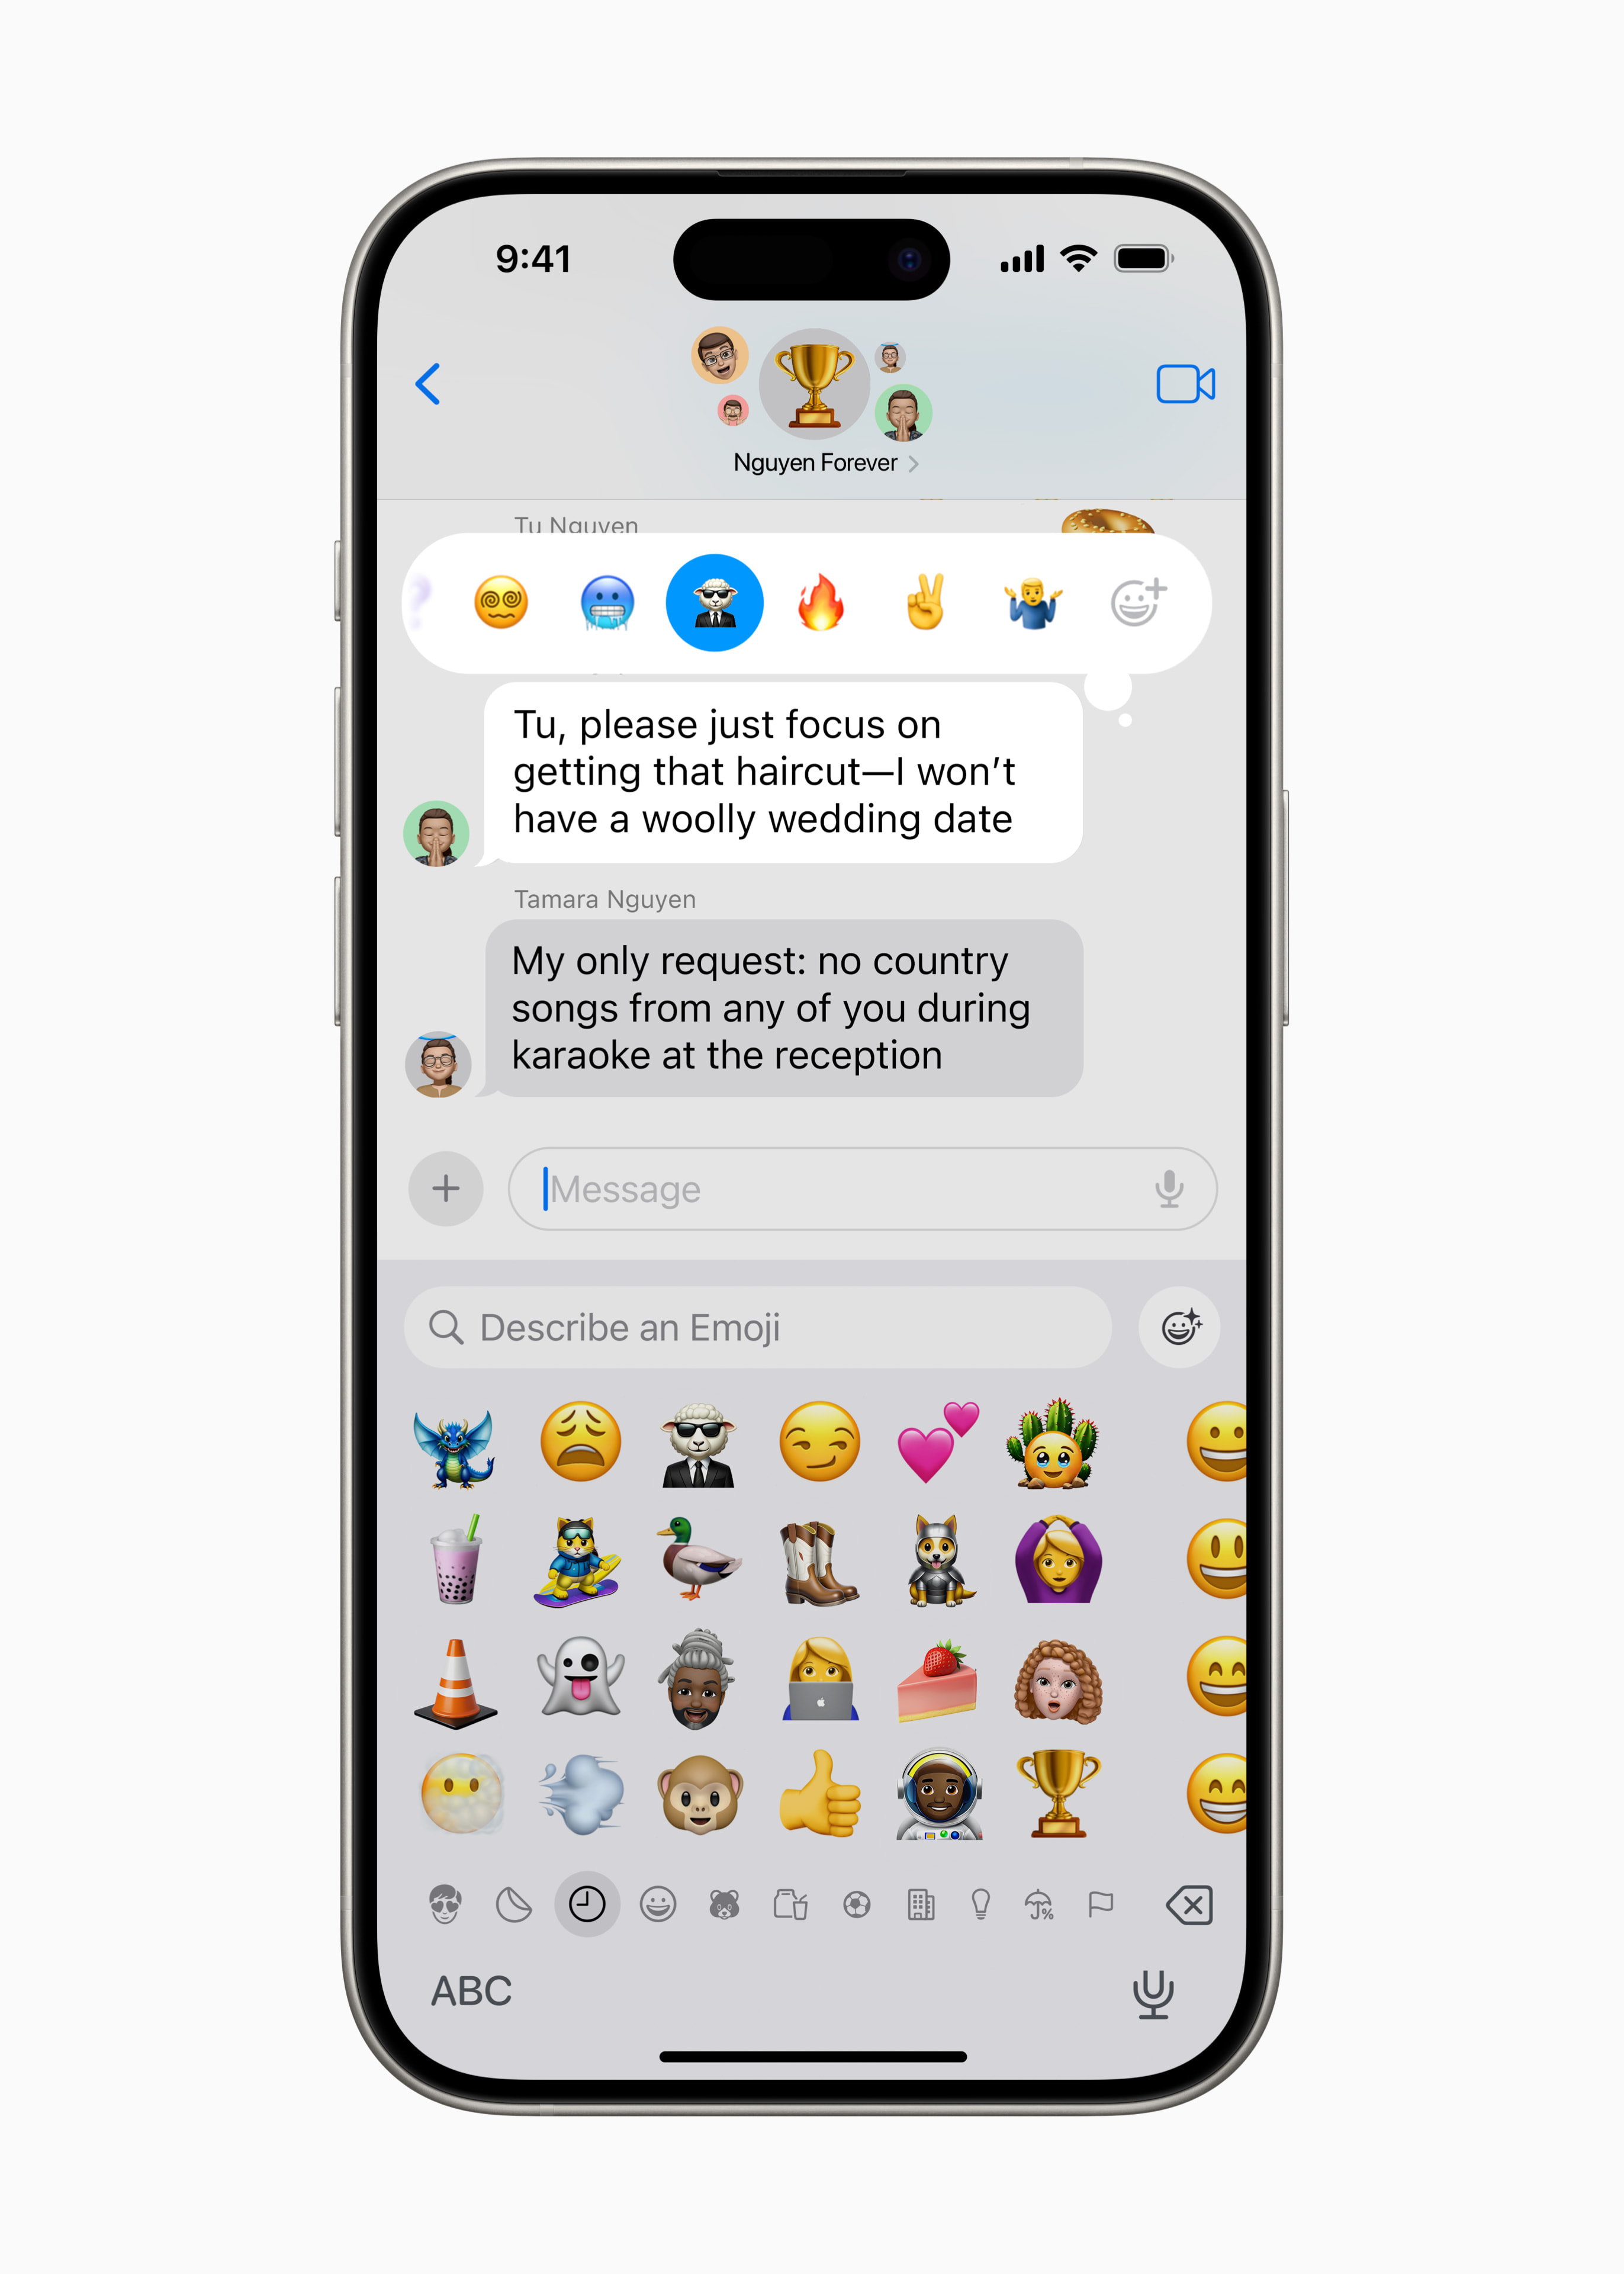
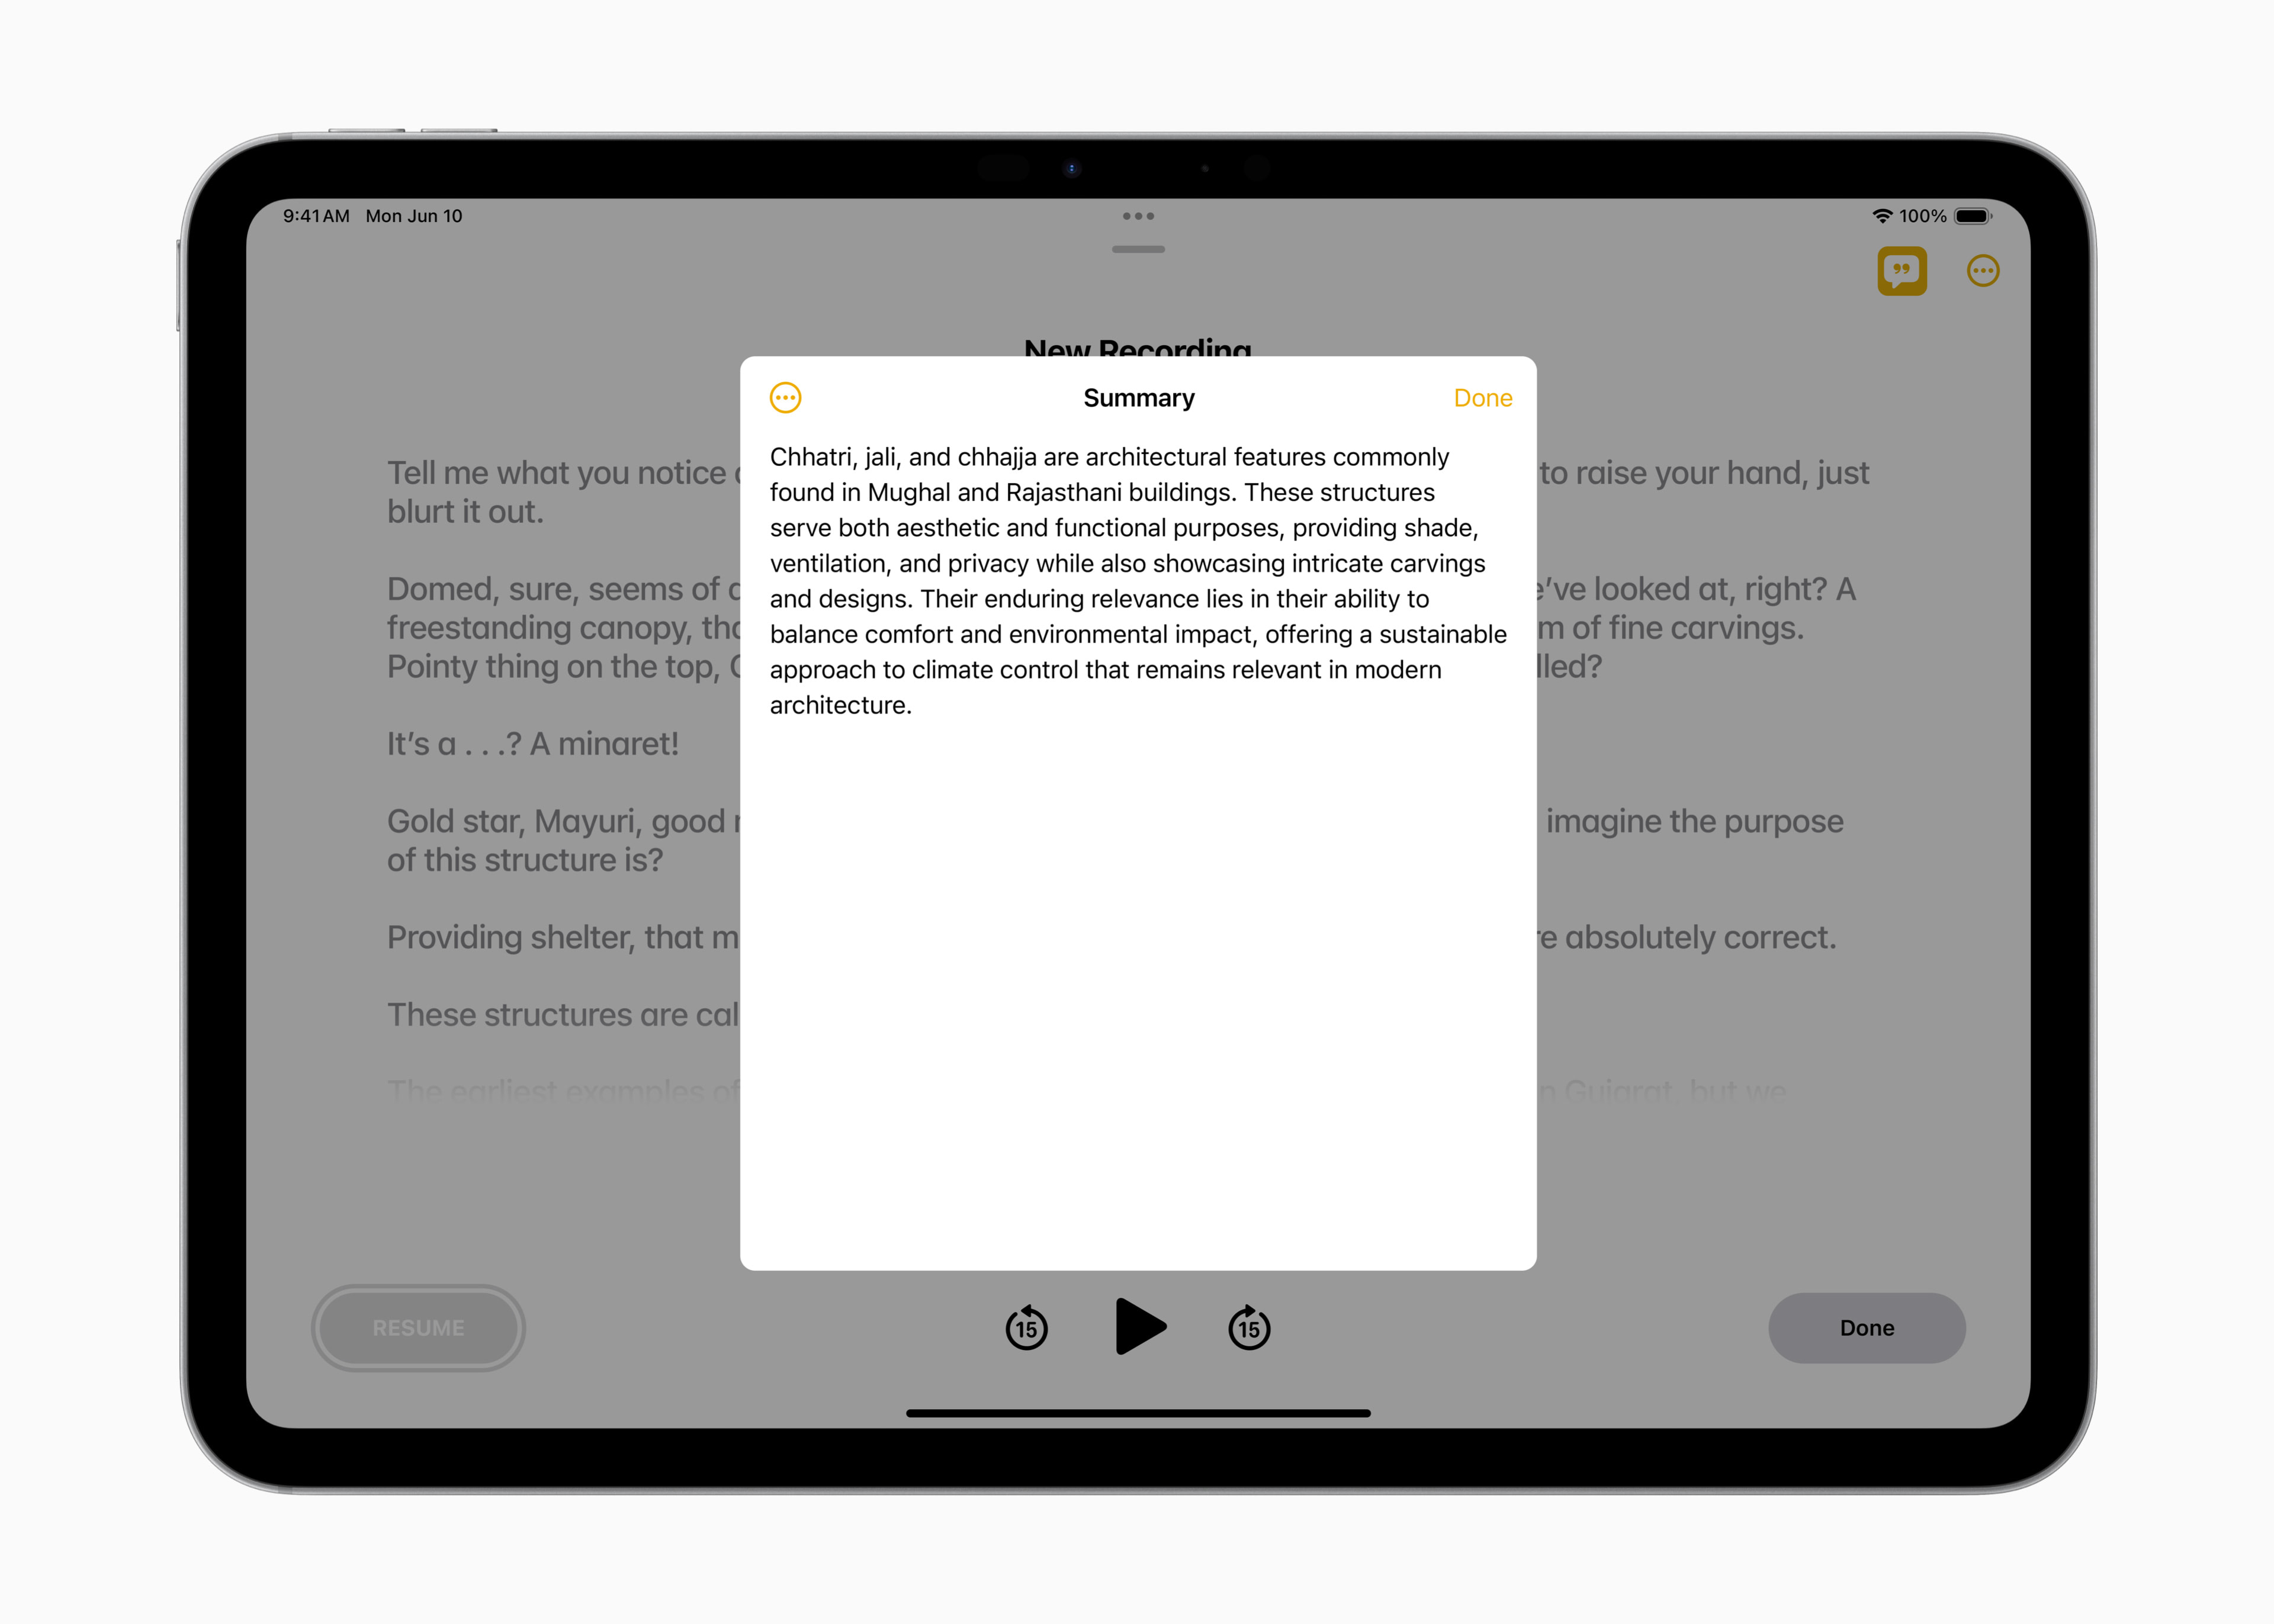
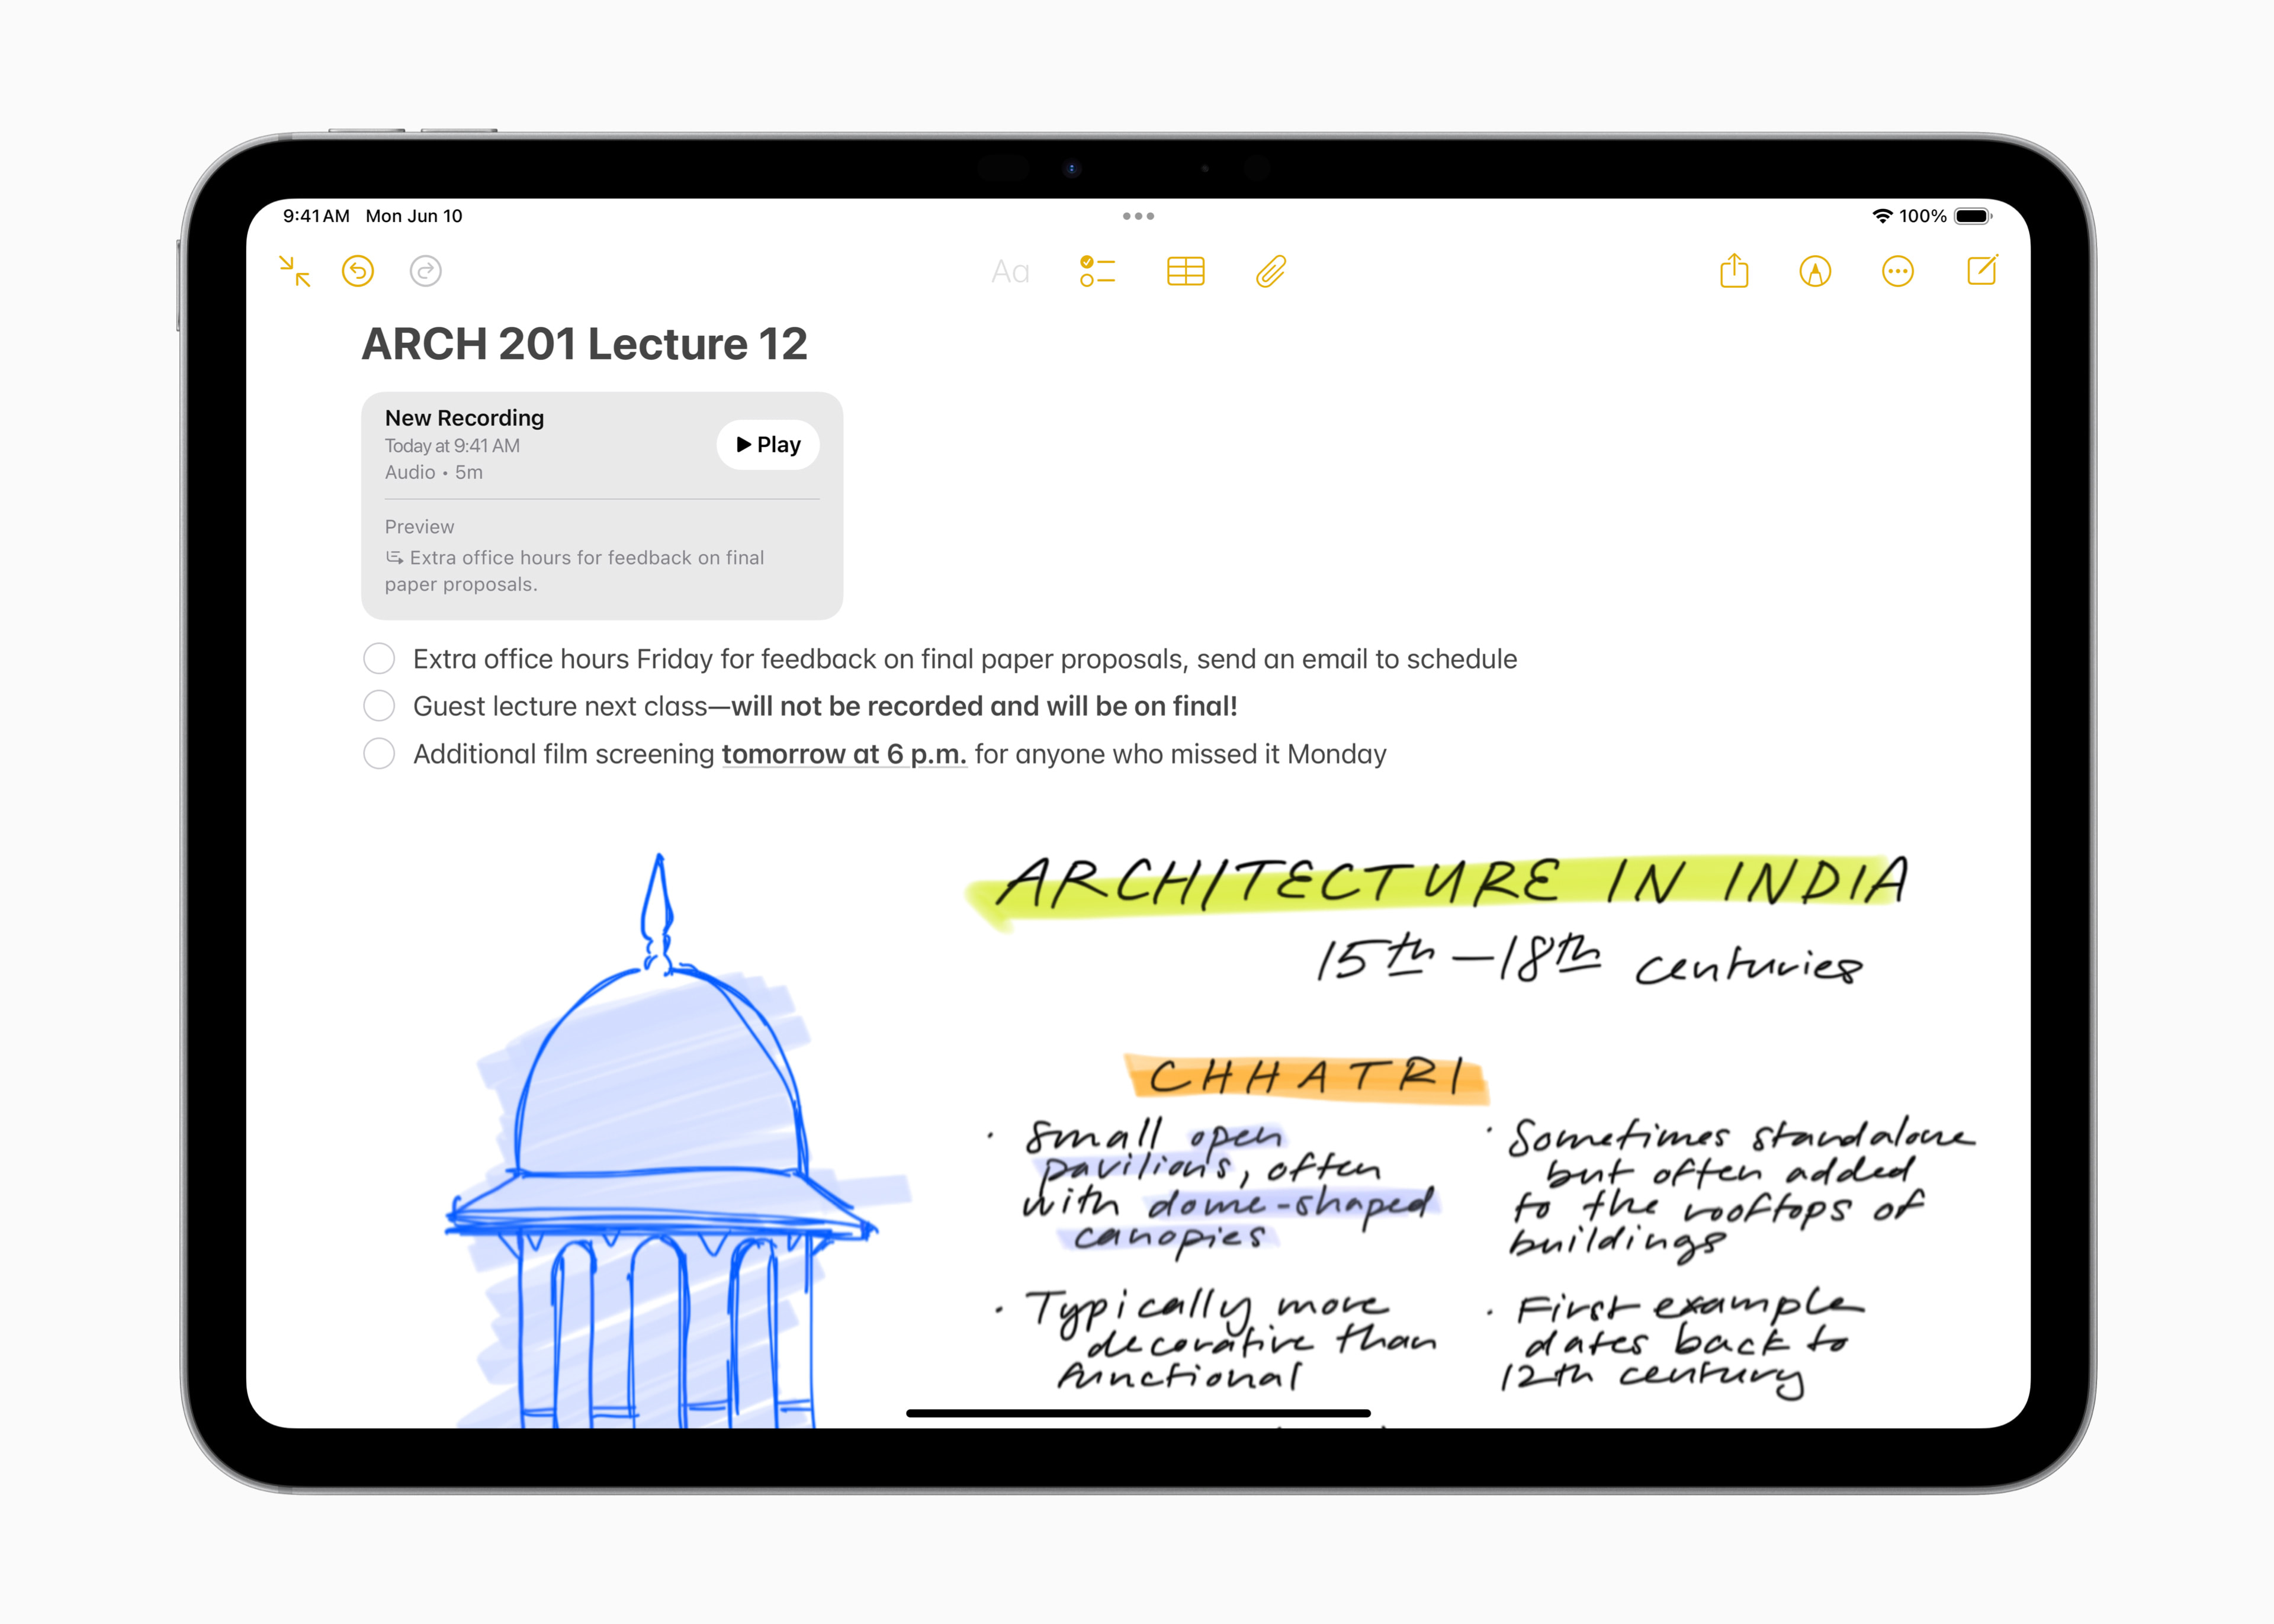
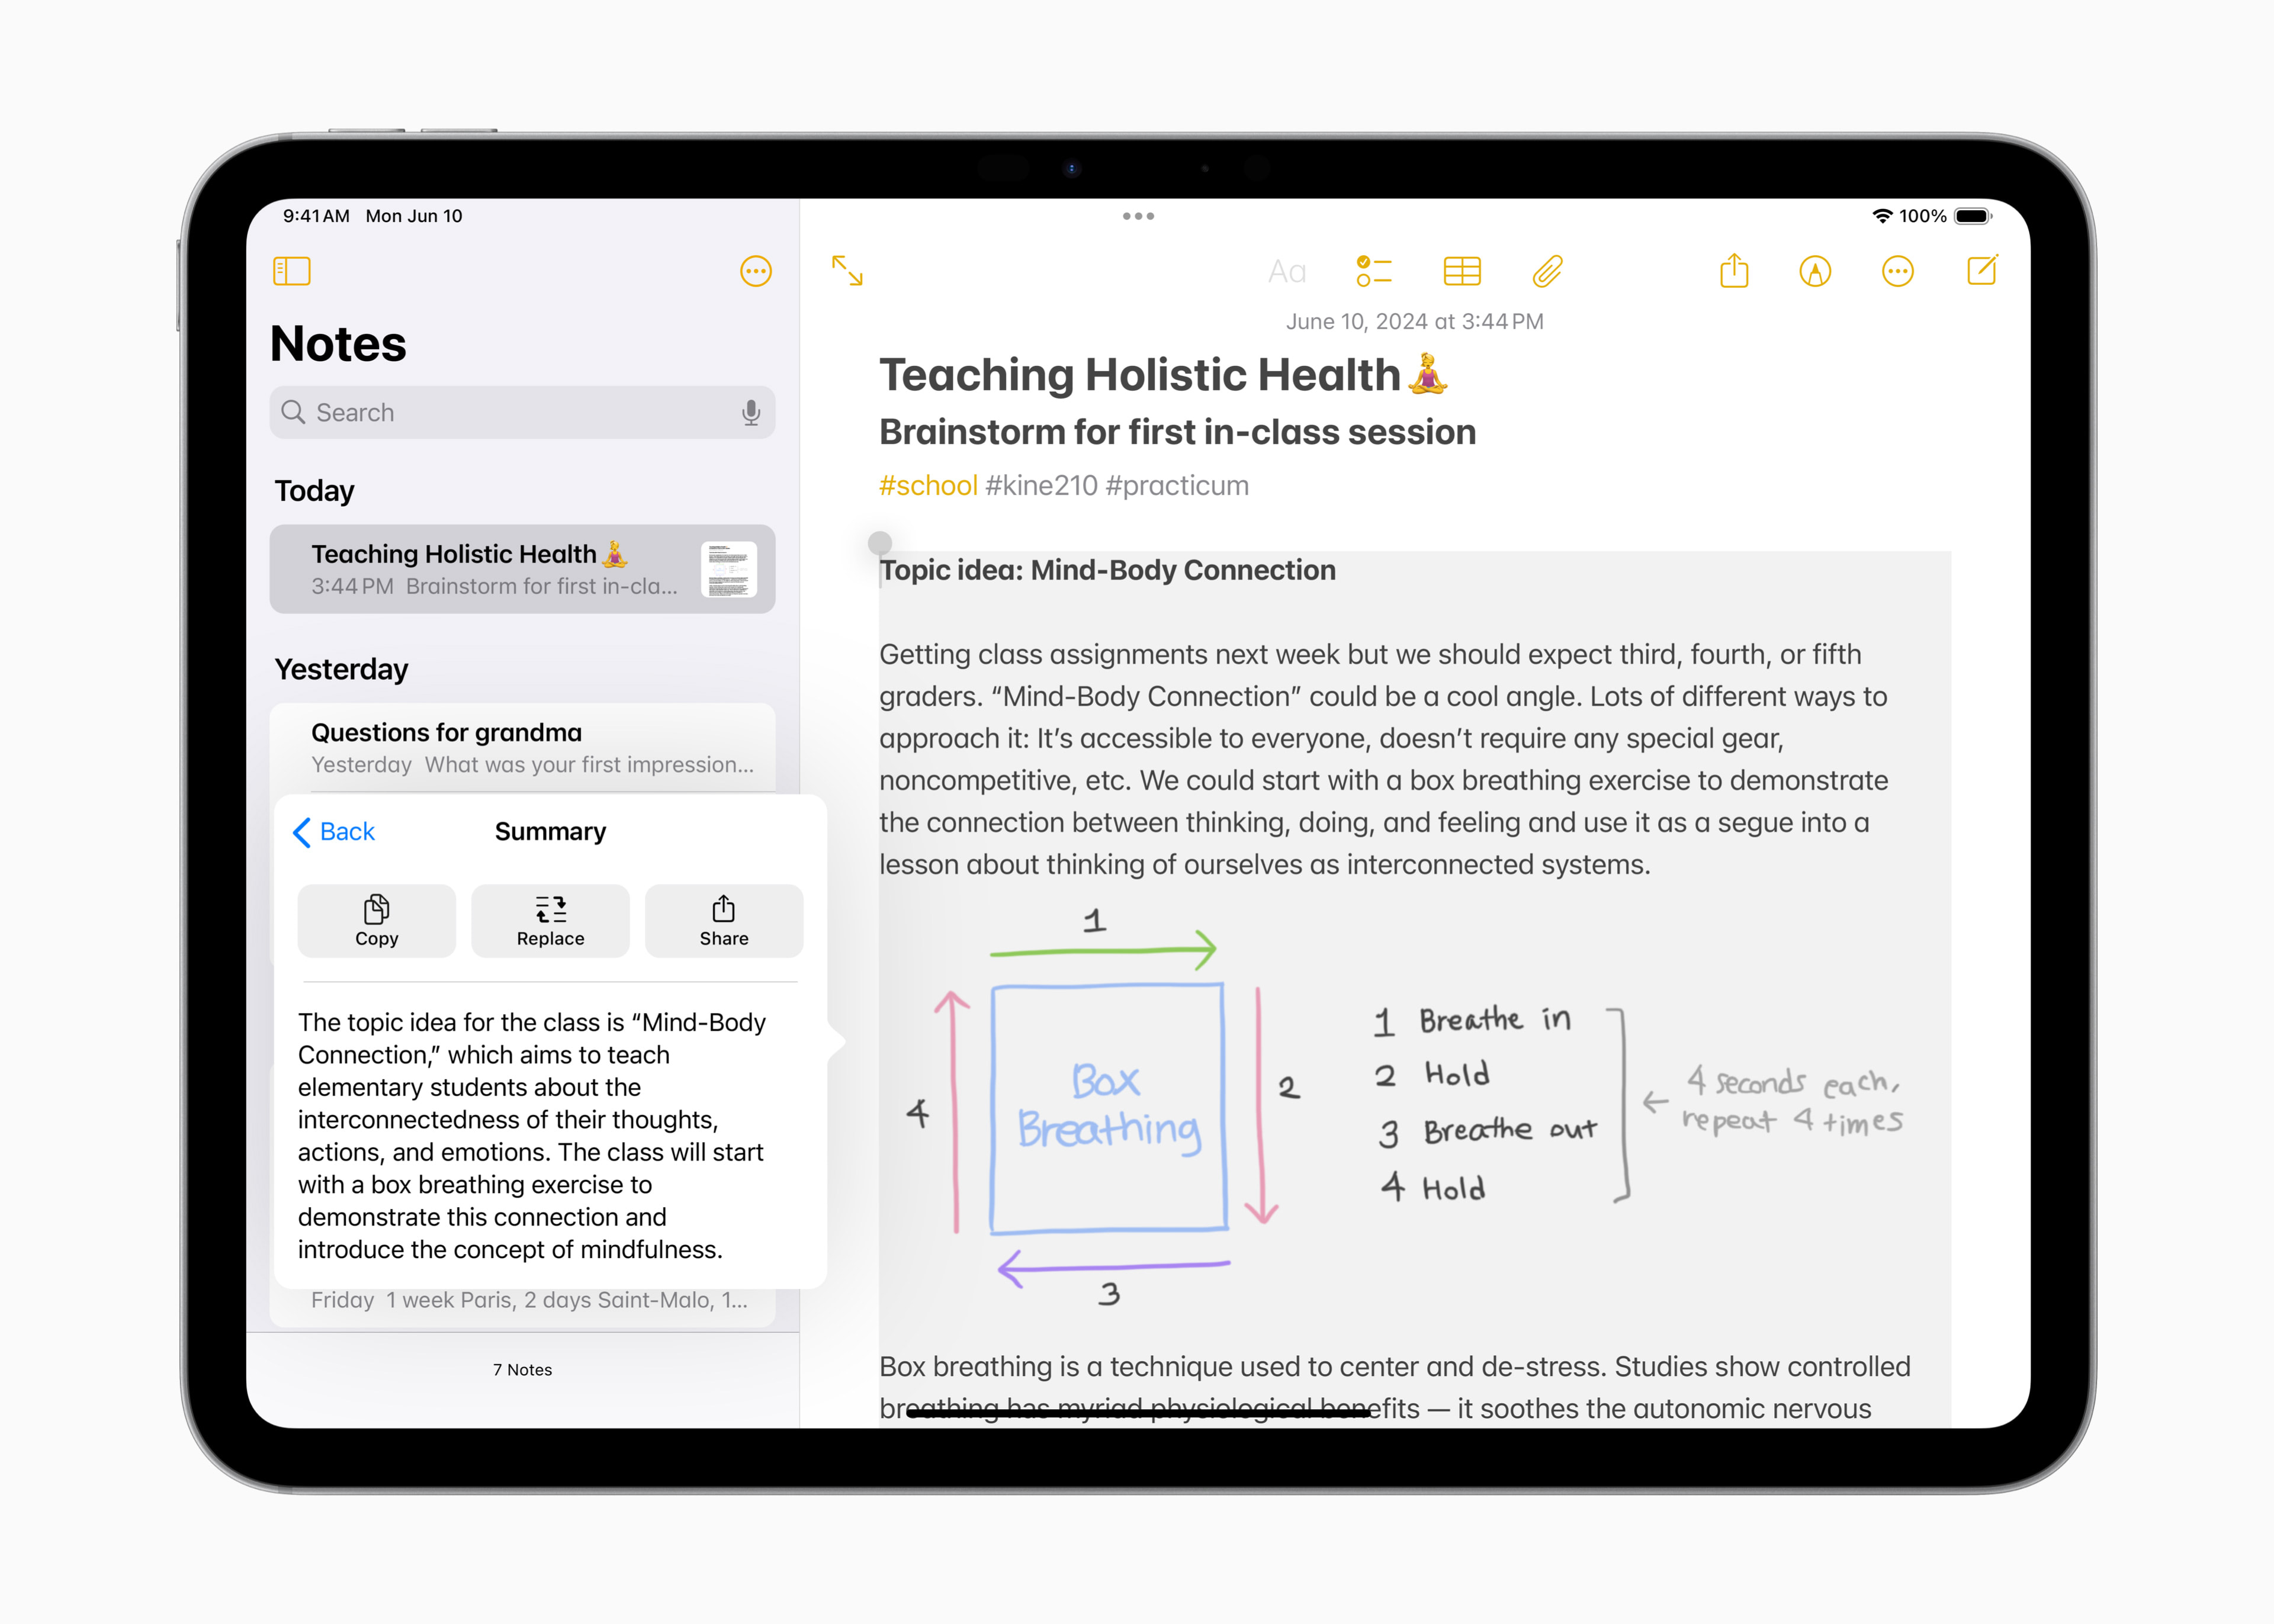
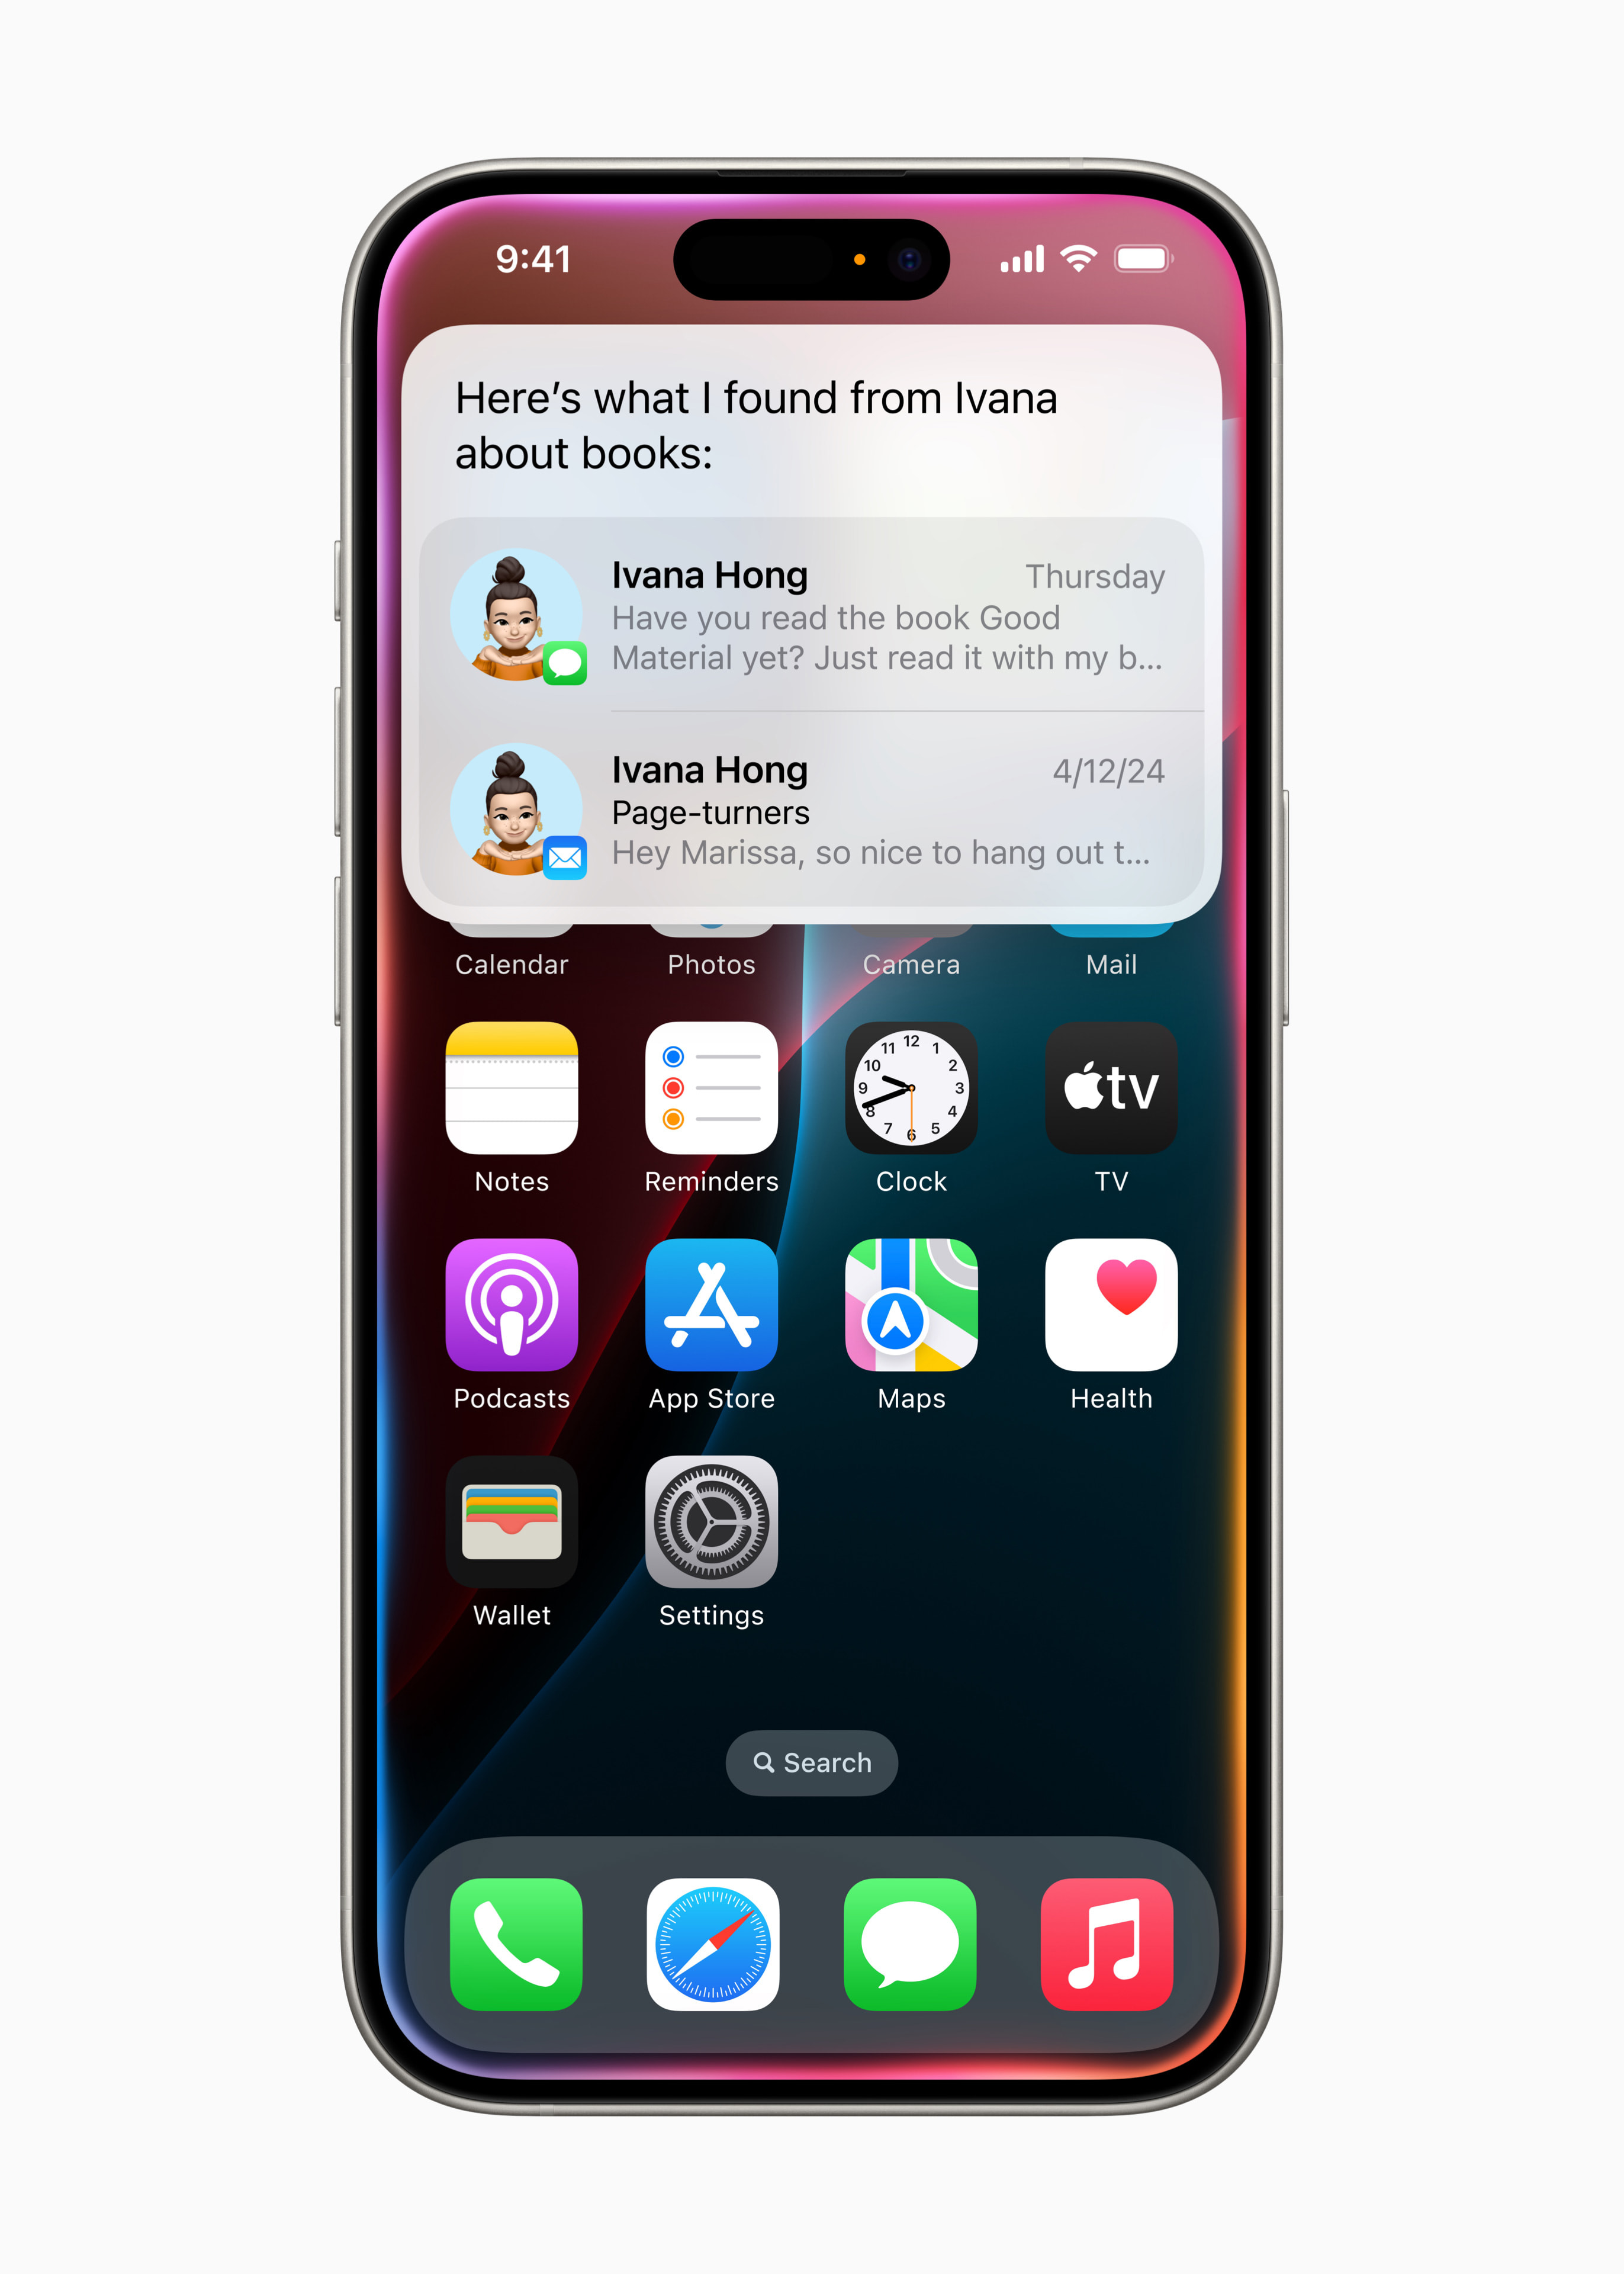
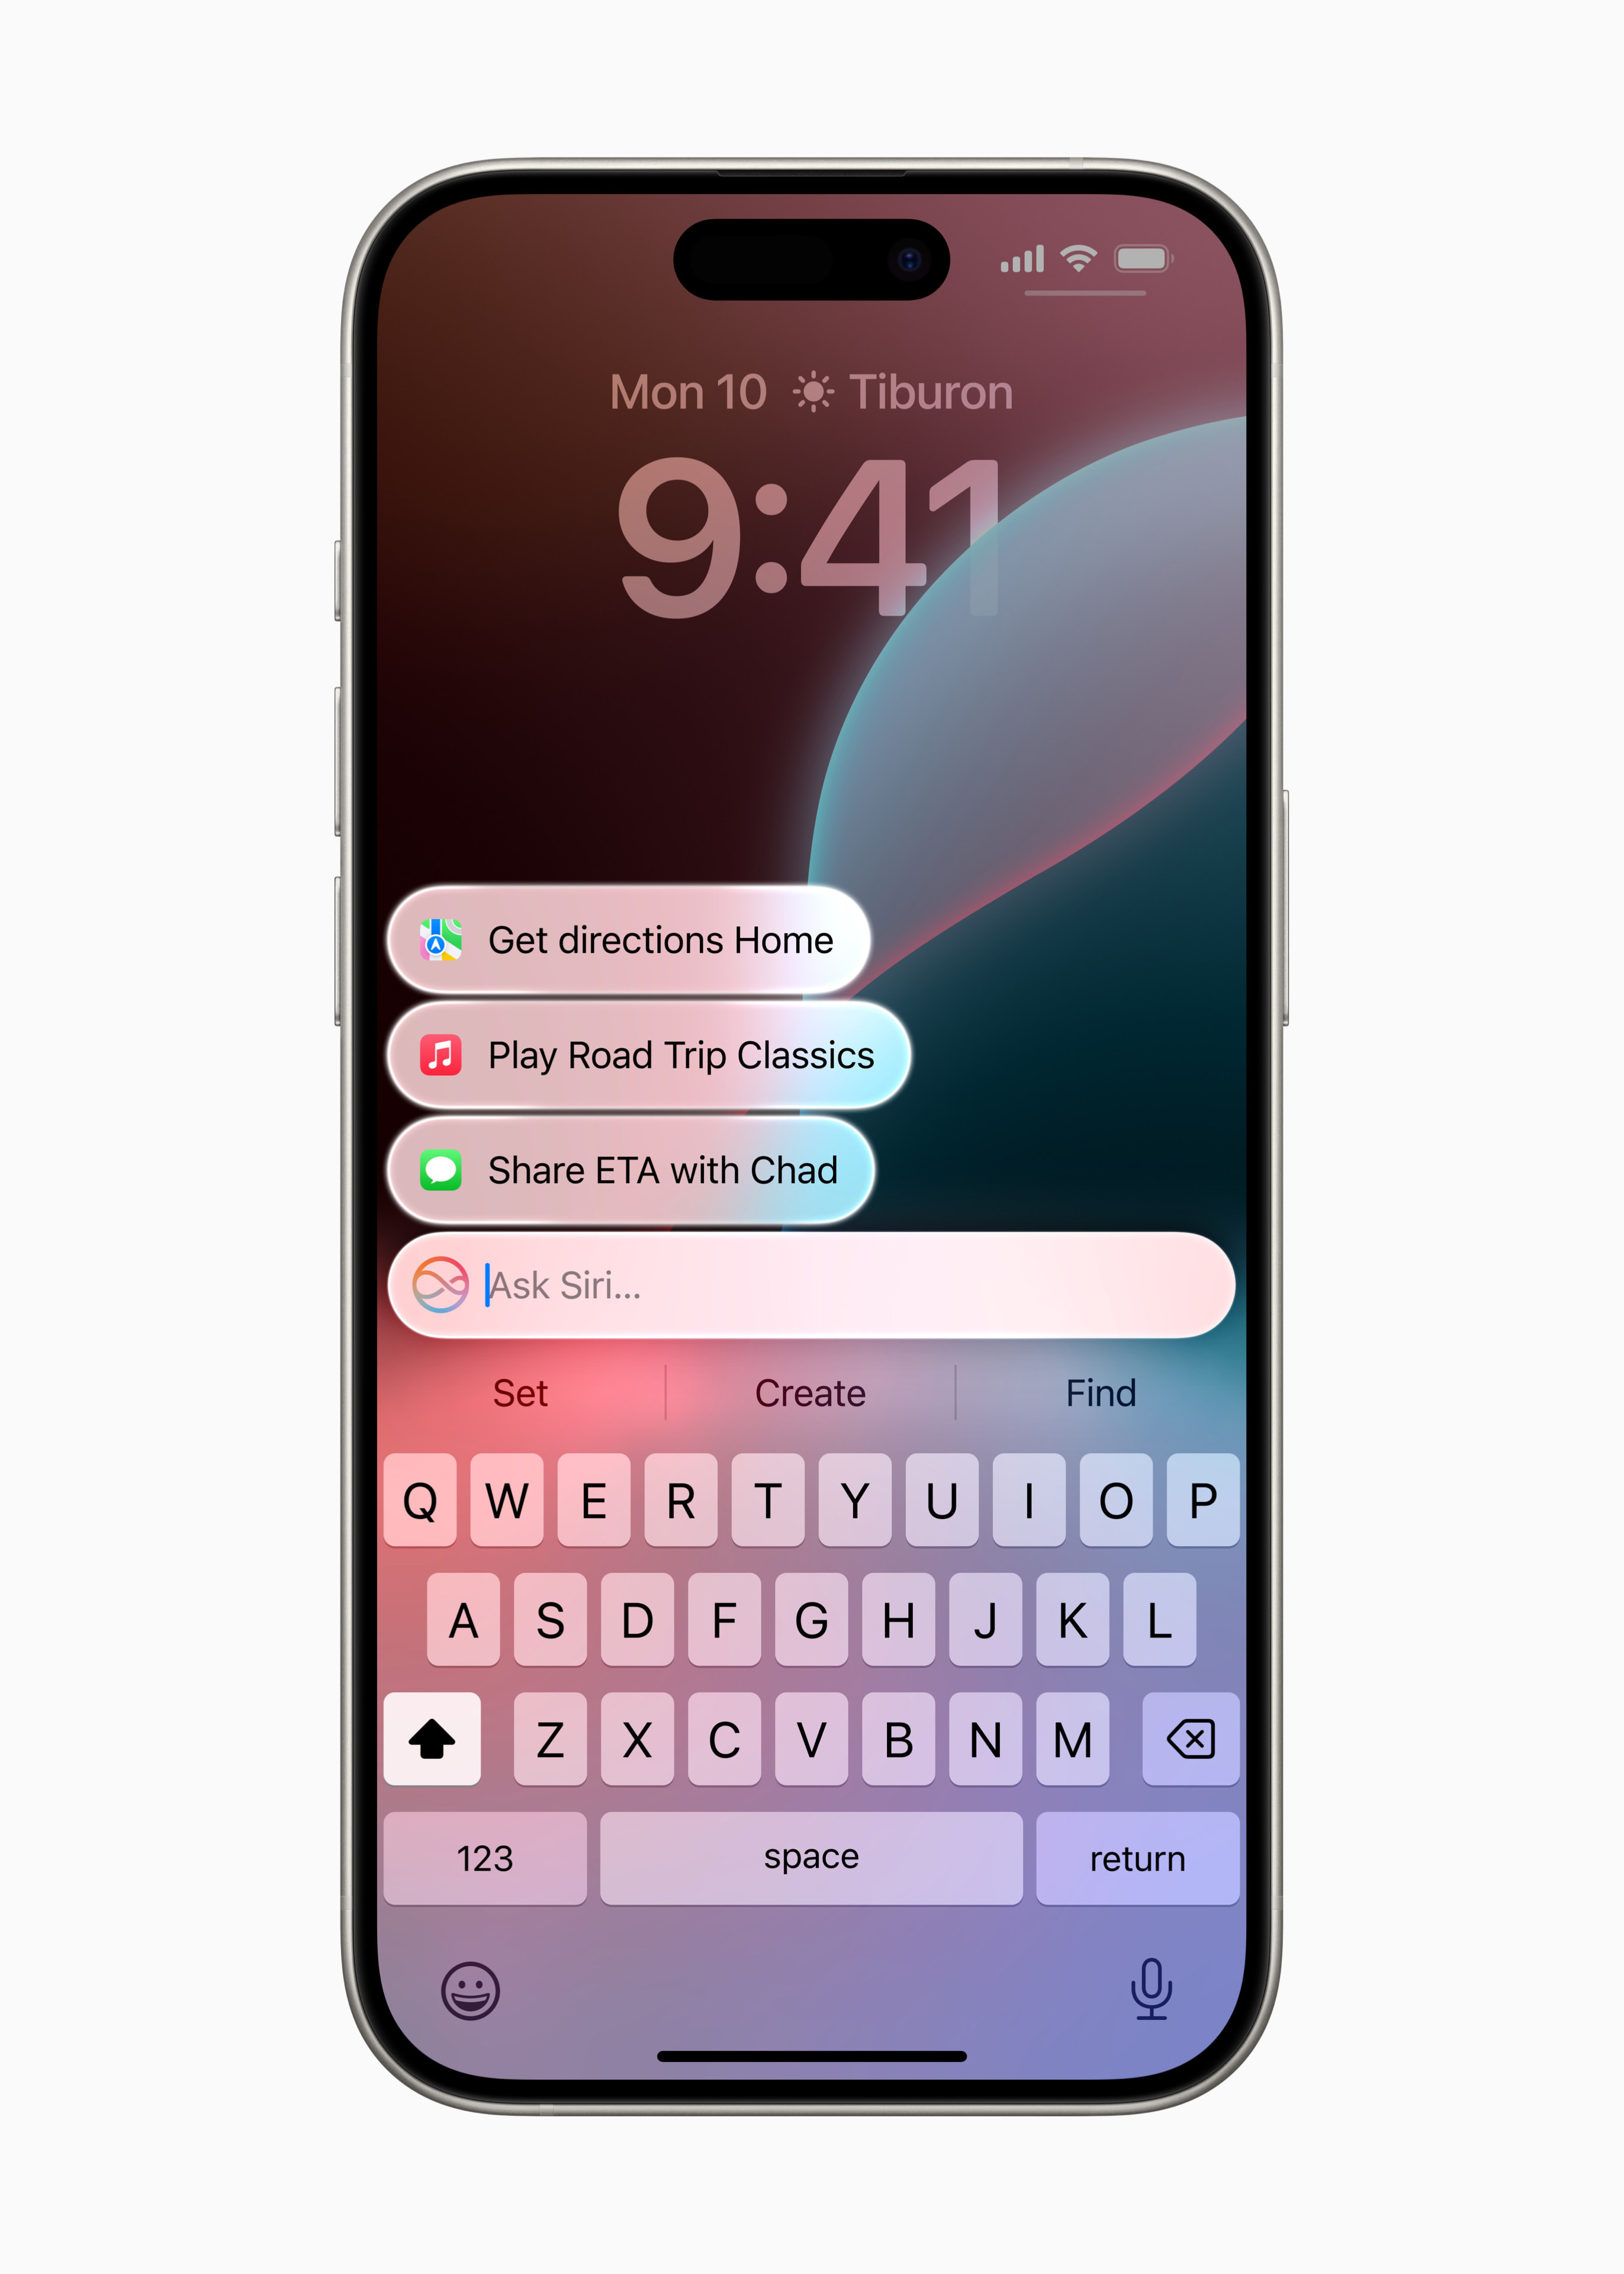
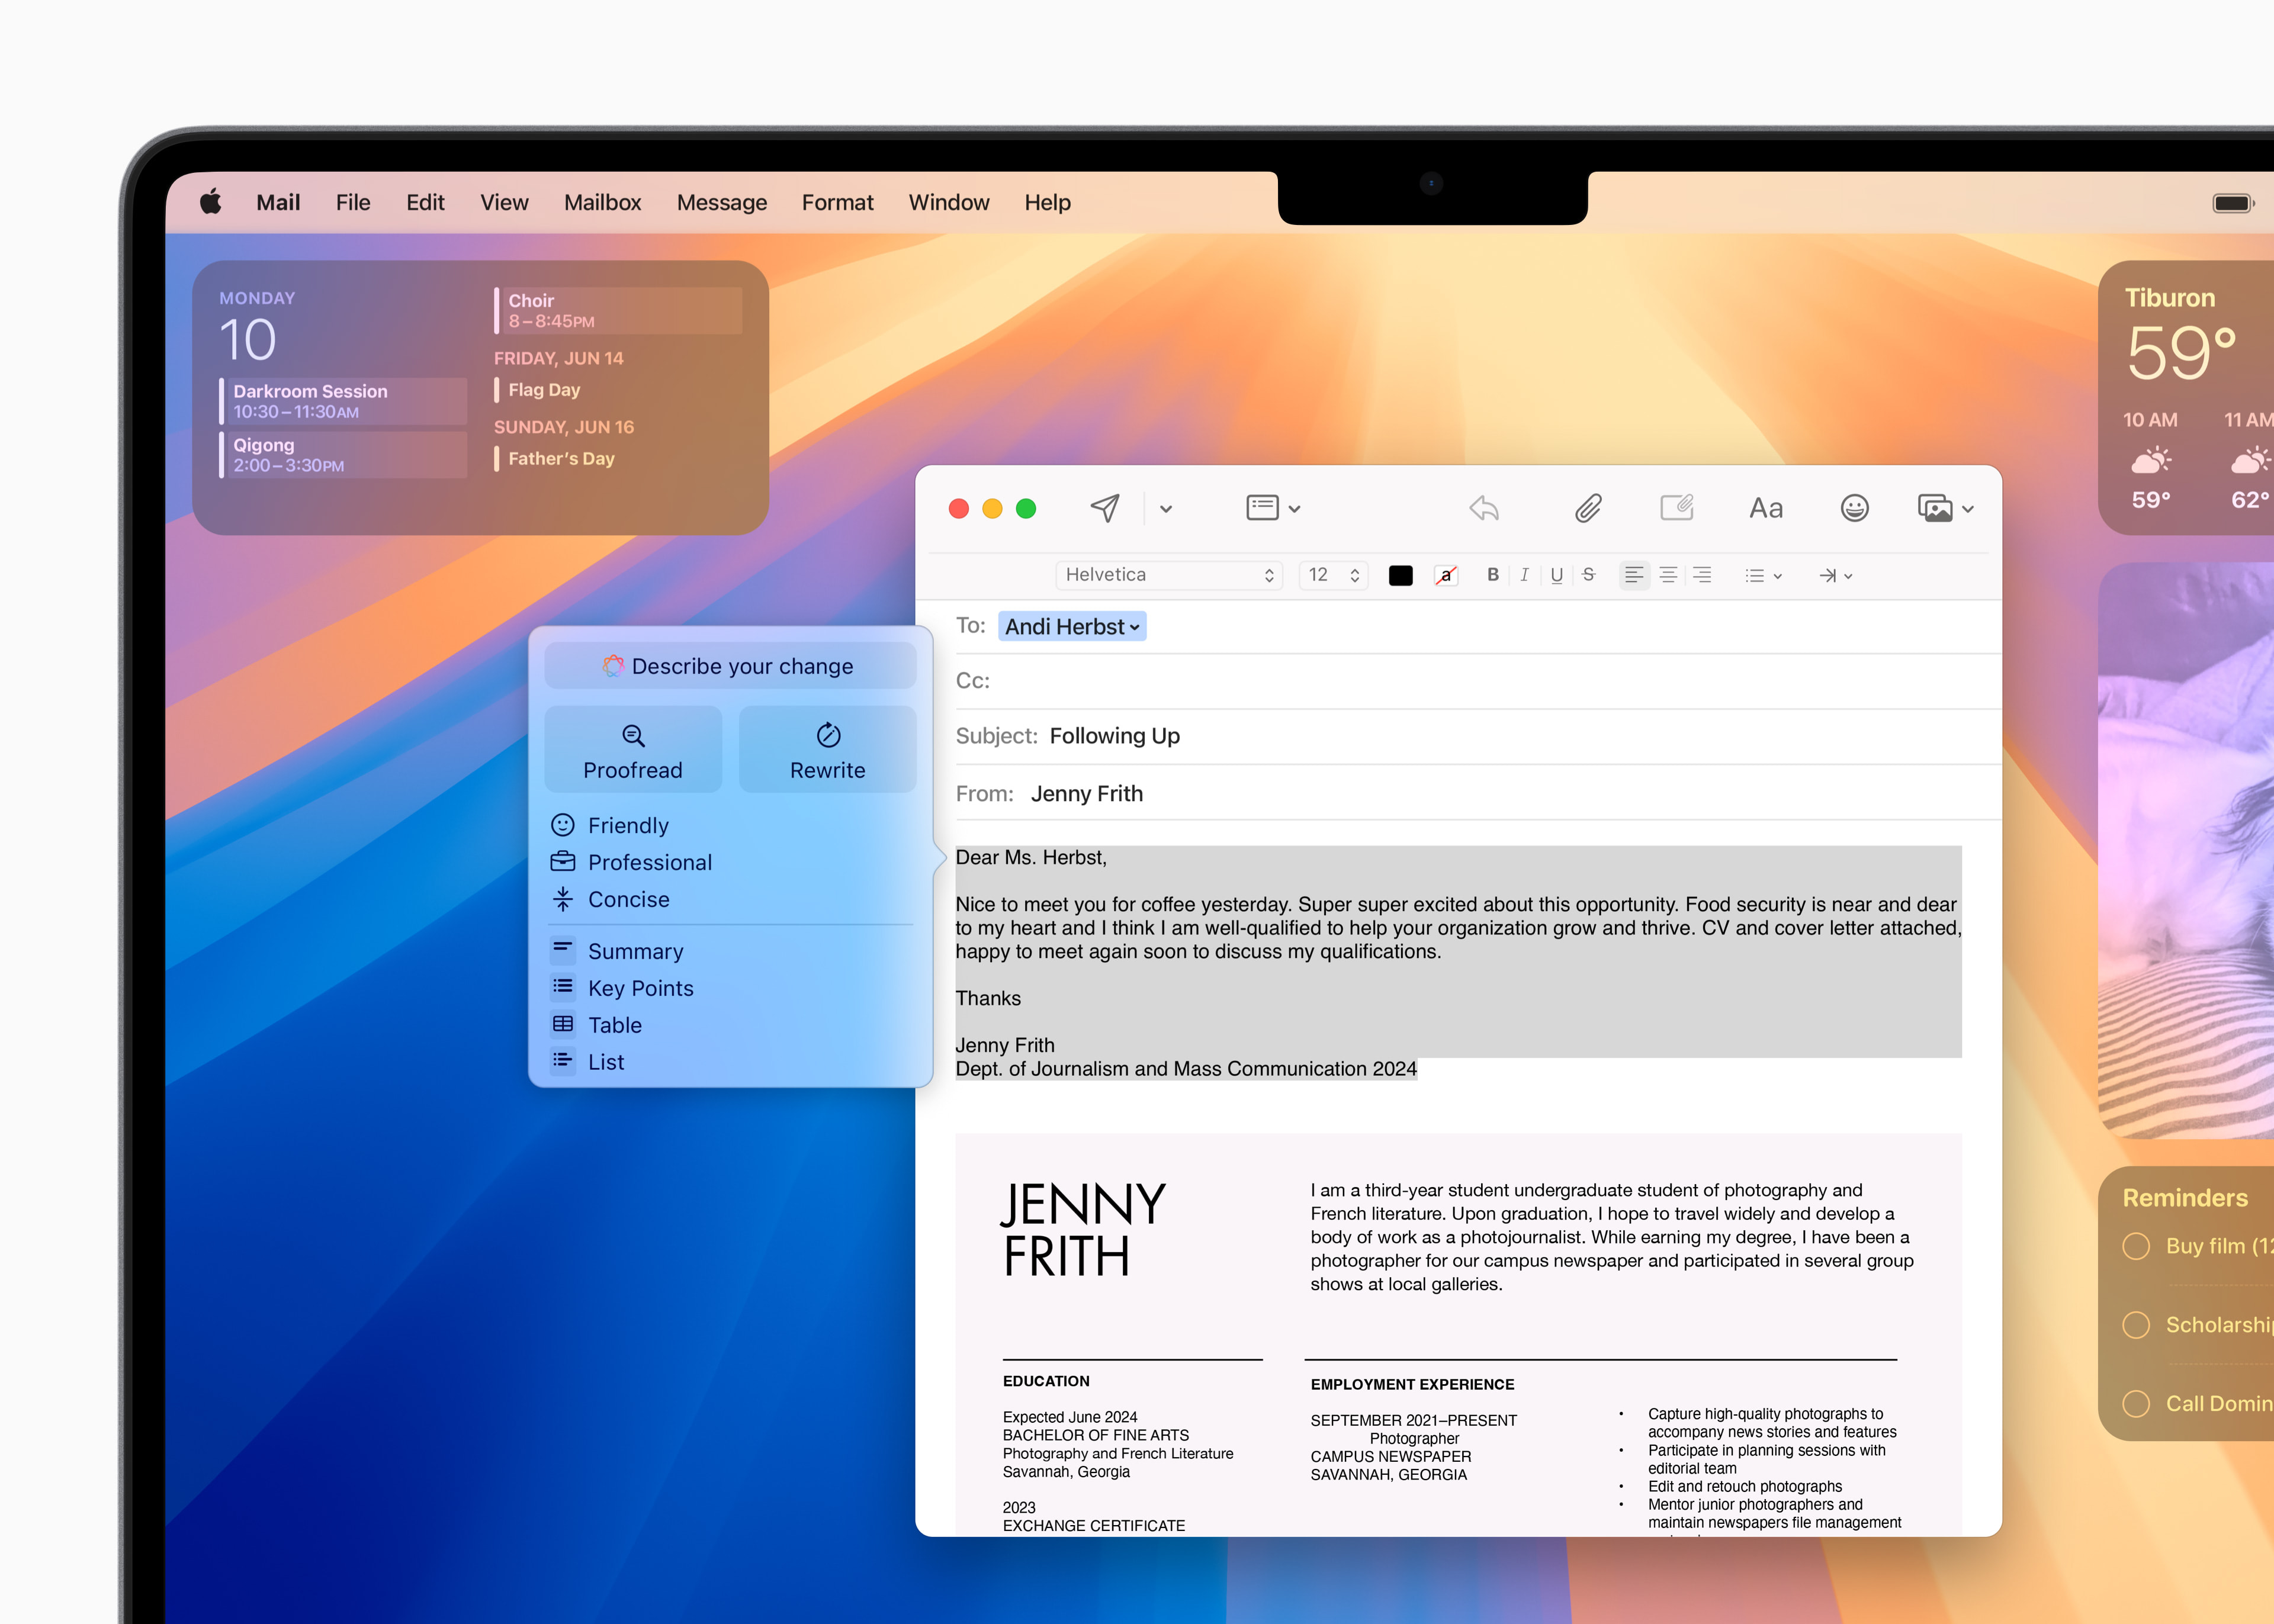
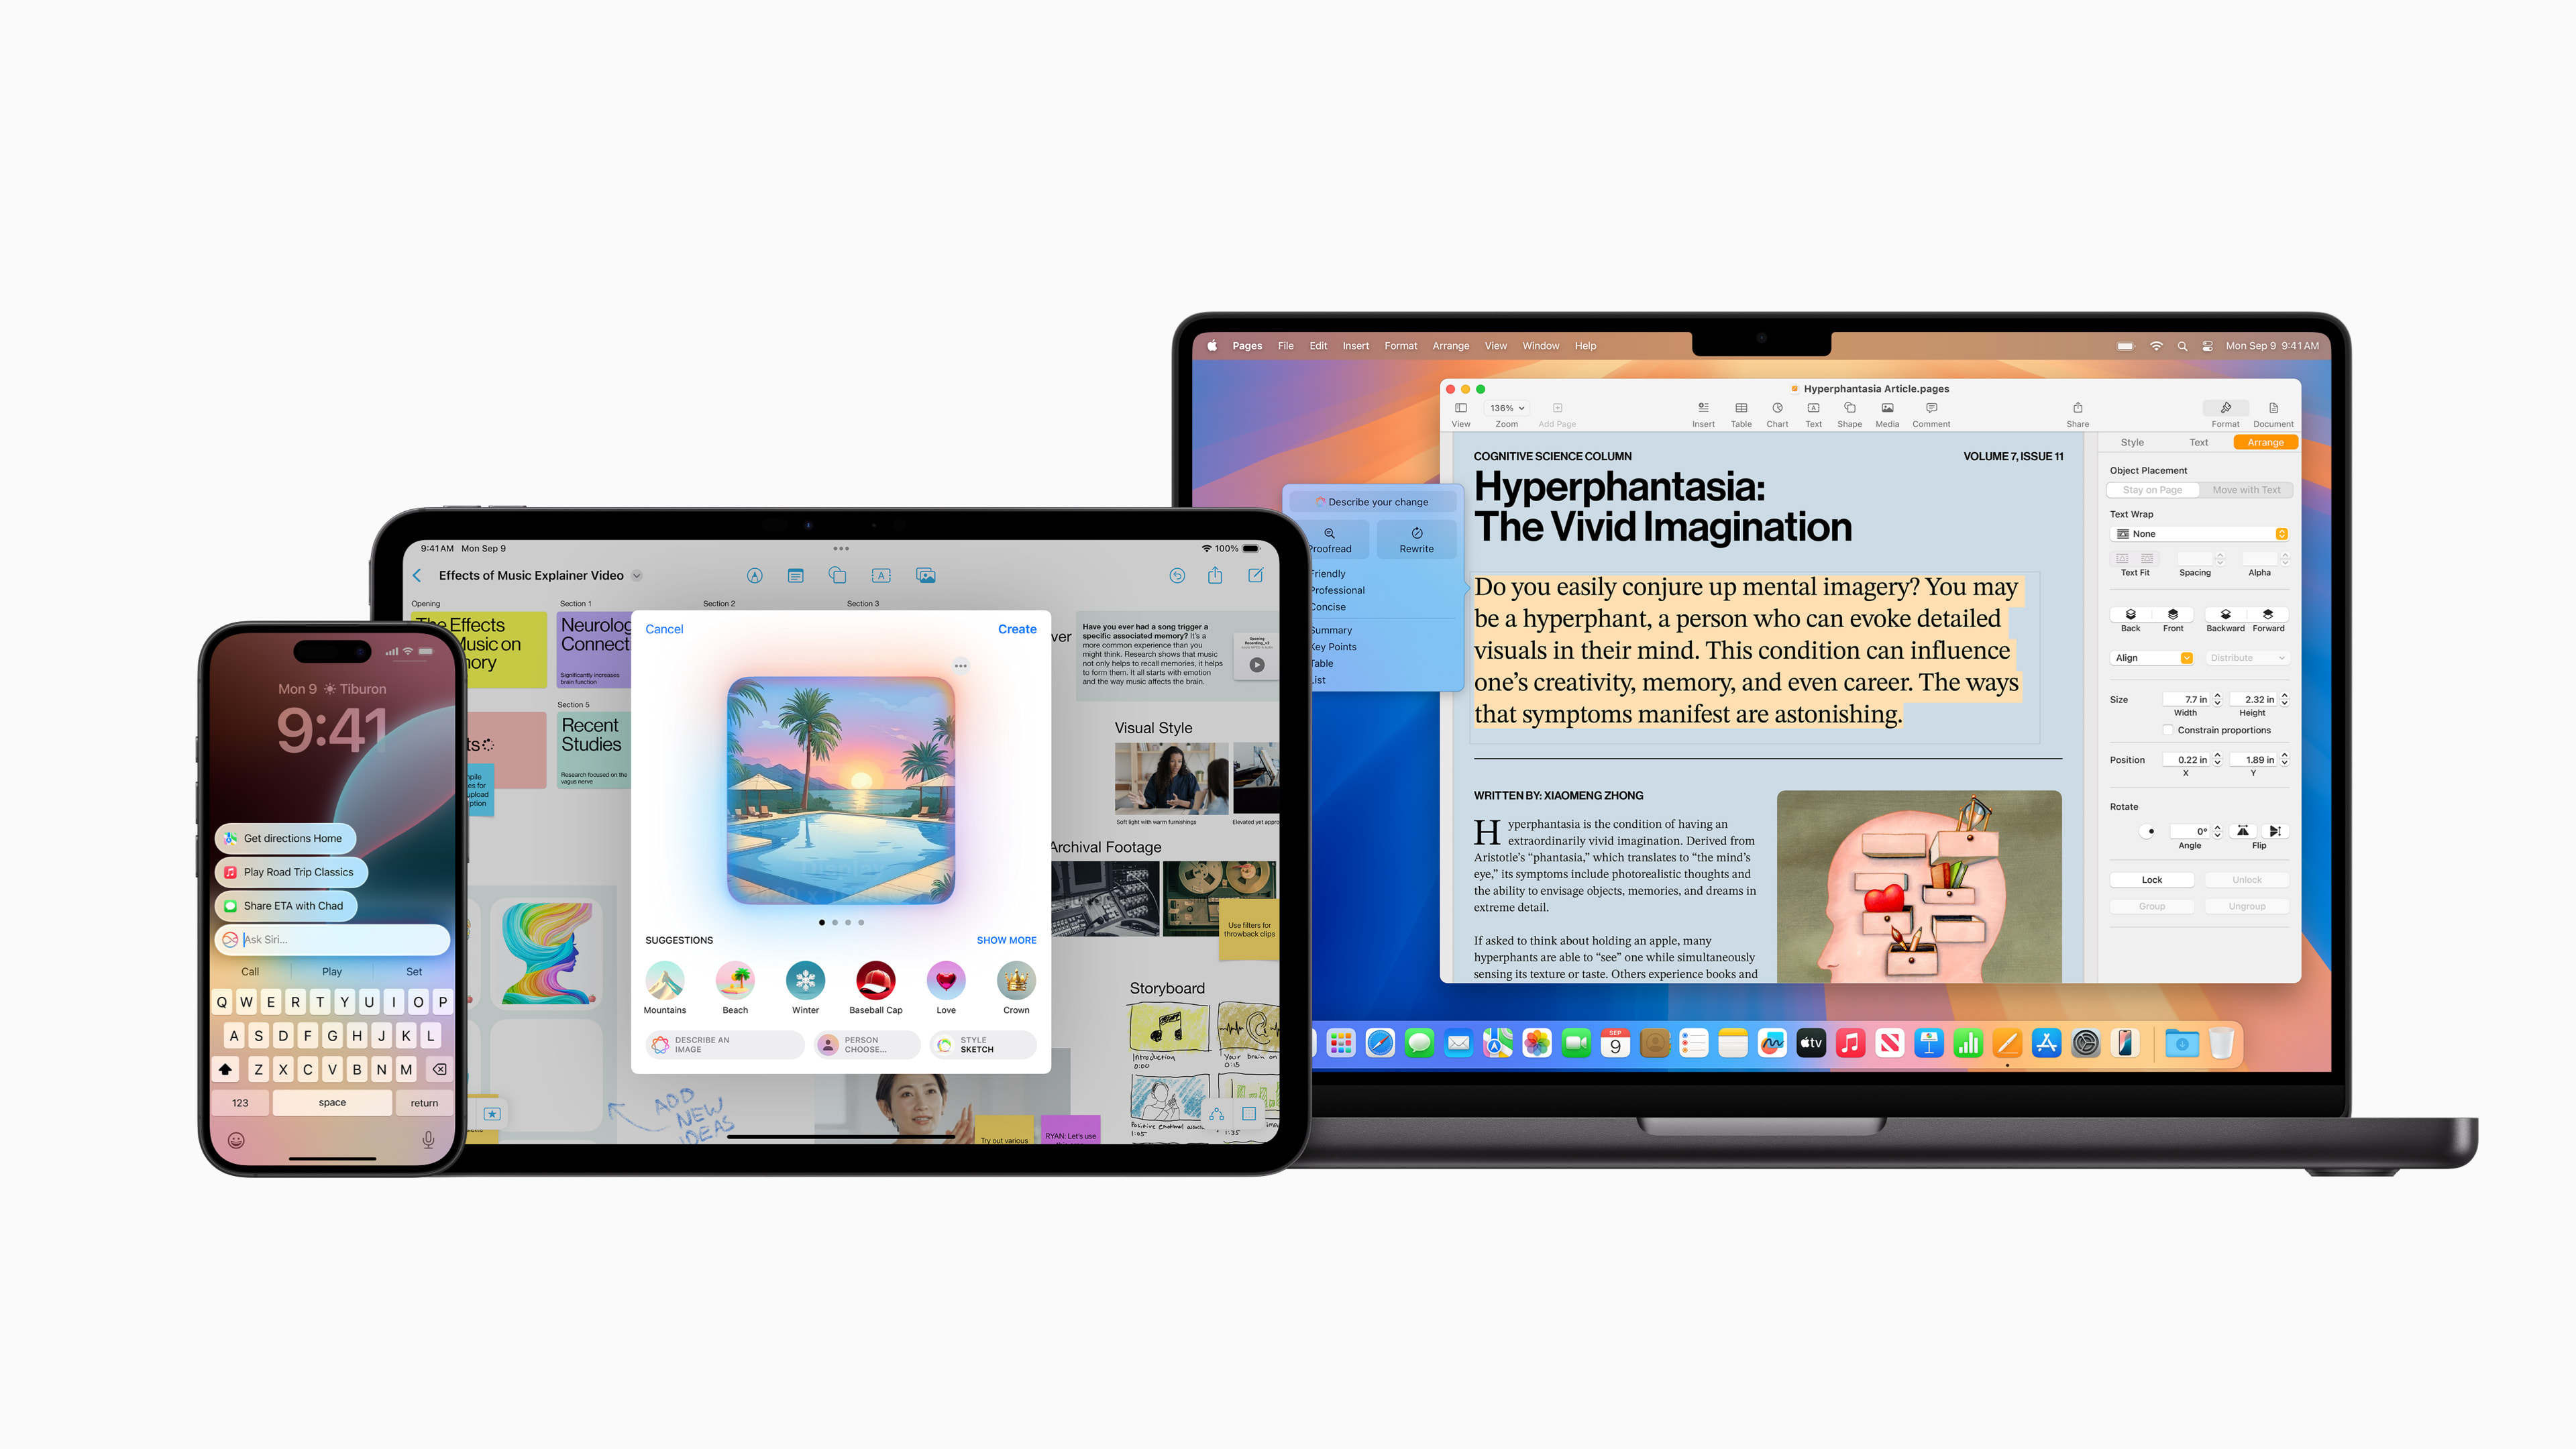
Et alors Apple Intelligence et les modèles qui sont utilisés pour son fonctionnement, Apple dit que dans ce cas, tout est formé sur des données sous licence, y compris des données sélectionnées pour des améliorations particulières de fonctionnalités spécifiques. Pour un produit commercial, il n'y a aucun risque de controverse avec l'utilisation de données spécialement obtenues.




Maintenant en. Mais ils lui vont bien.