
A principios de semana, llegó al mundo de la tecnología una noticia bastante inquietante: algunas empresas tecnológicas importantes estaban utilizando subtítulos de YouTube para entrenar sus modelos de inteligencia artificial sin el consentimiento de los creadores de sus videos. Se suponía que uno de estos gigantes sería Apple, por lo que inicialmente se afirmó que los datos así obtenidos, que sin embargo nestAh, sí, pero una determinada startup, que era la tapadera de facto del gigante californiano, también lo utilizó para formación. Apple Intelligence. Pero ahora Apple en su declaración para 9to5mac denegado.
Podría interesarle
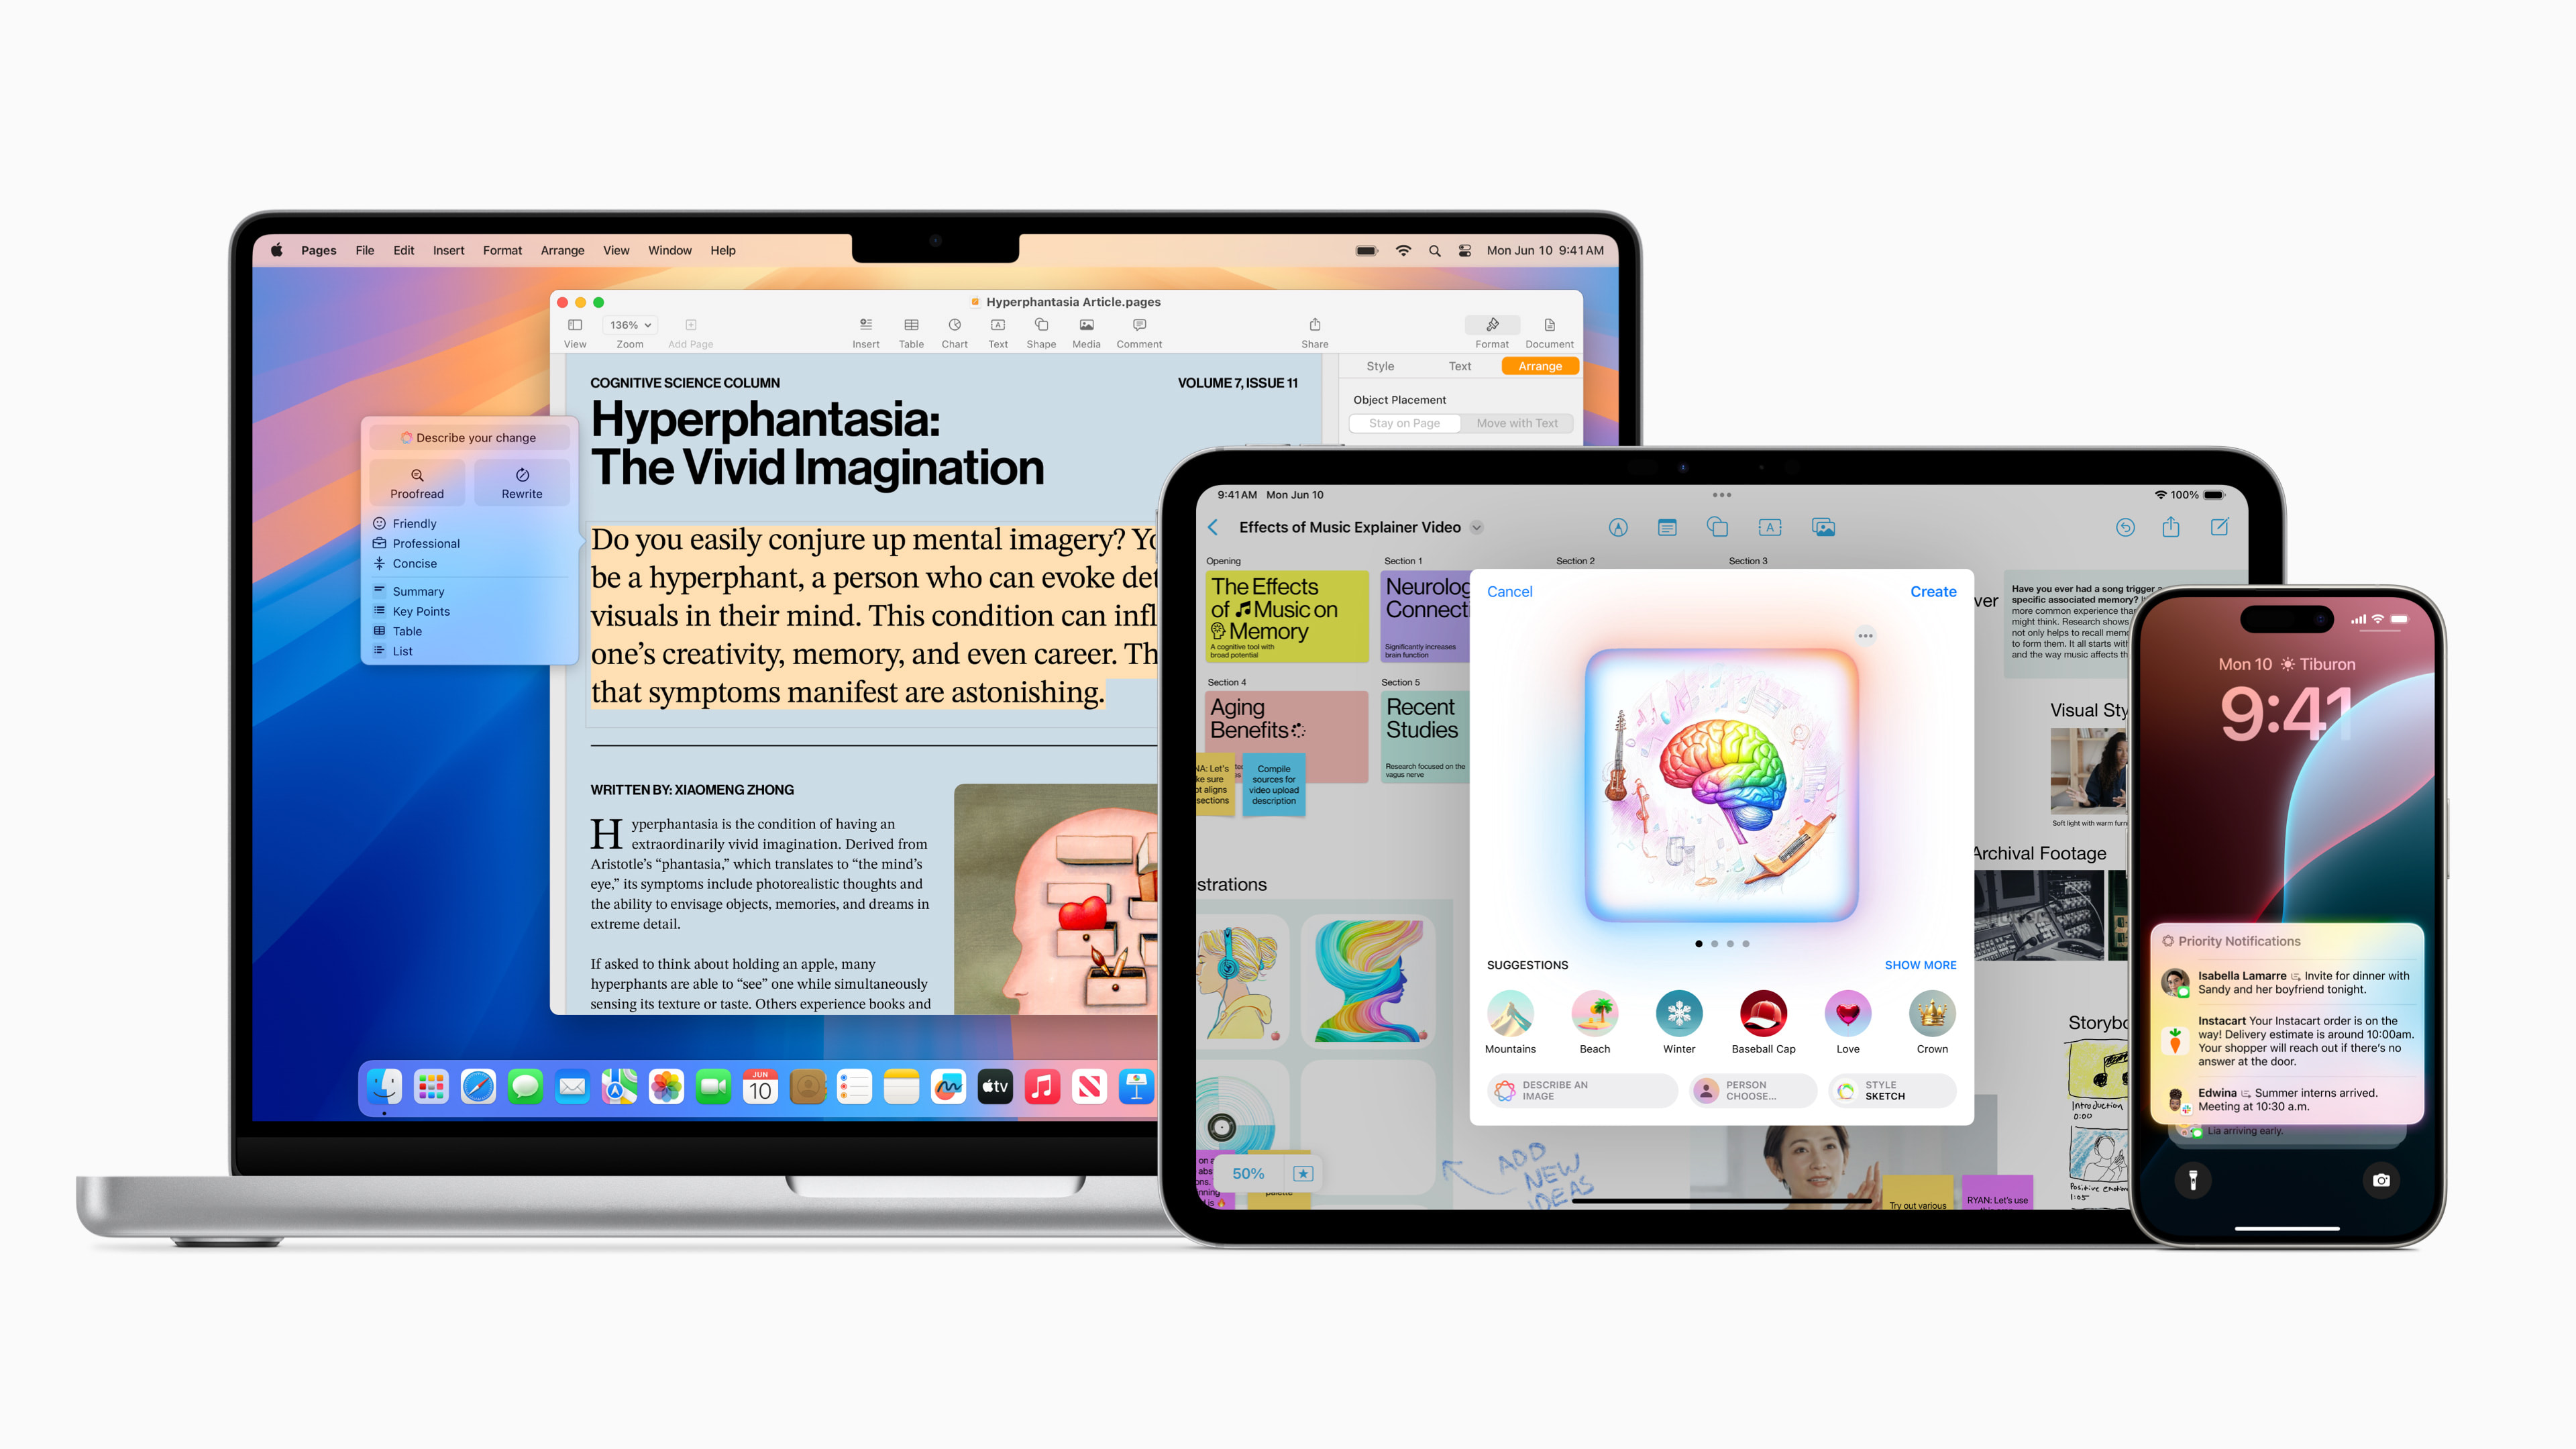
Apple aunque confirmó que efectivamente había utilizado este conjunto de subtítulos de YouTube descargados por la startup para entrenar sus modelos OpenELM de código abierto, que están disponibles gratuitamente en Internet, no tenía idea de que se trataba de datos obtenidos de esta manera, y que ¿No usó la solución de código abierto para nada más que para capacitación? Y dado que OpenELM se creó, según sus propias palabras, como una forma de contribuir al progreso de la comunidad investigadora en el campo de la IA y, en general, para avanzar en el desarrollo de un gran modelo de lenguaje de código abierto, el uso de datos de entrenamiento cuyos el origen no fue completamente verificado es algo perdonable.
Galería de fotos
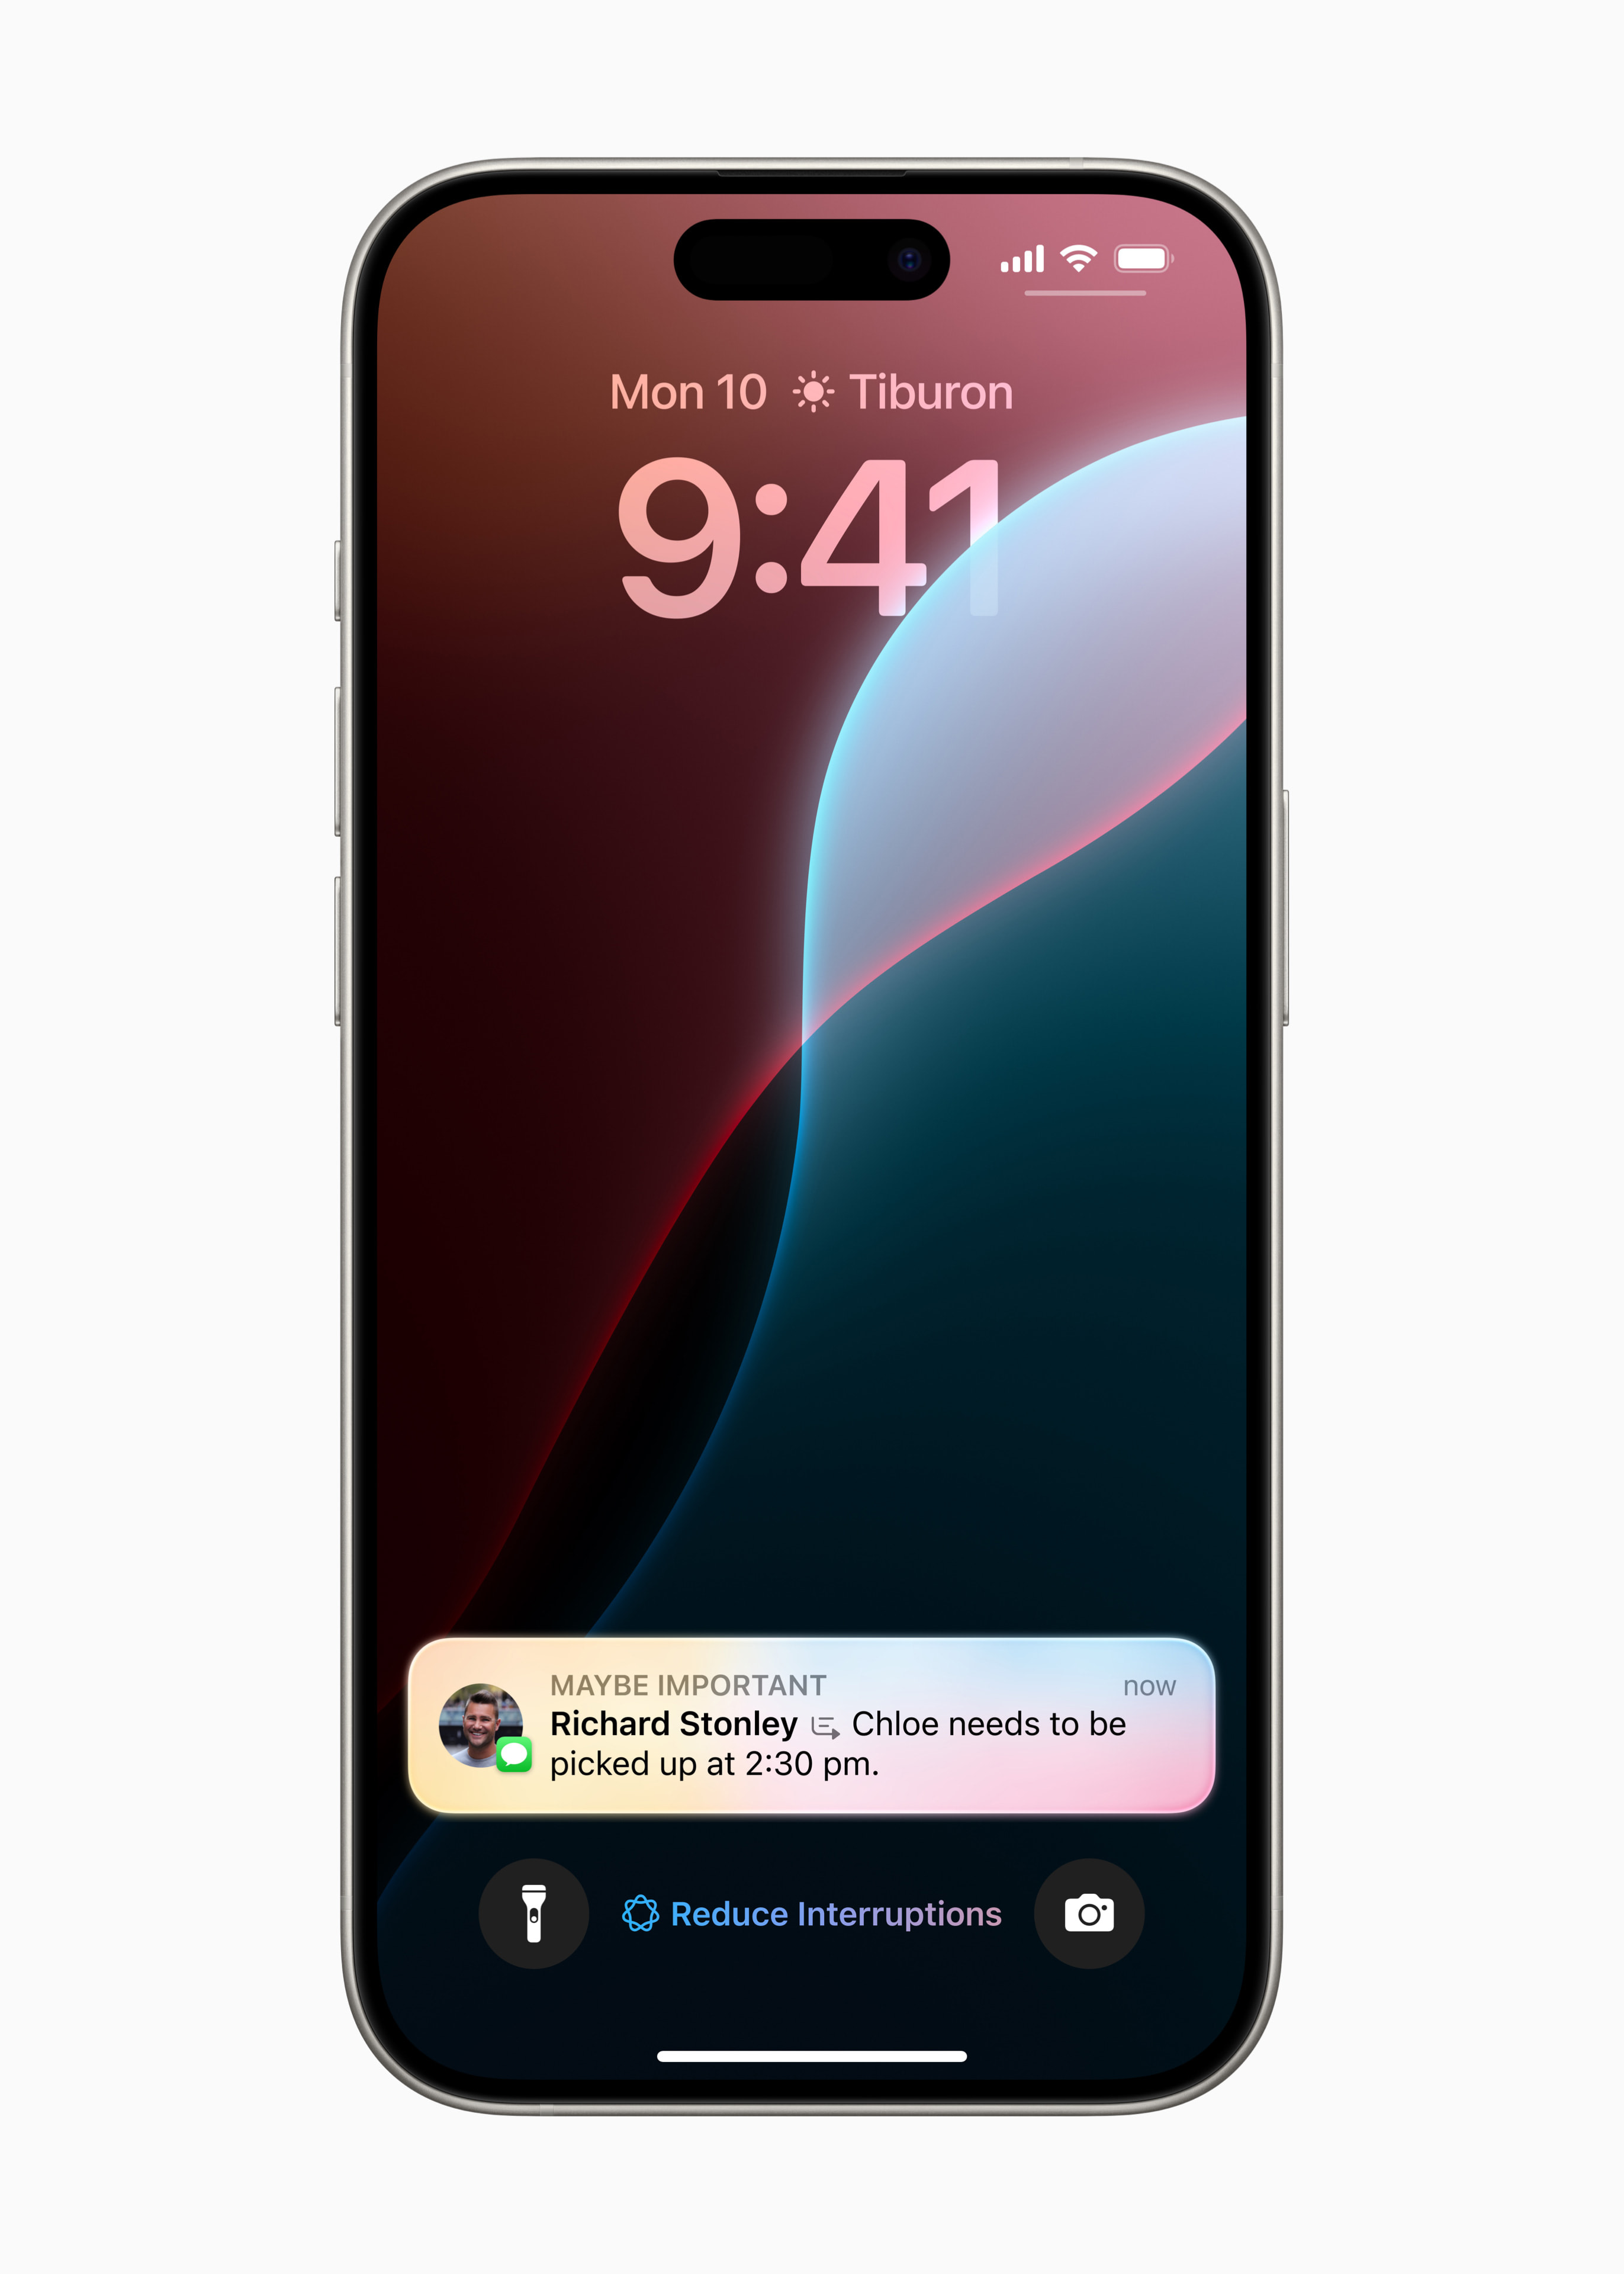
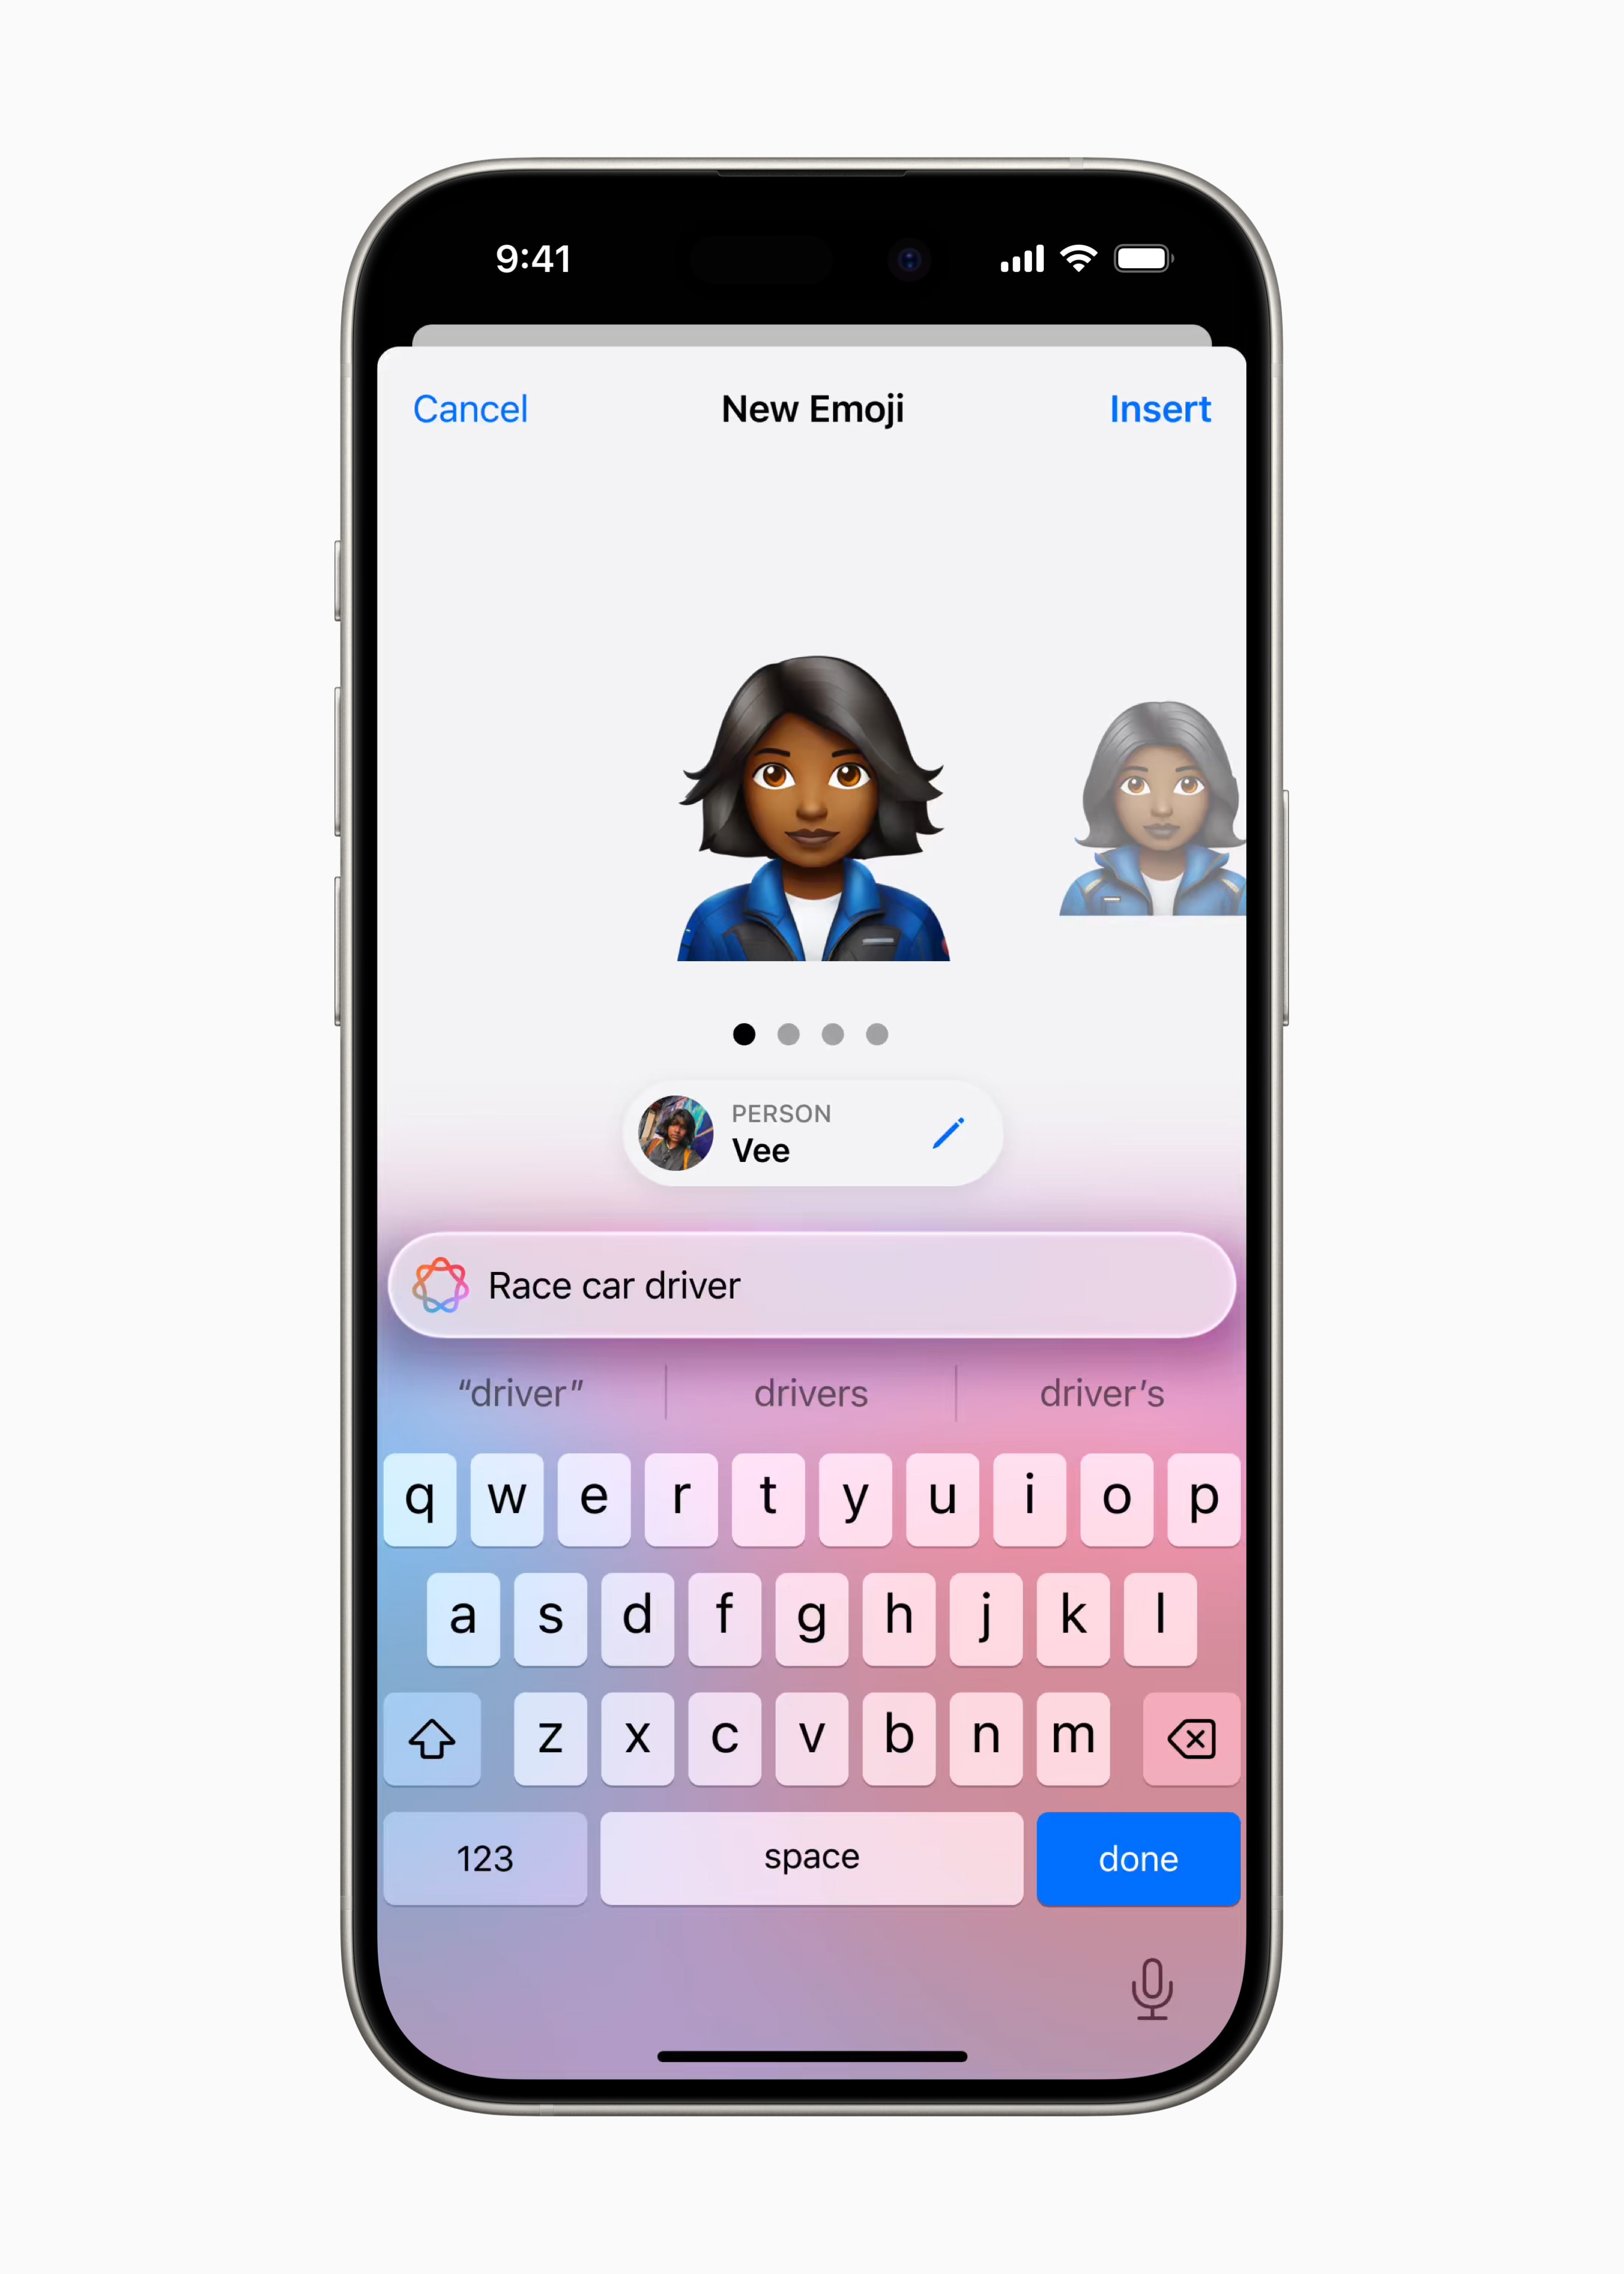
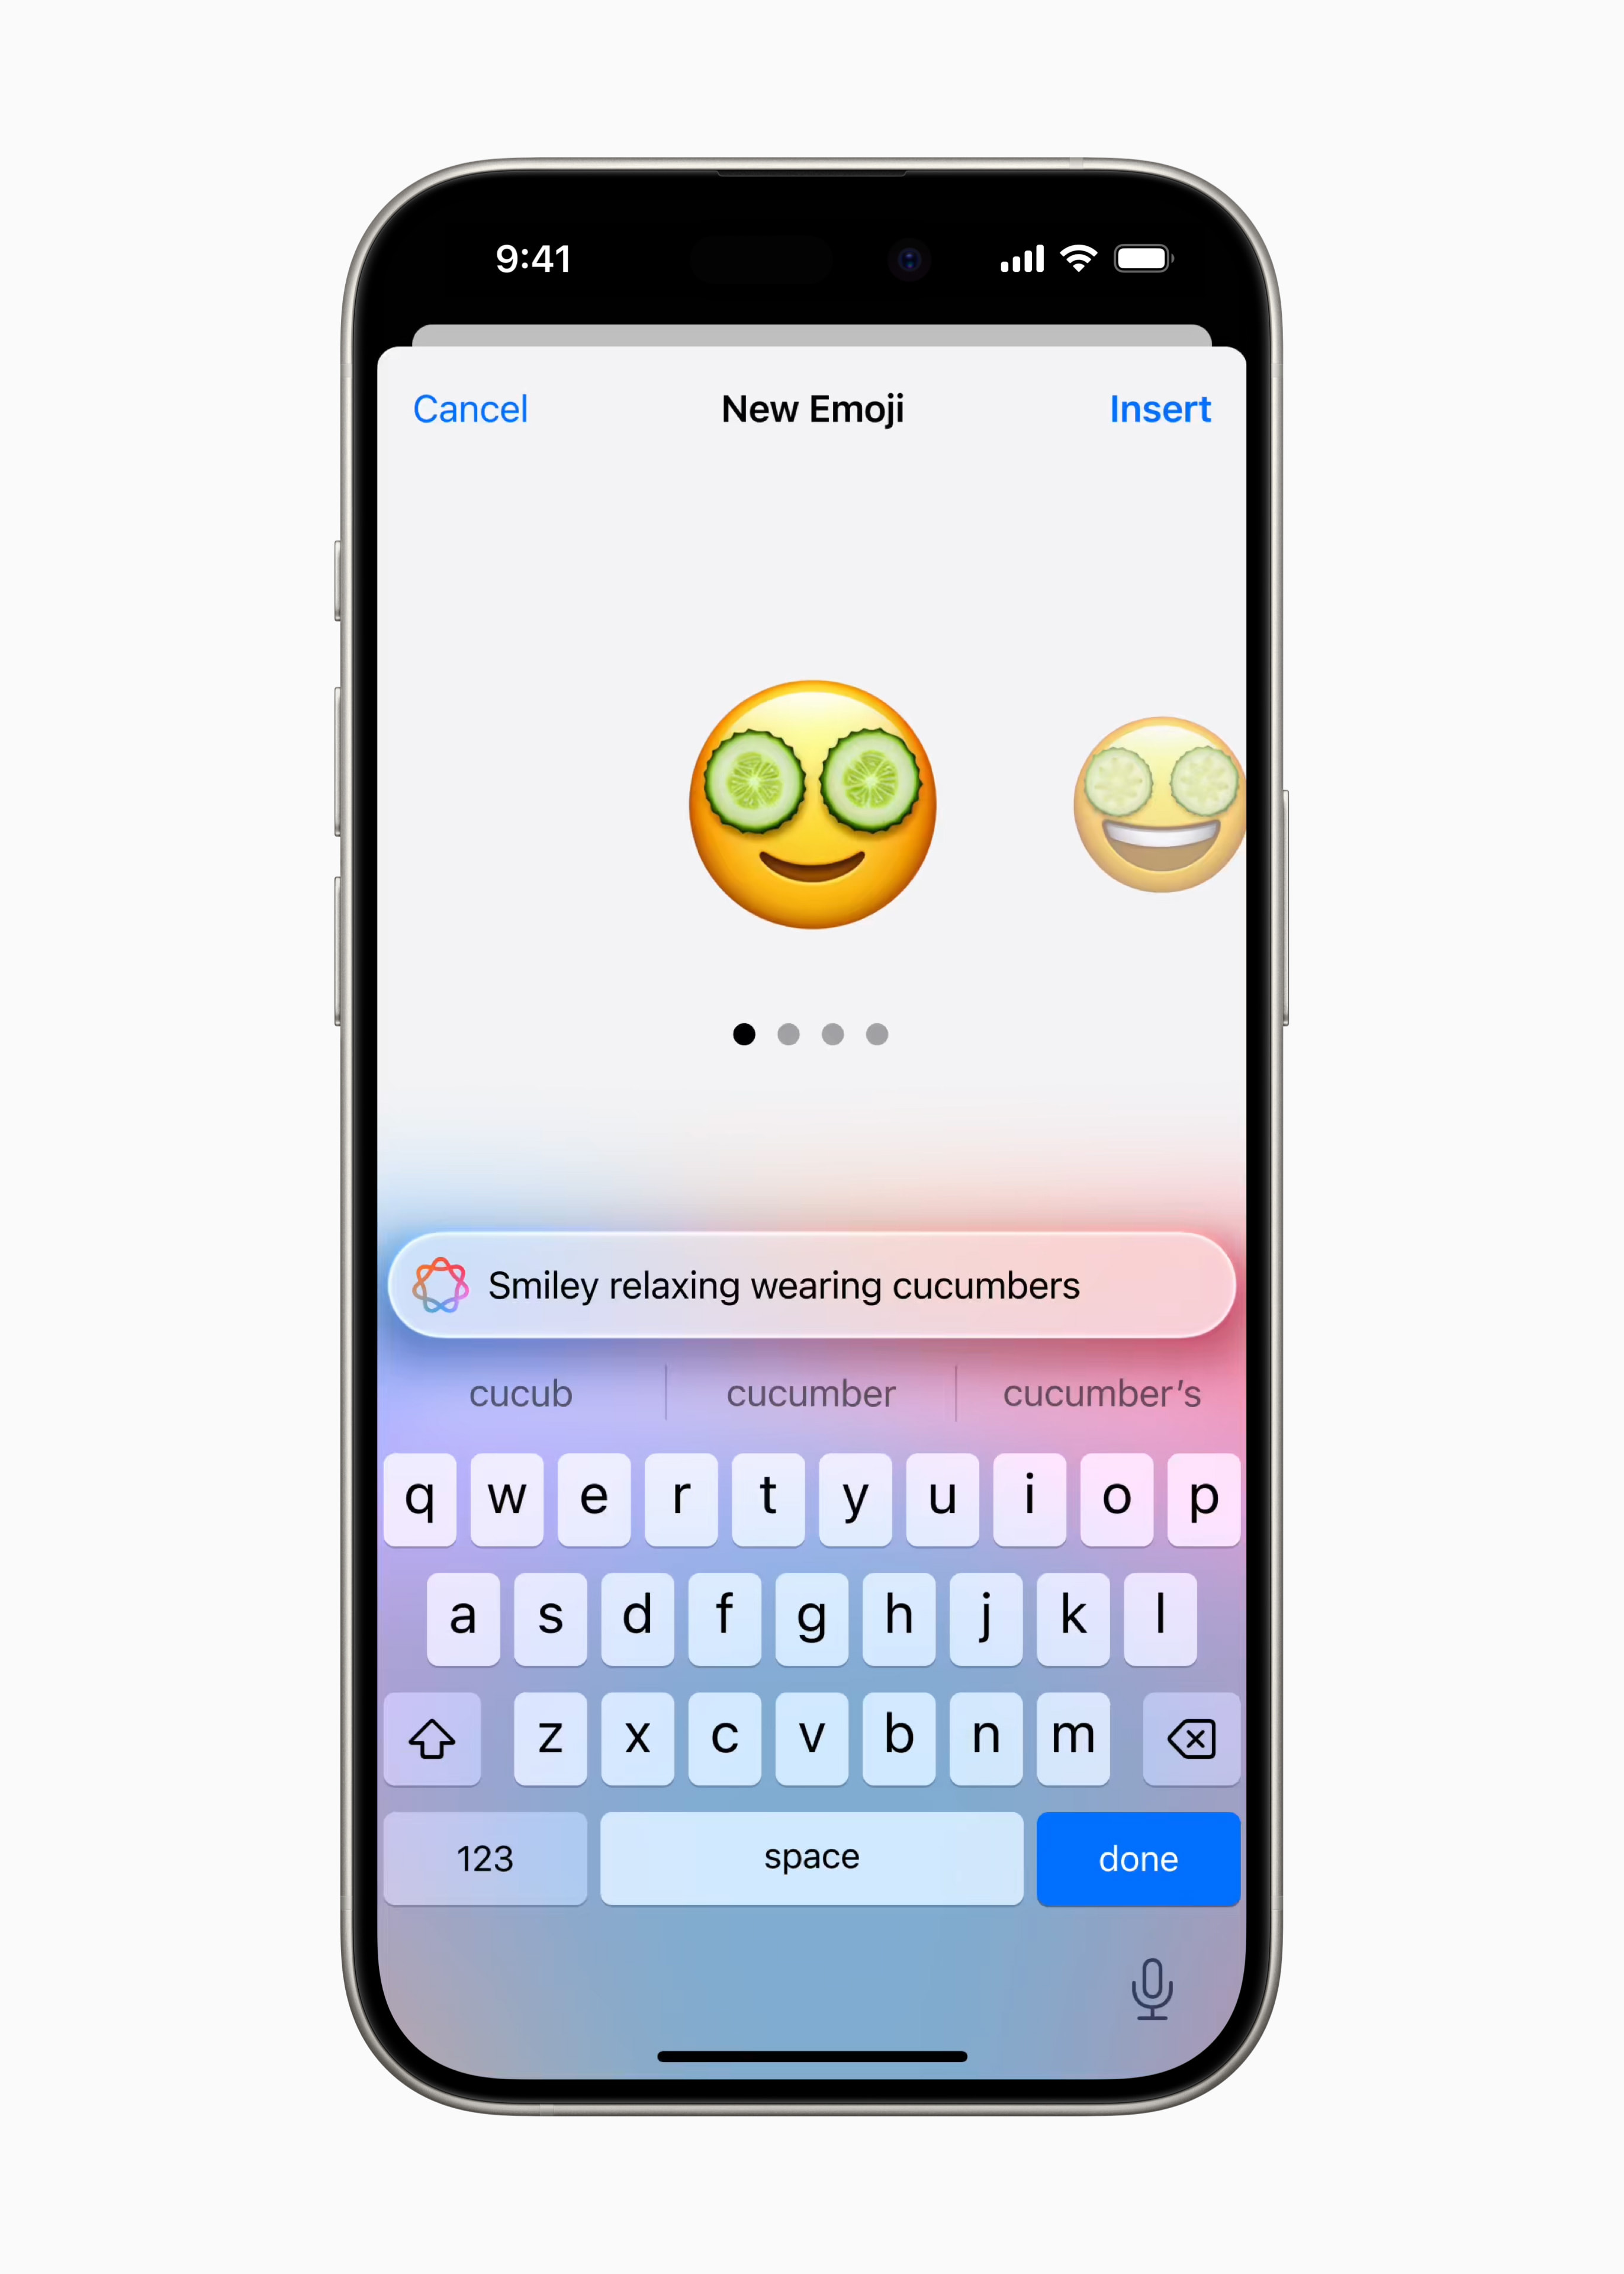
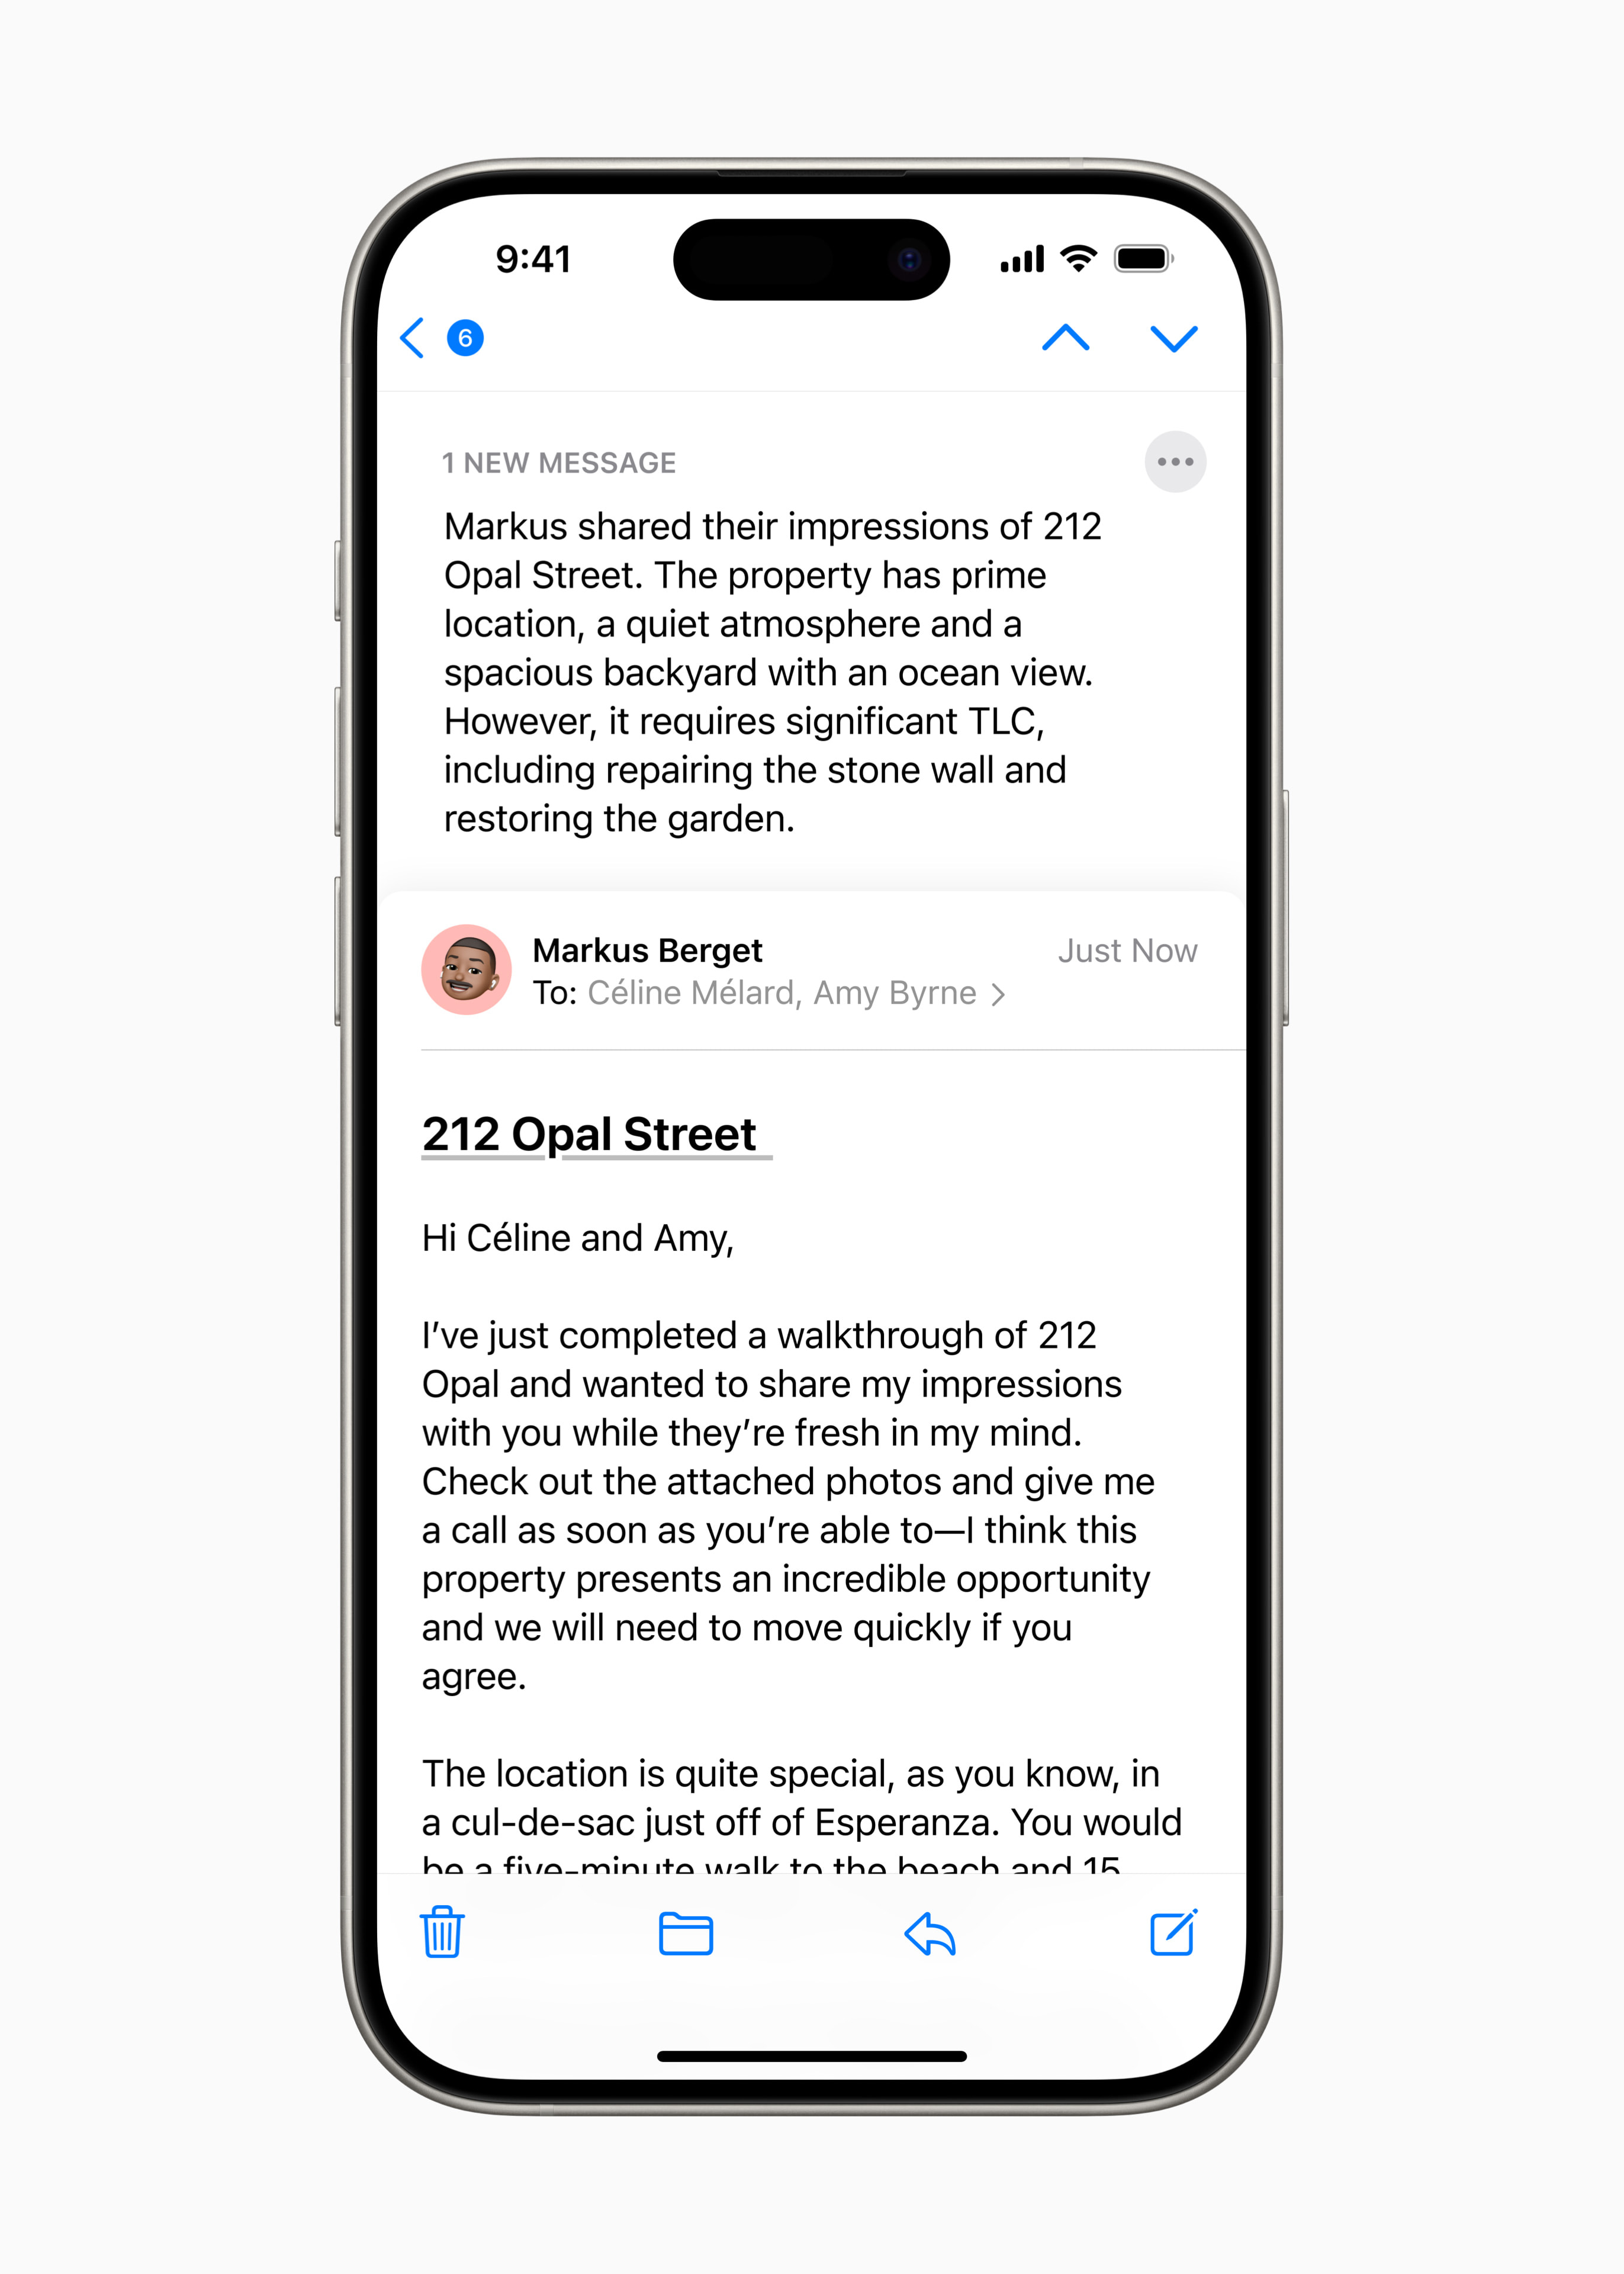
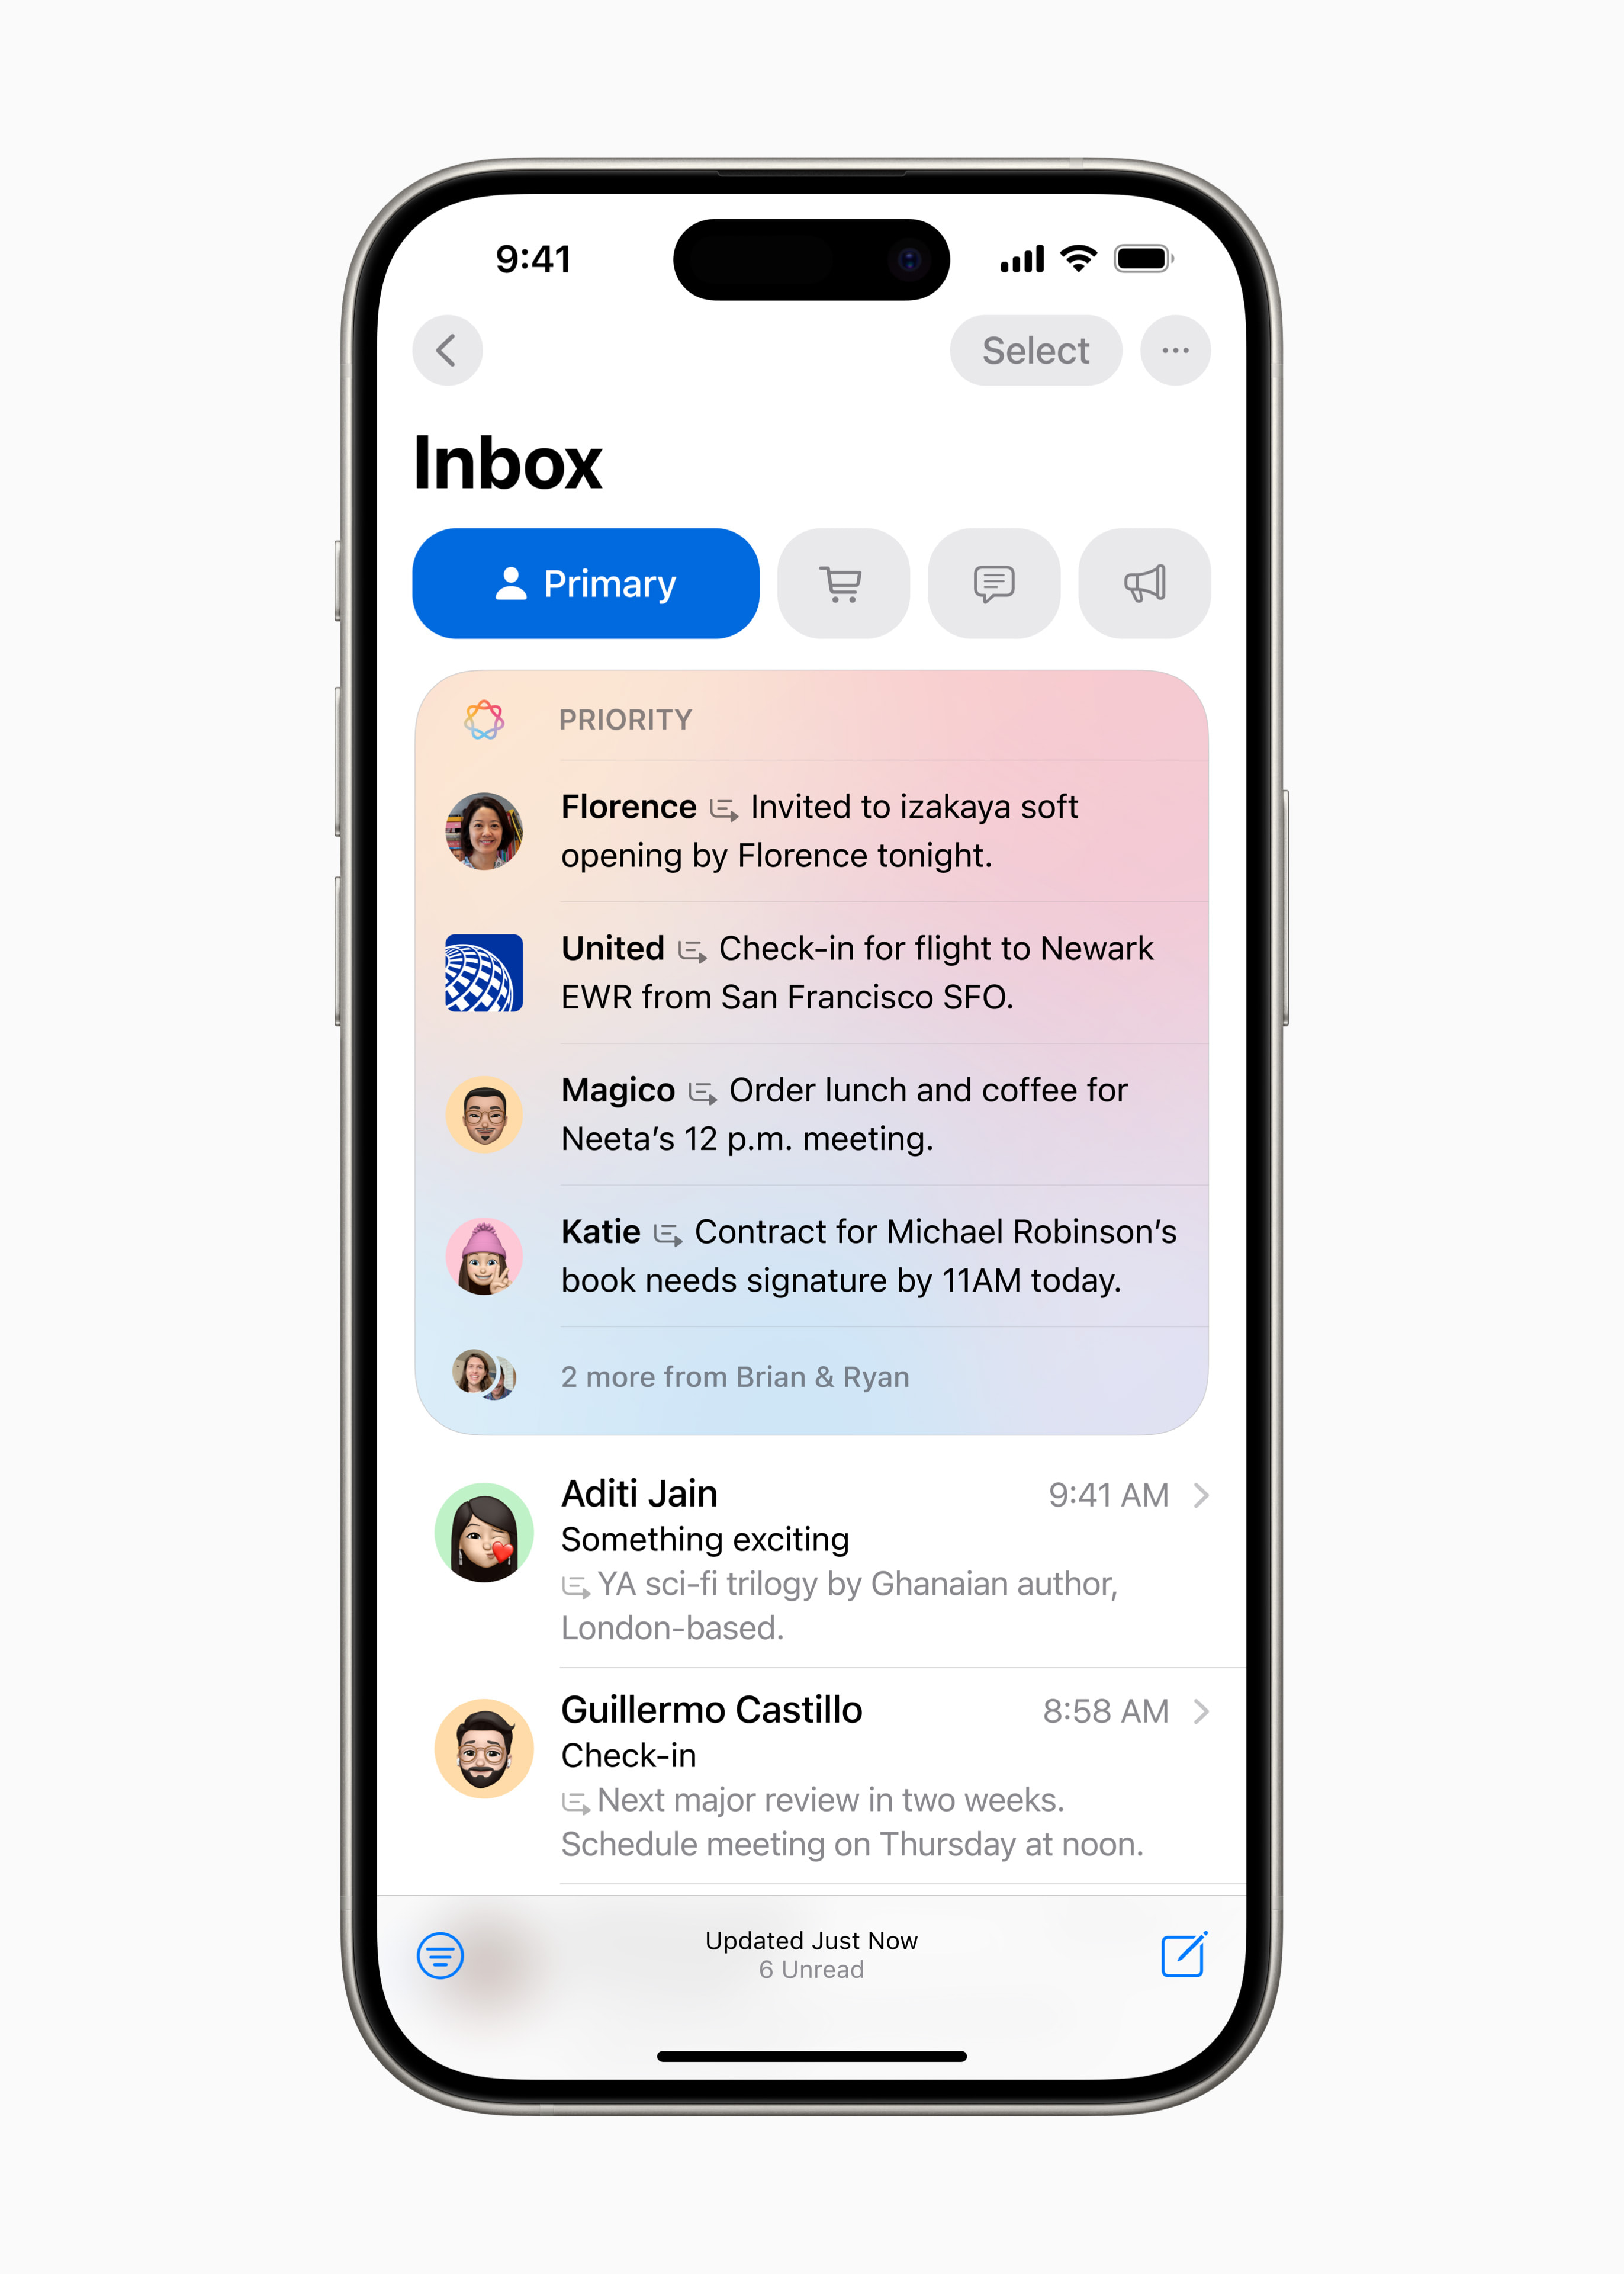
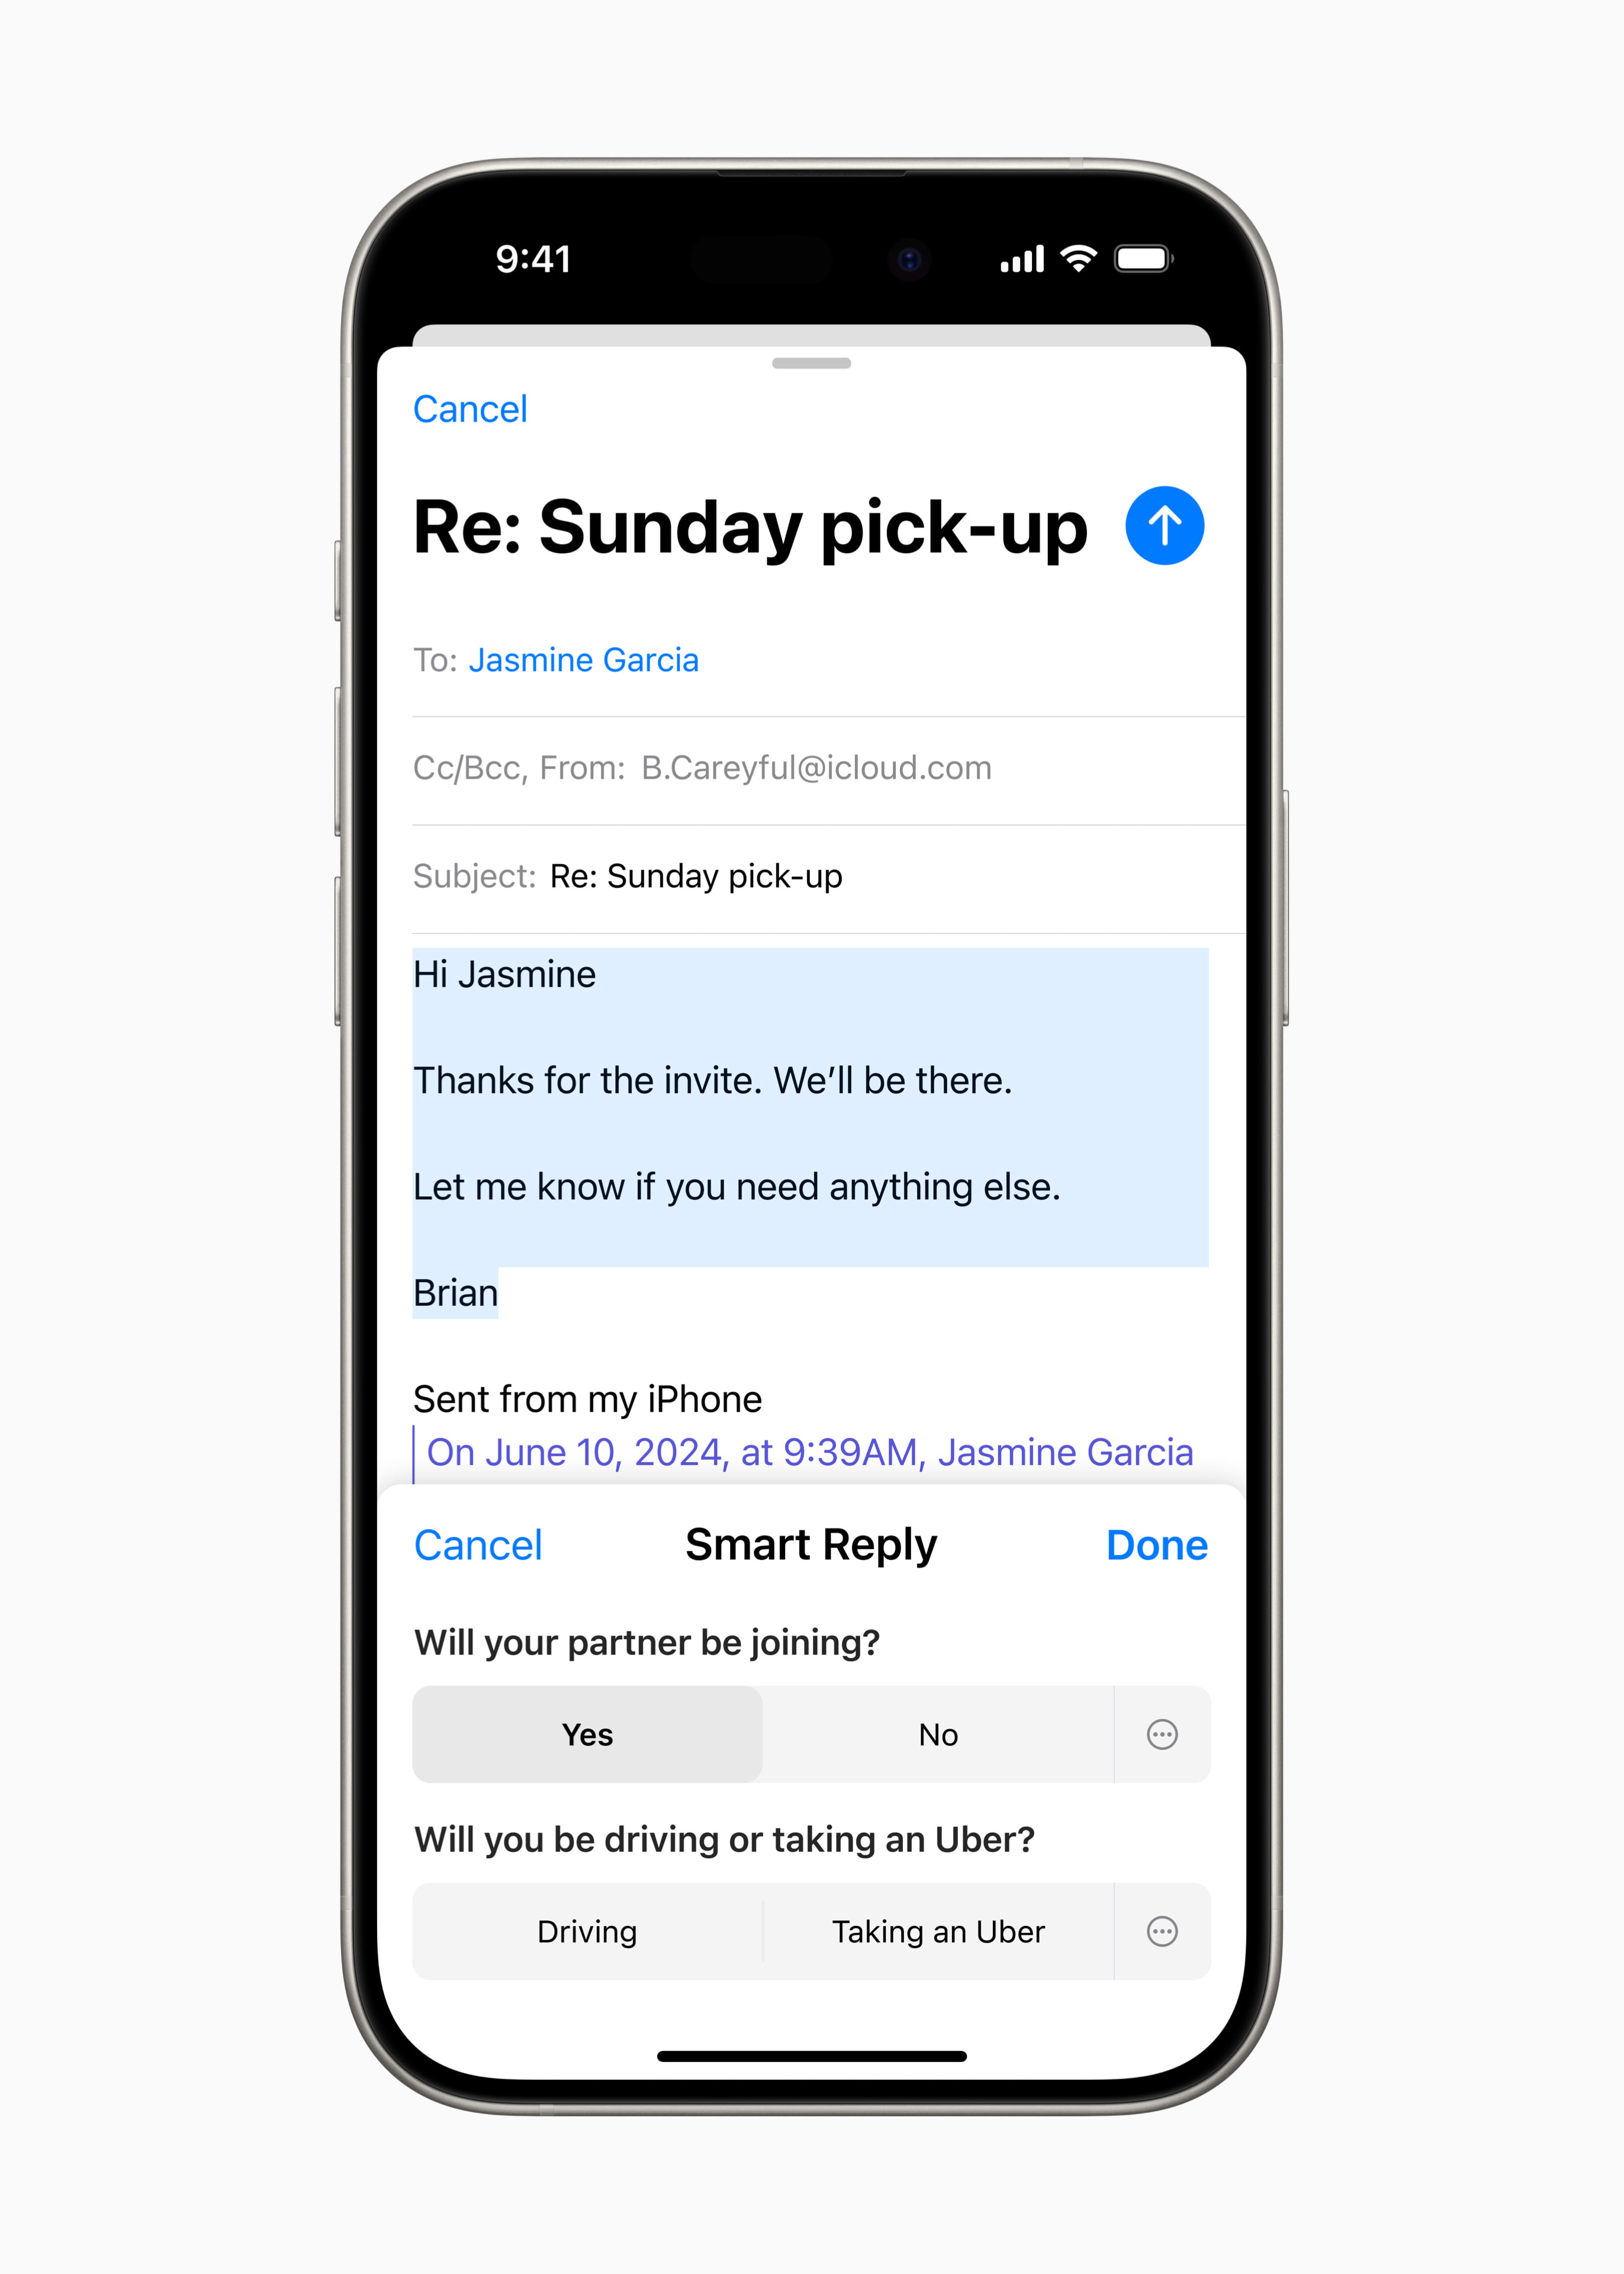
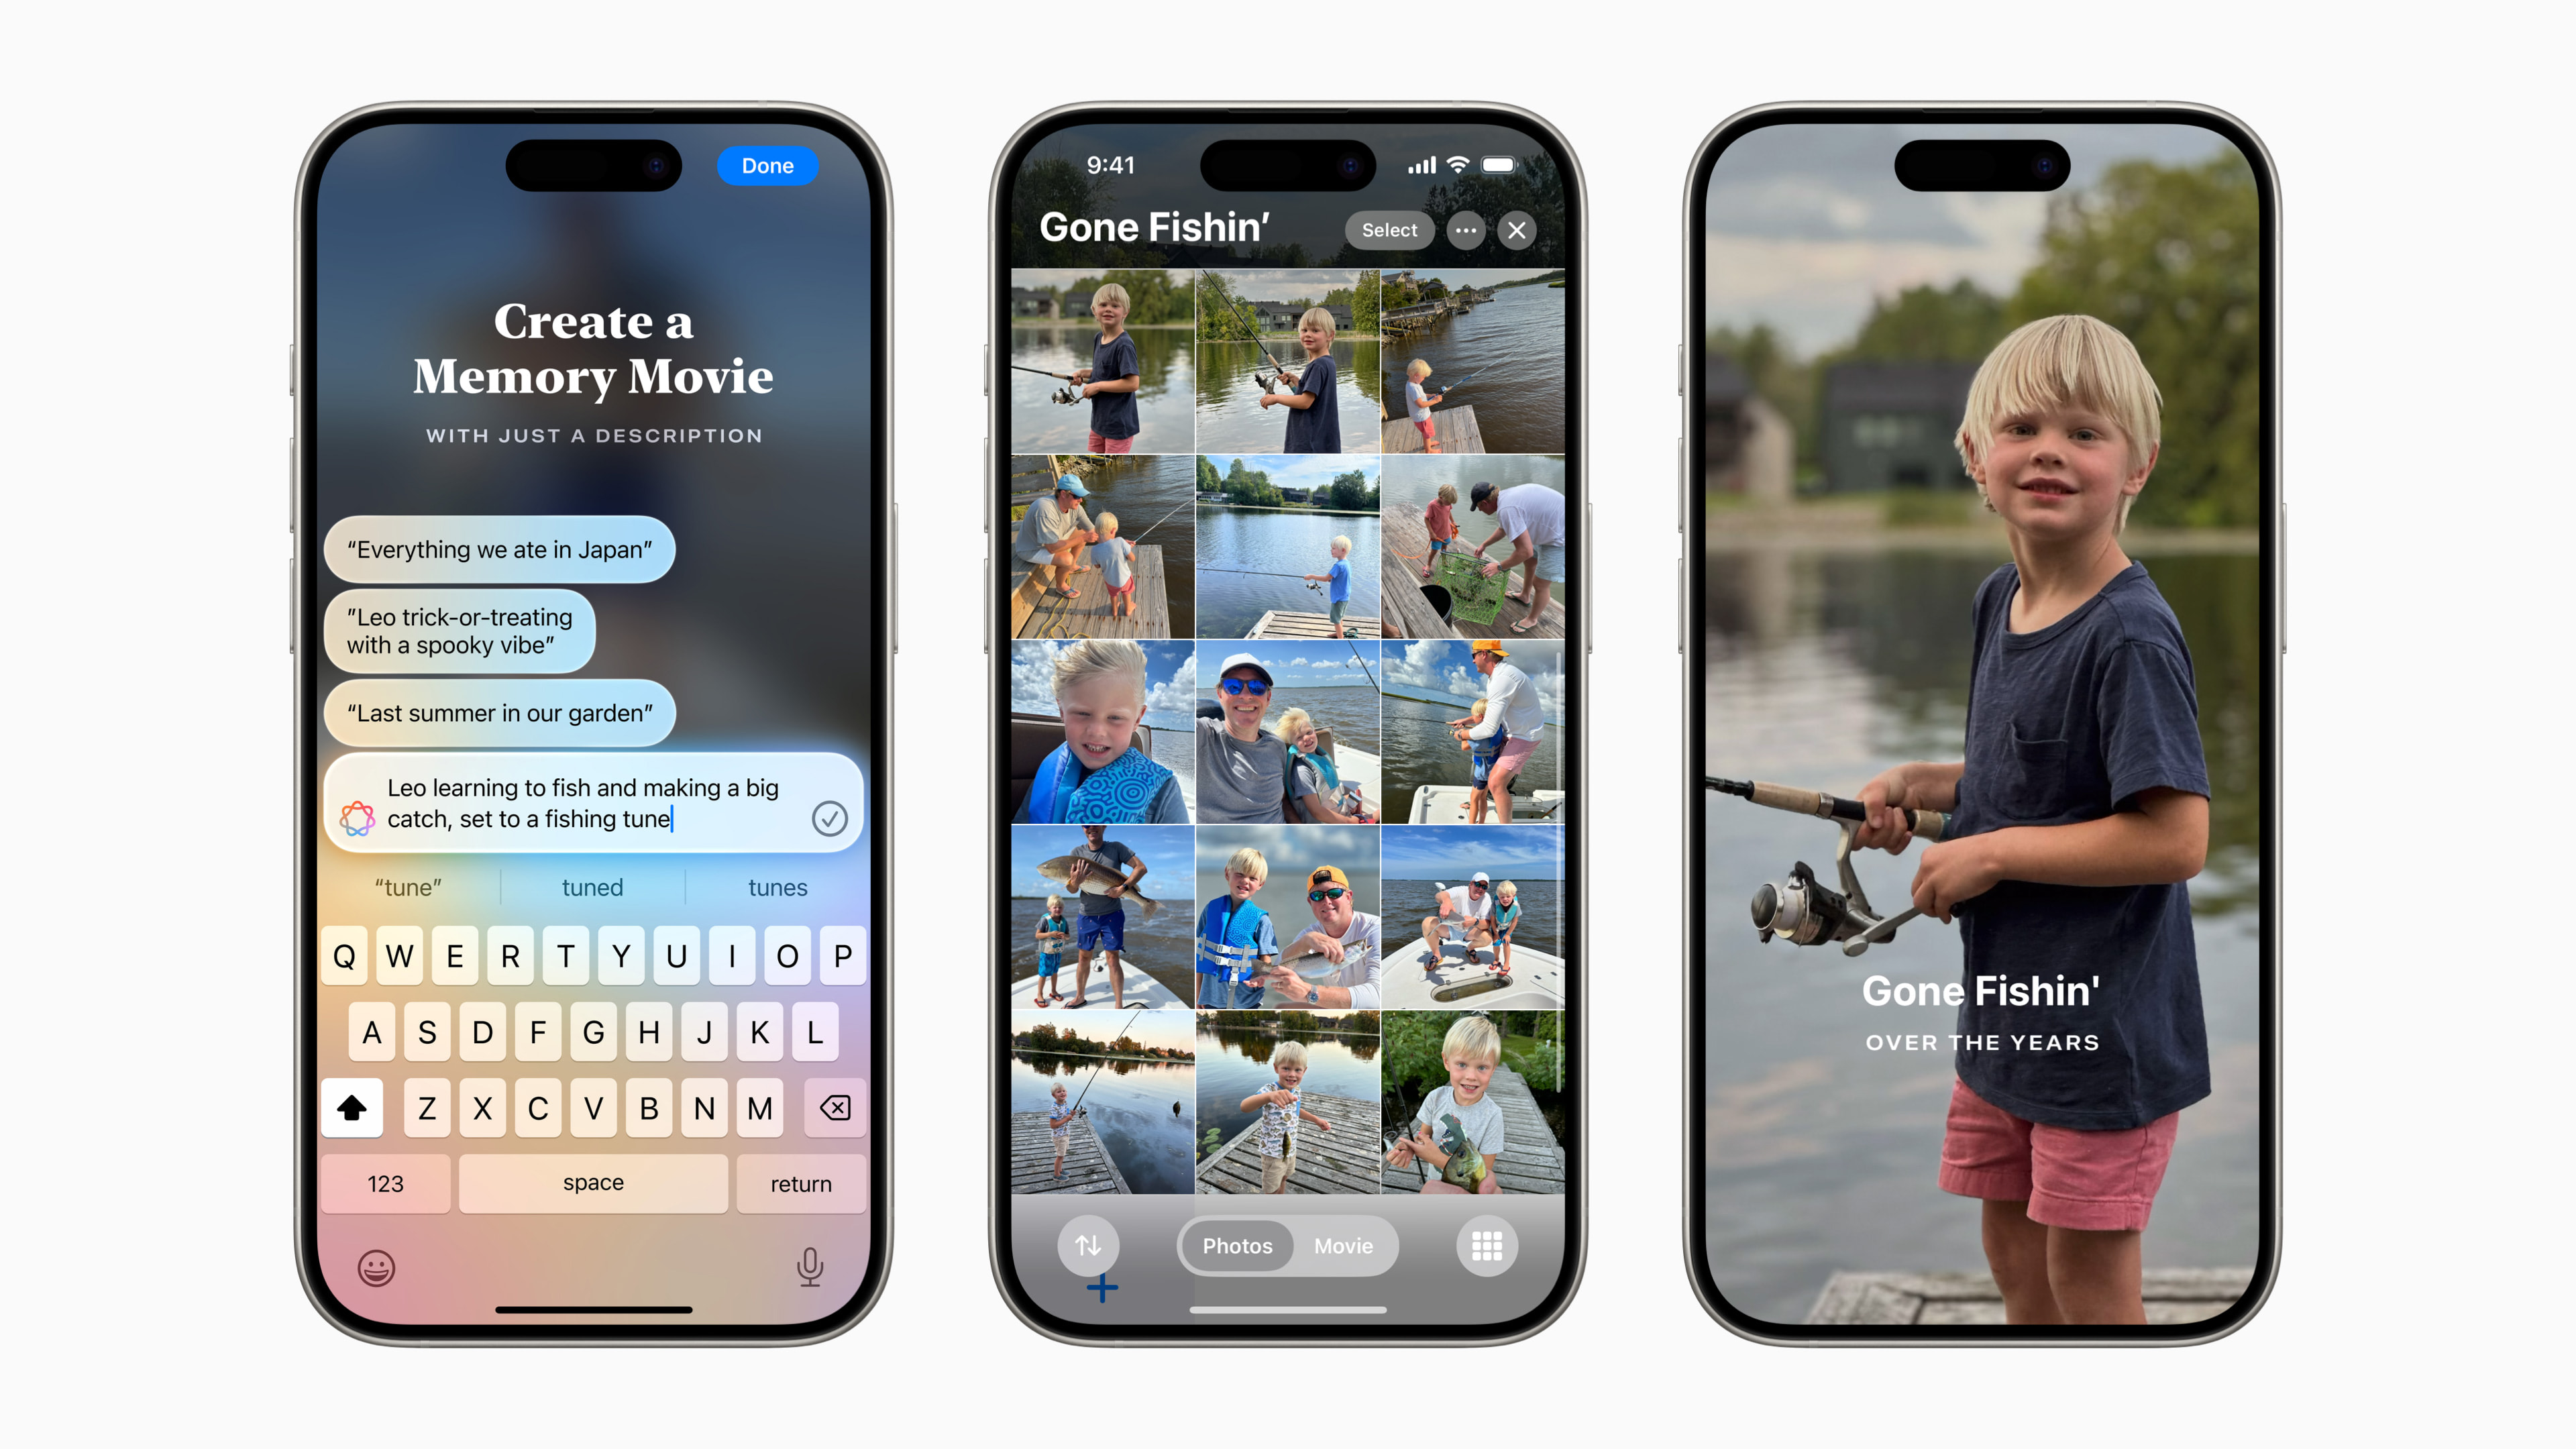
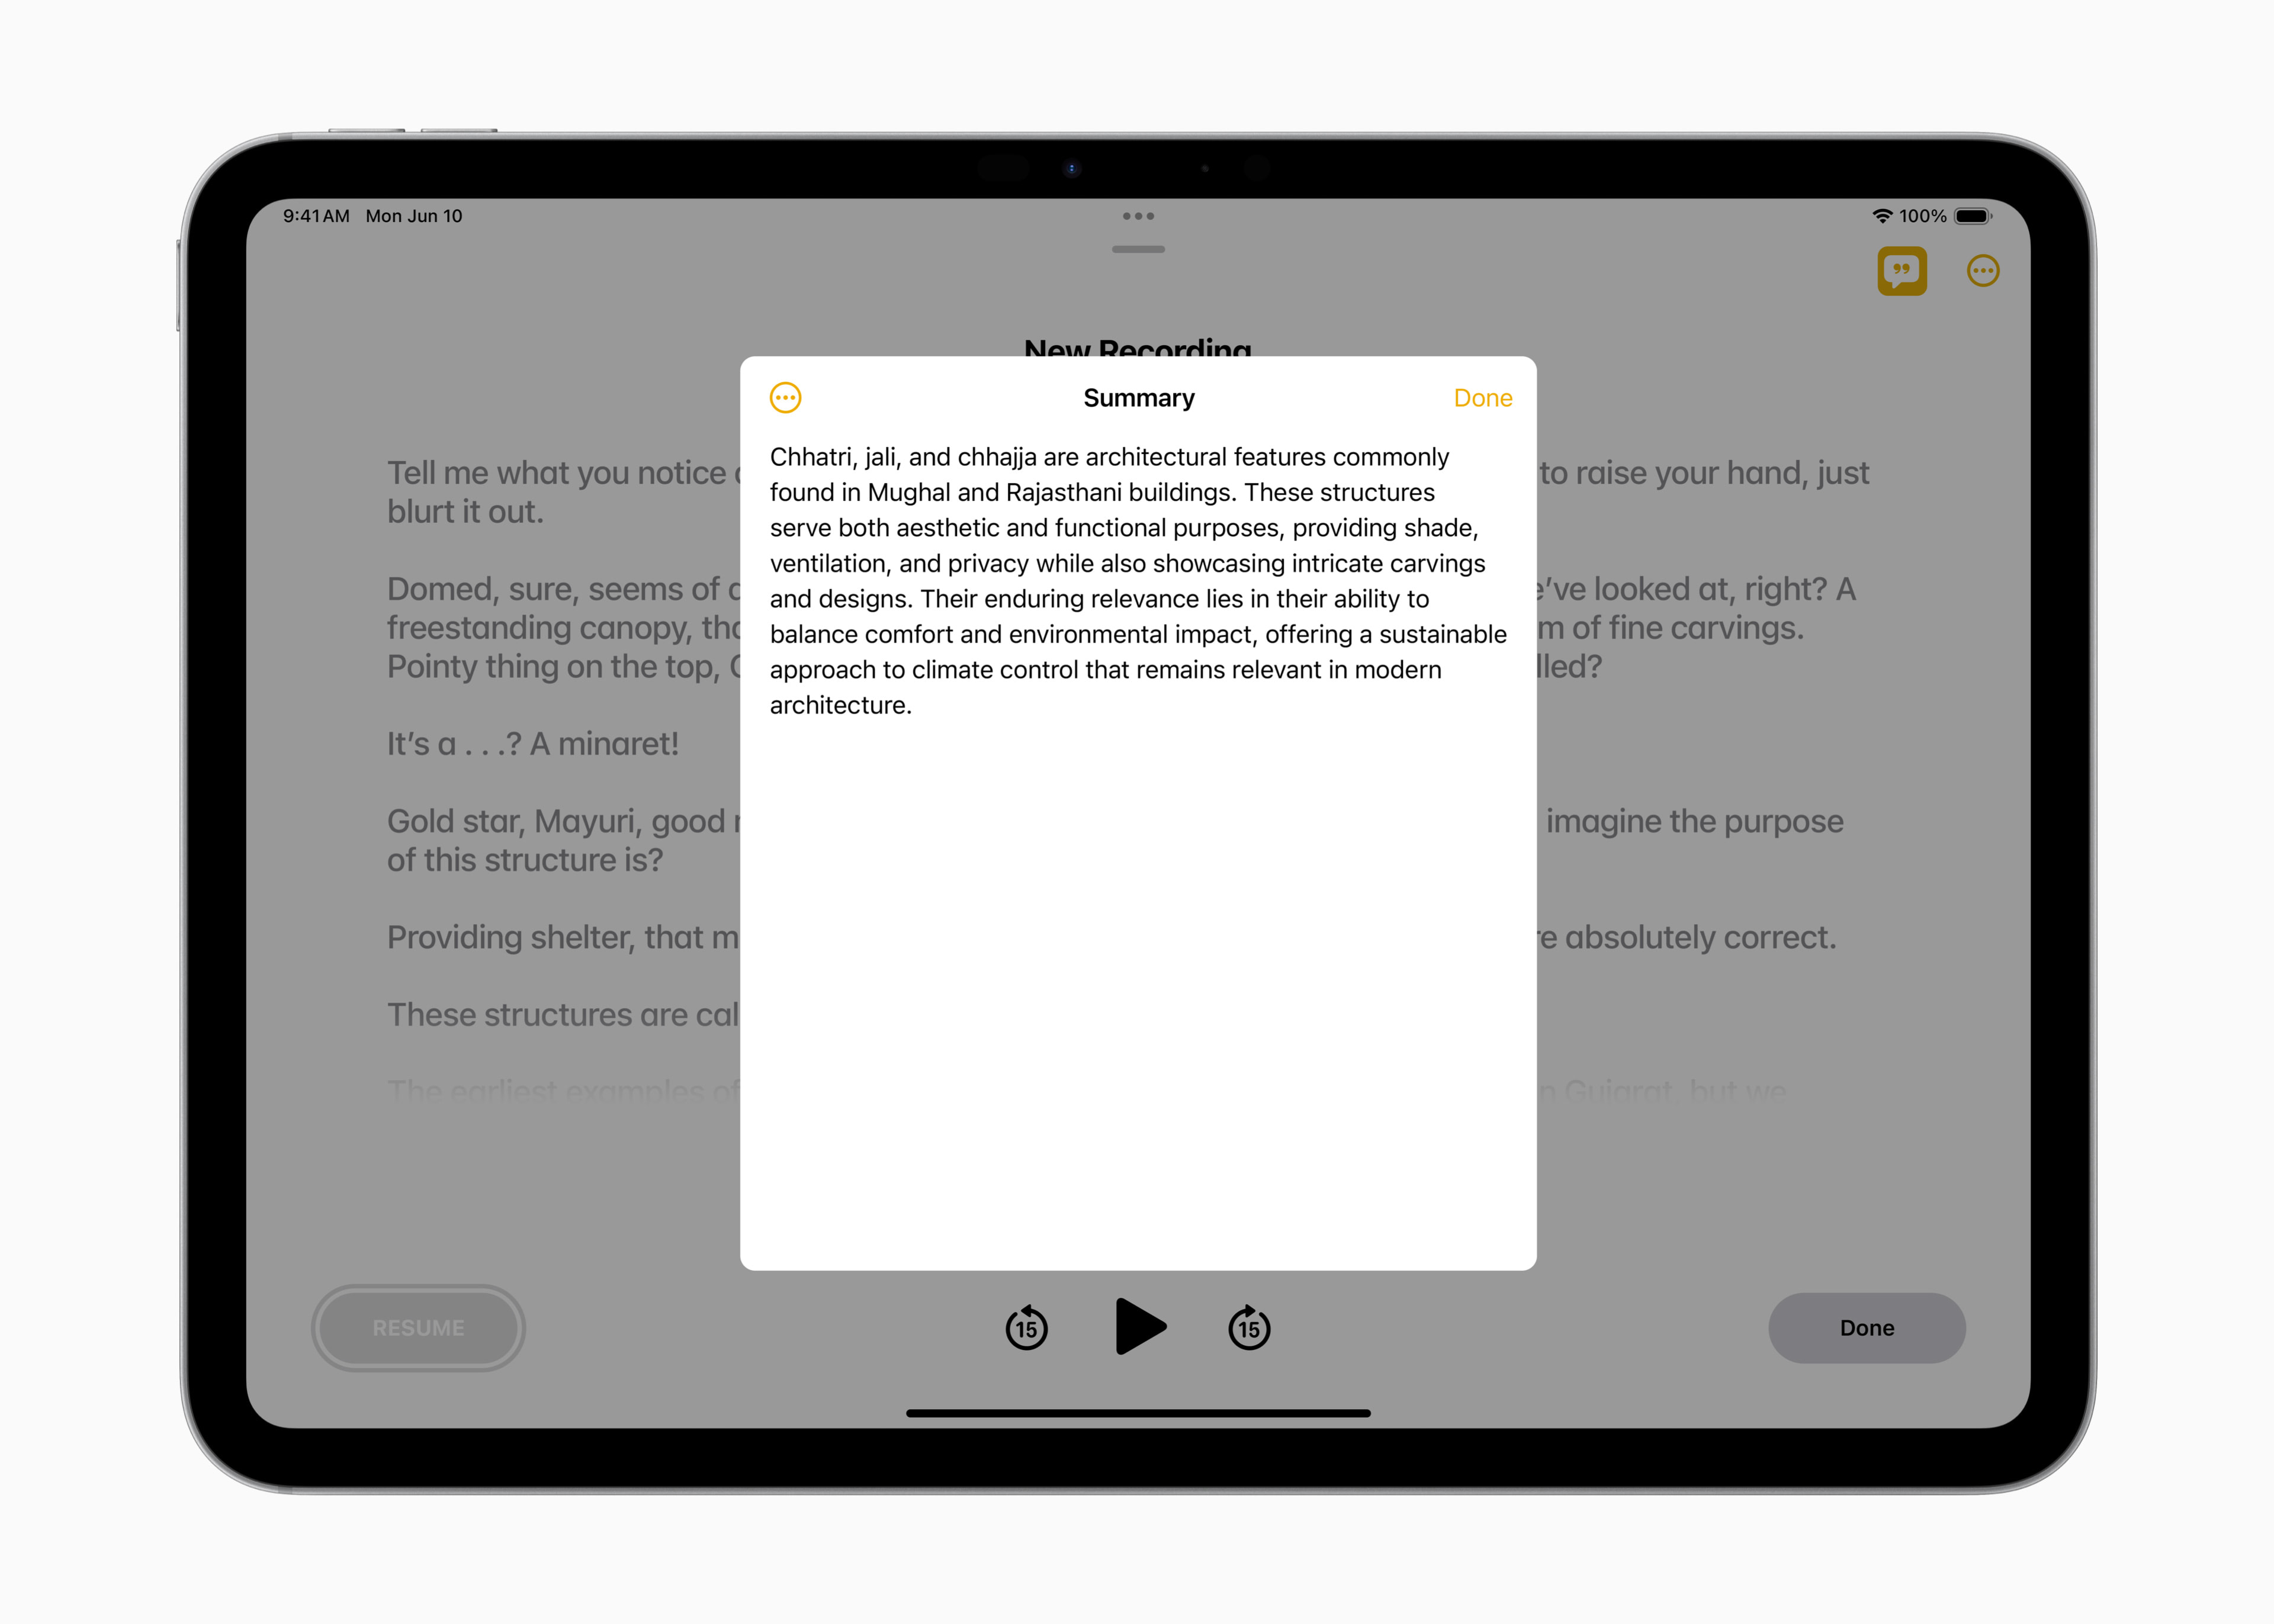
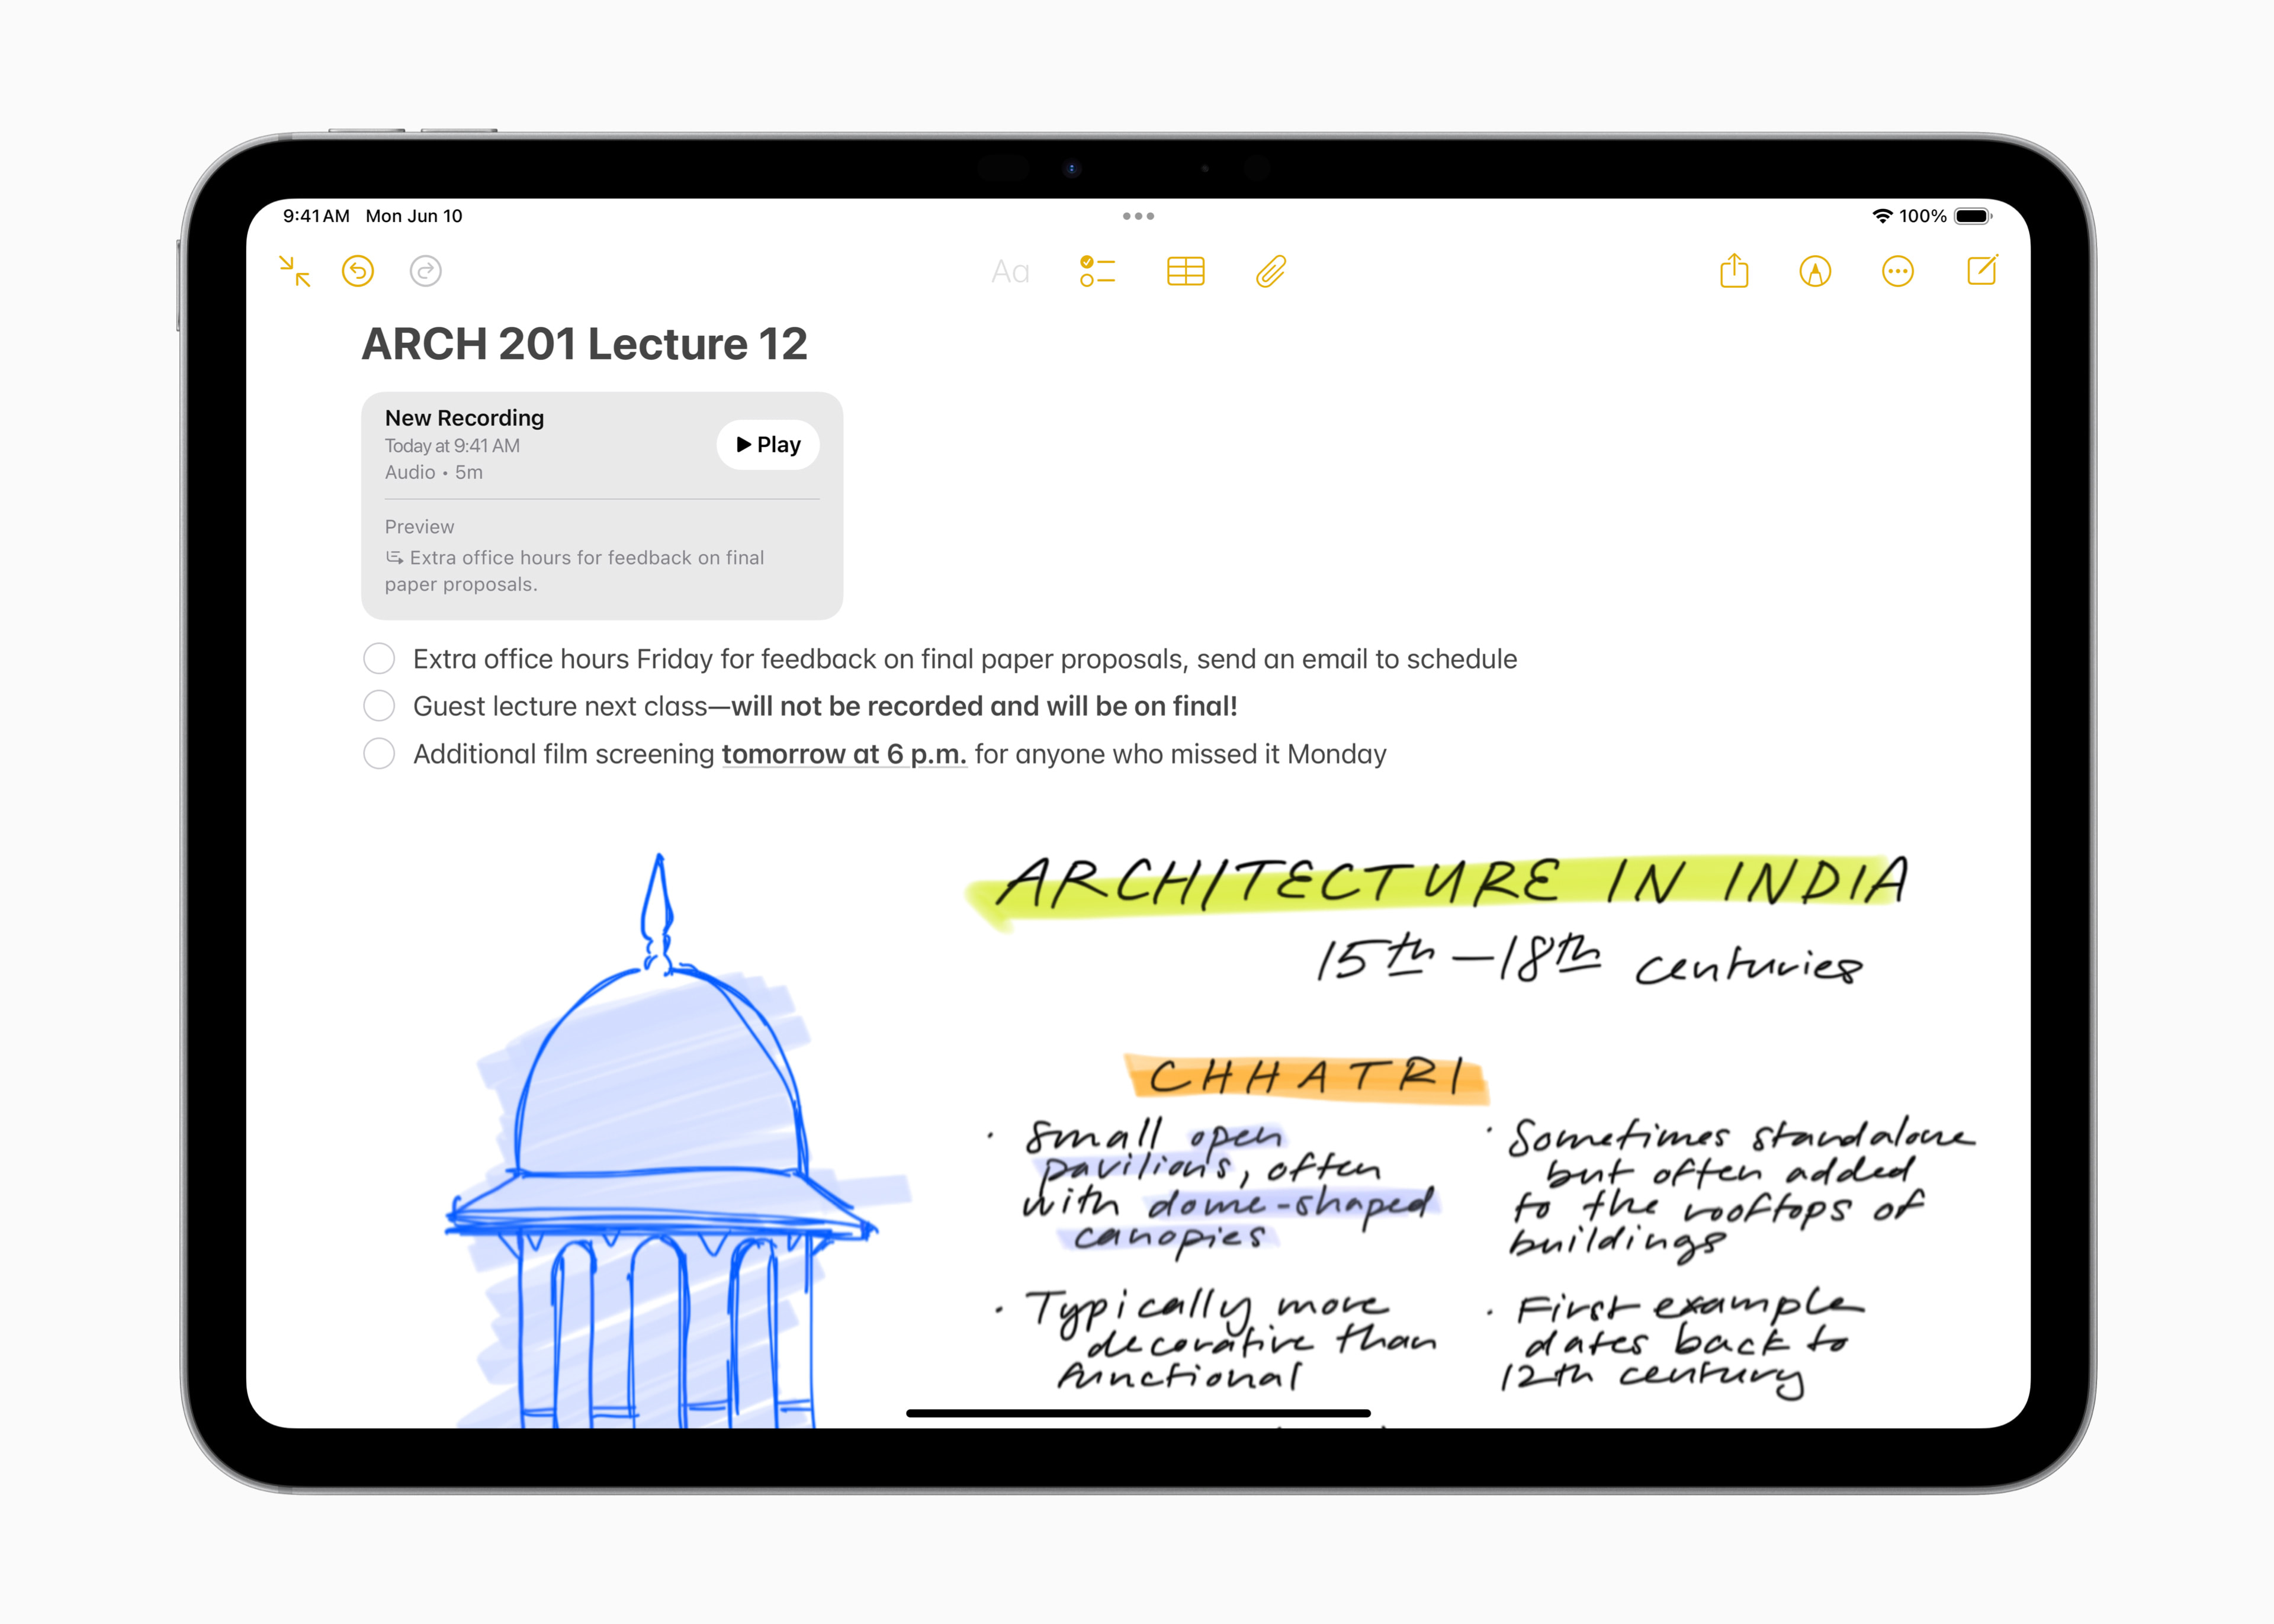
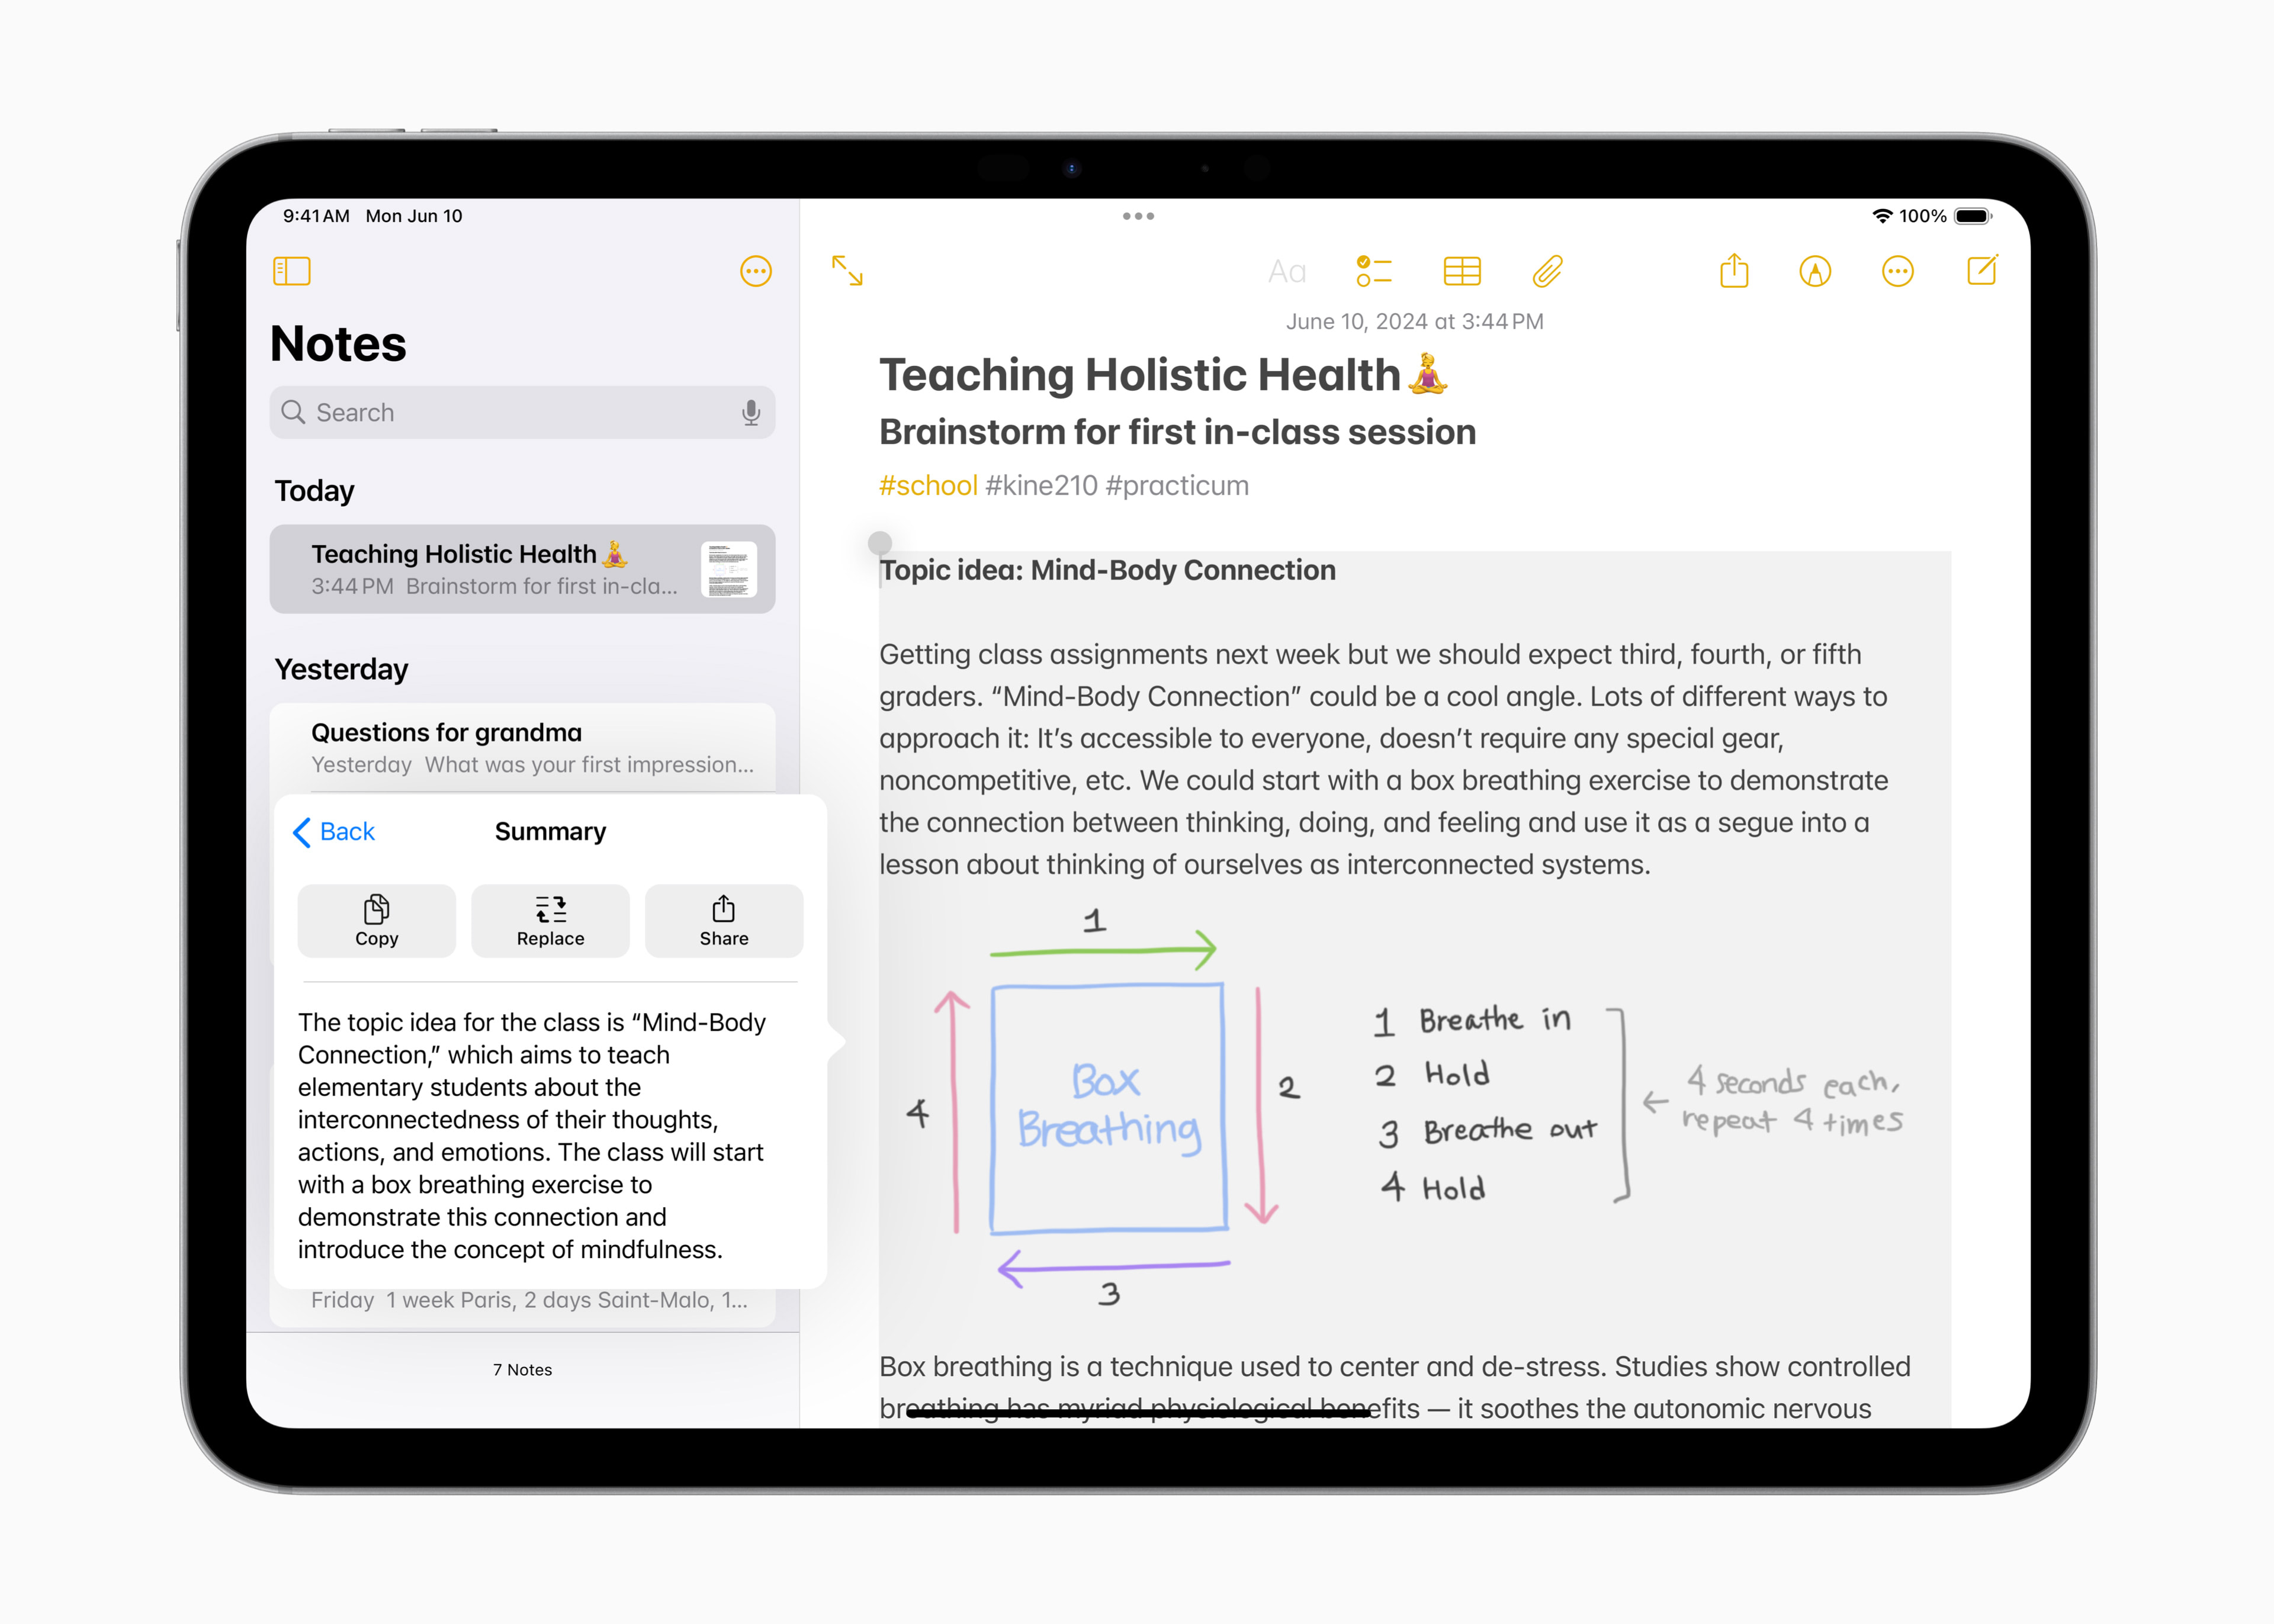
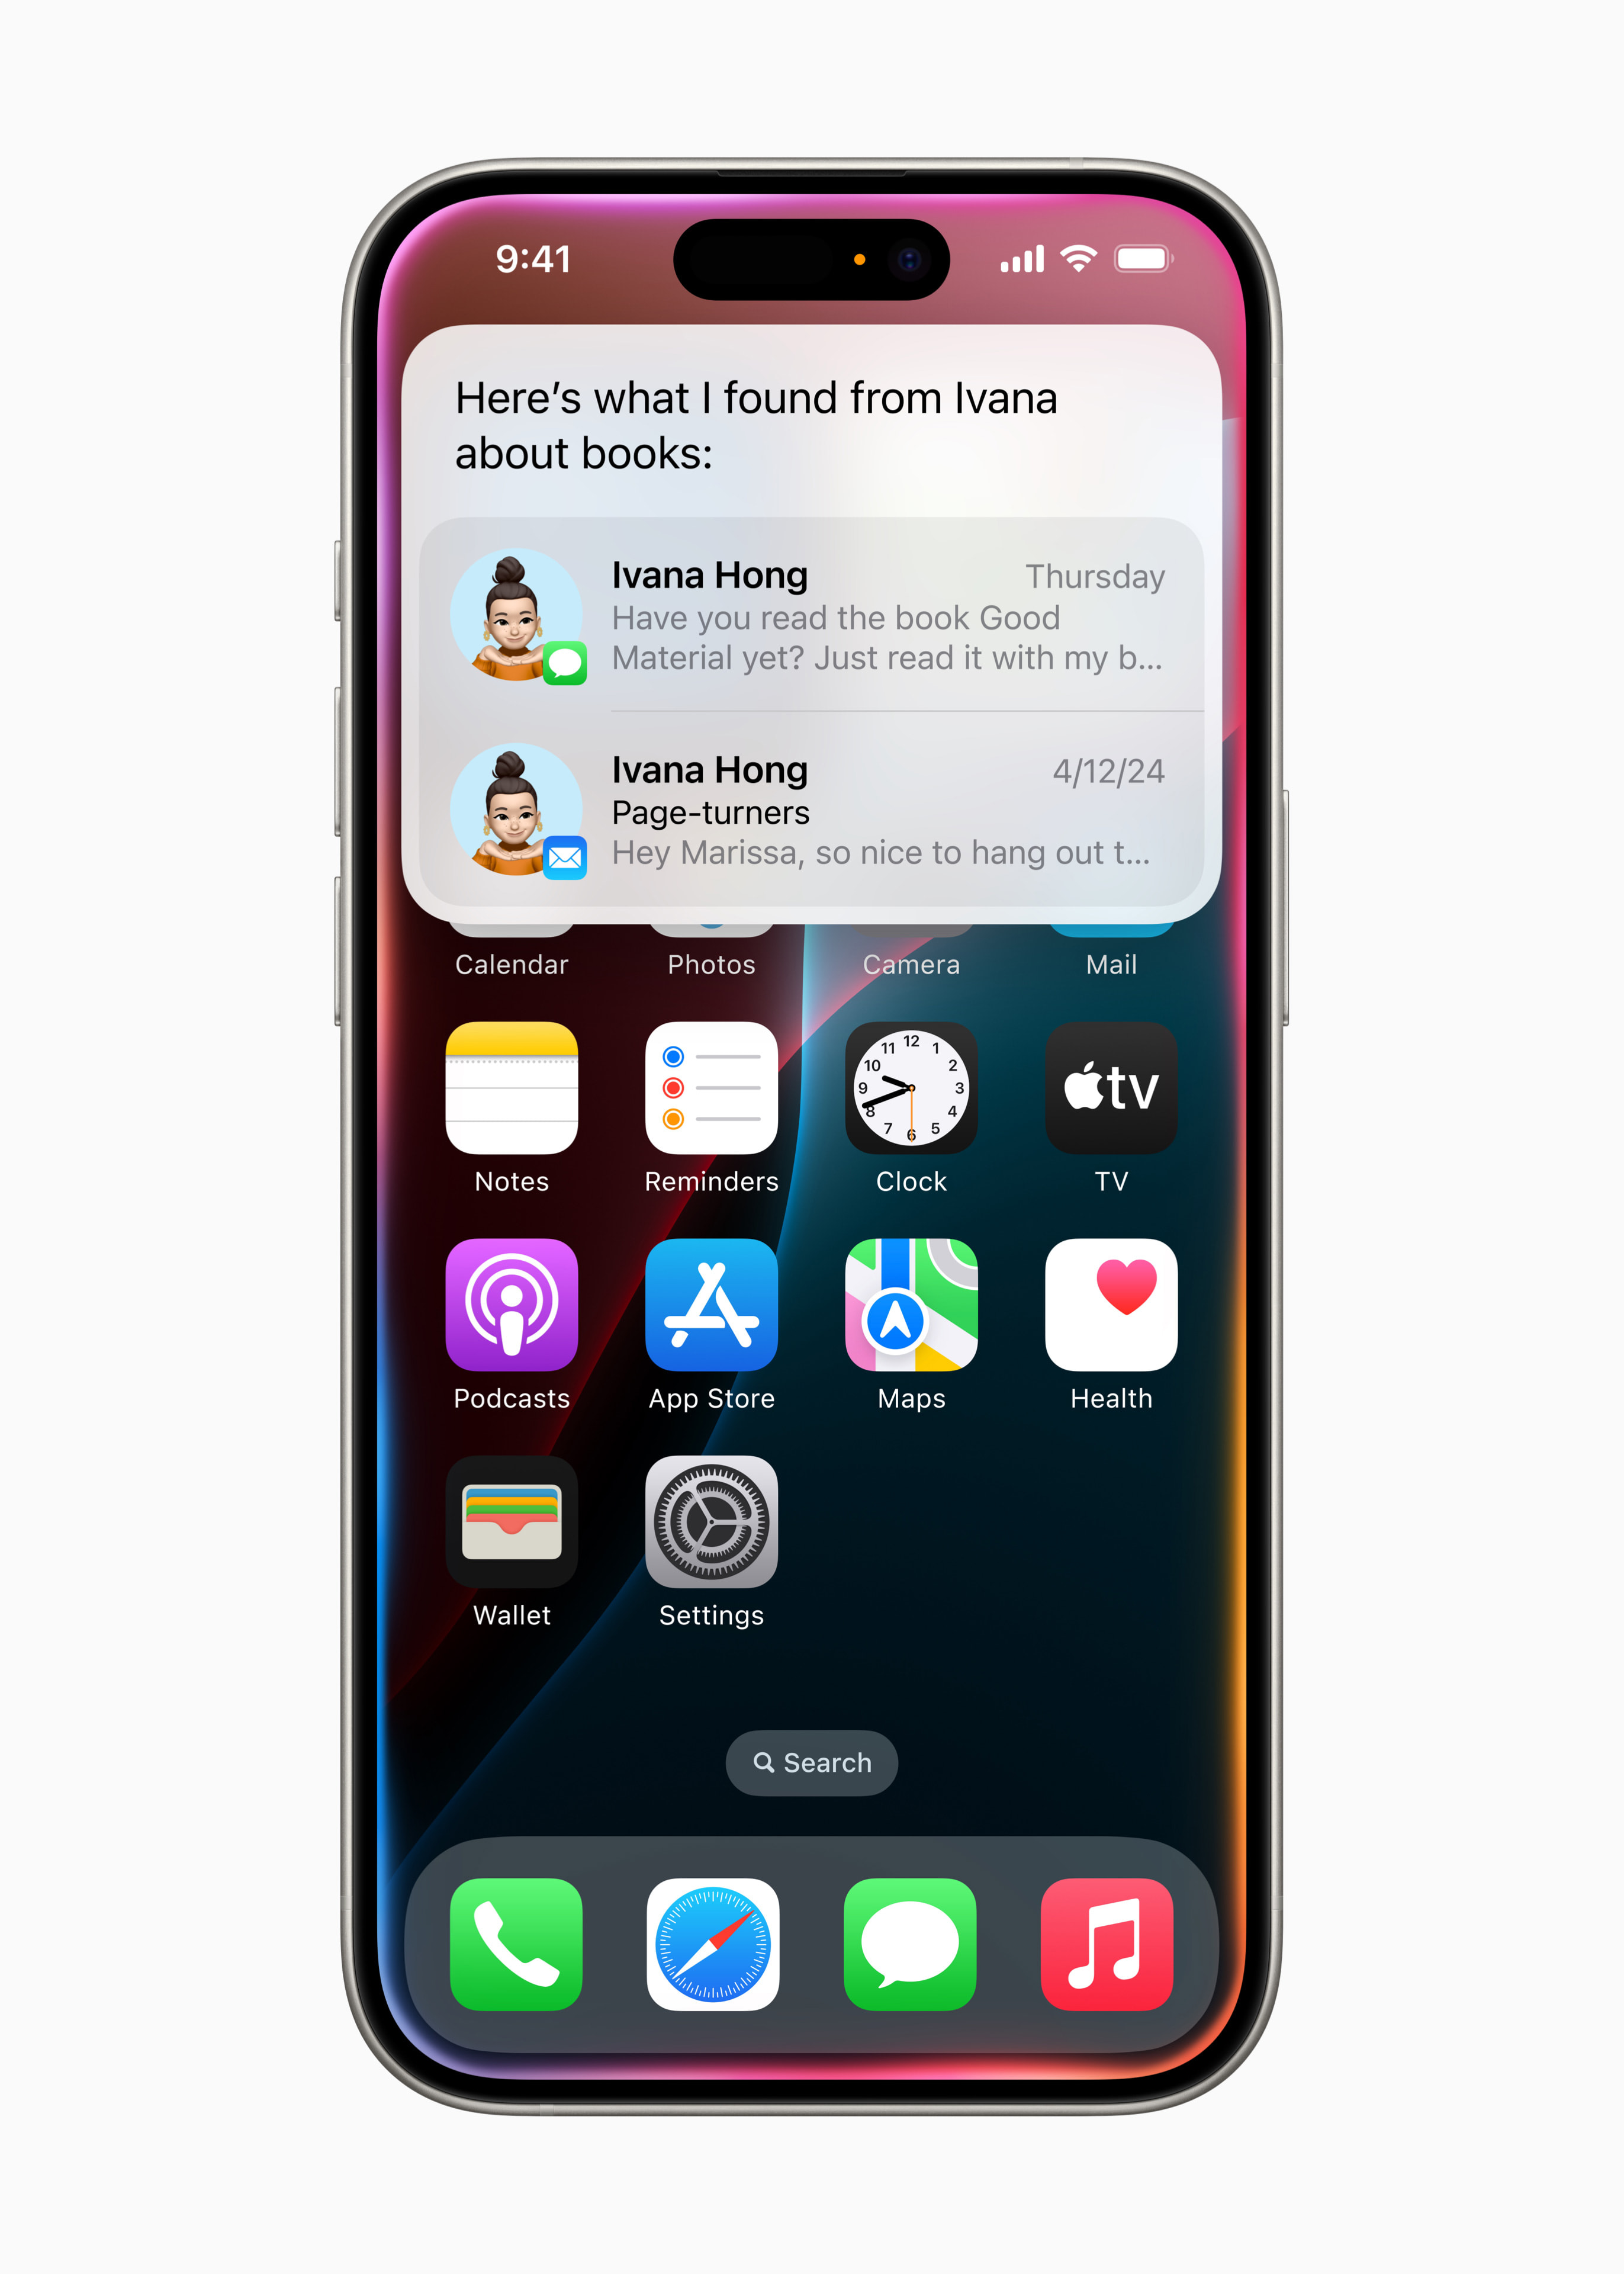
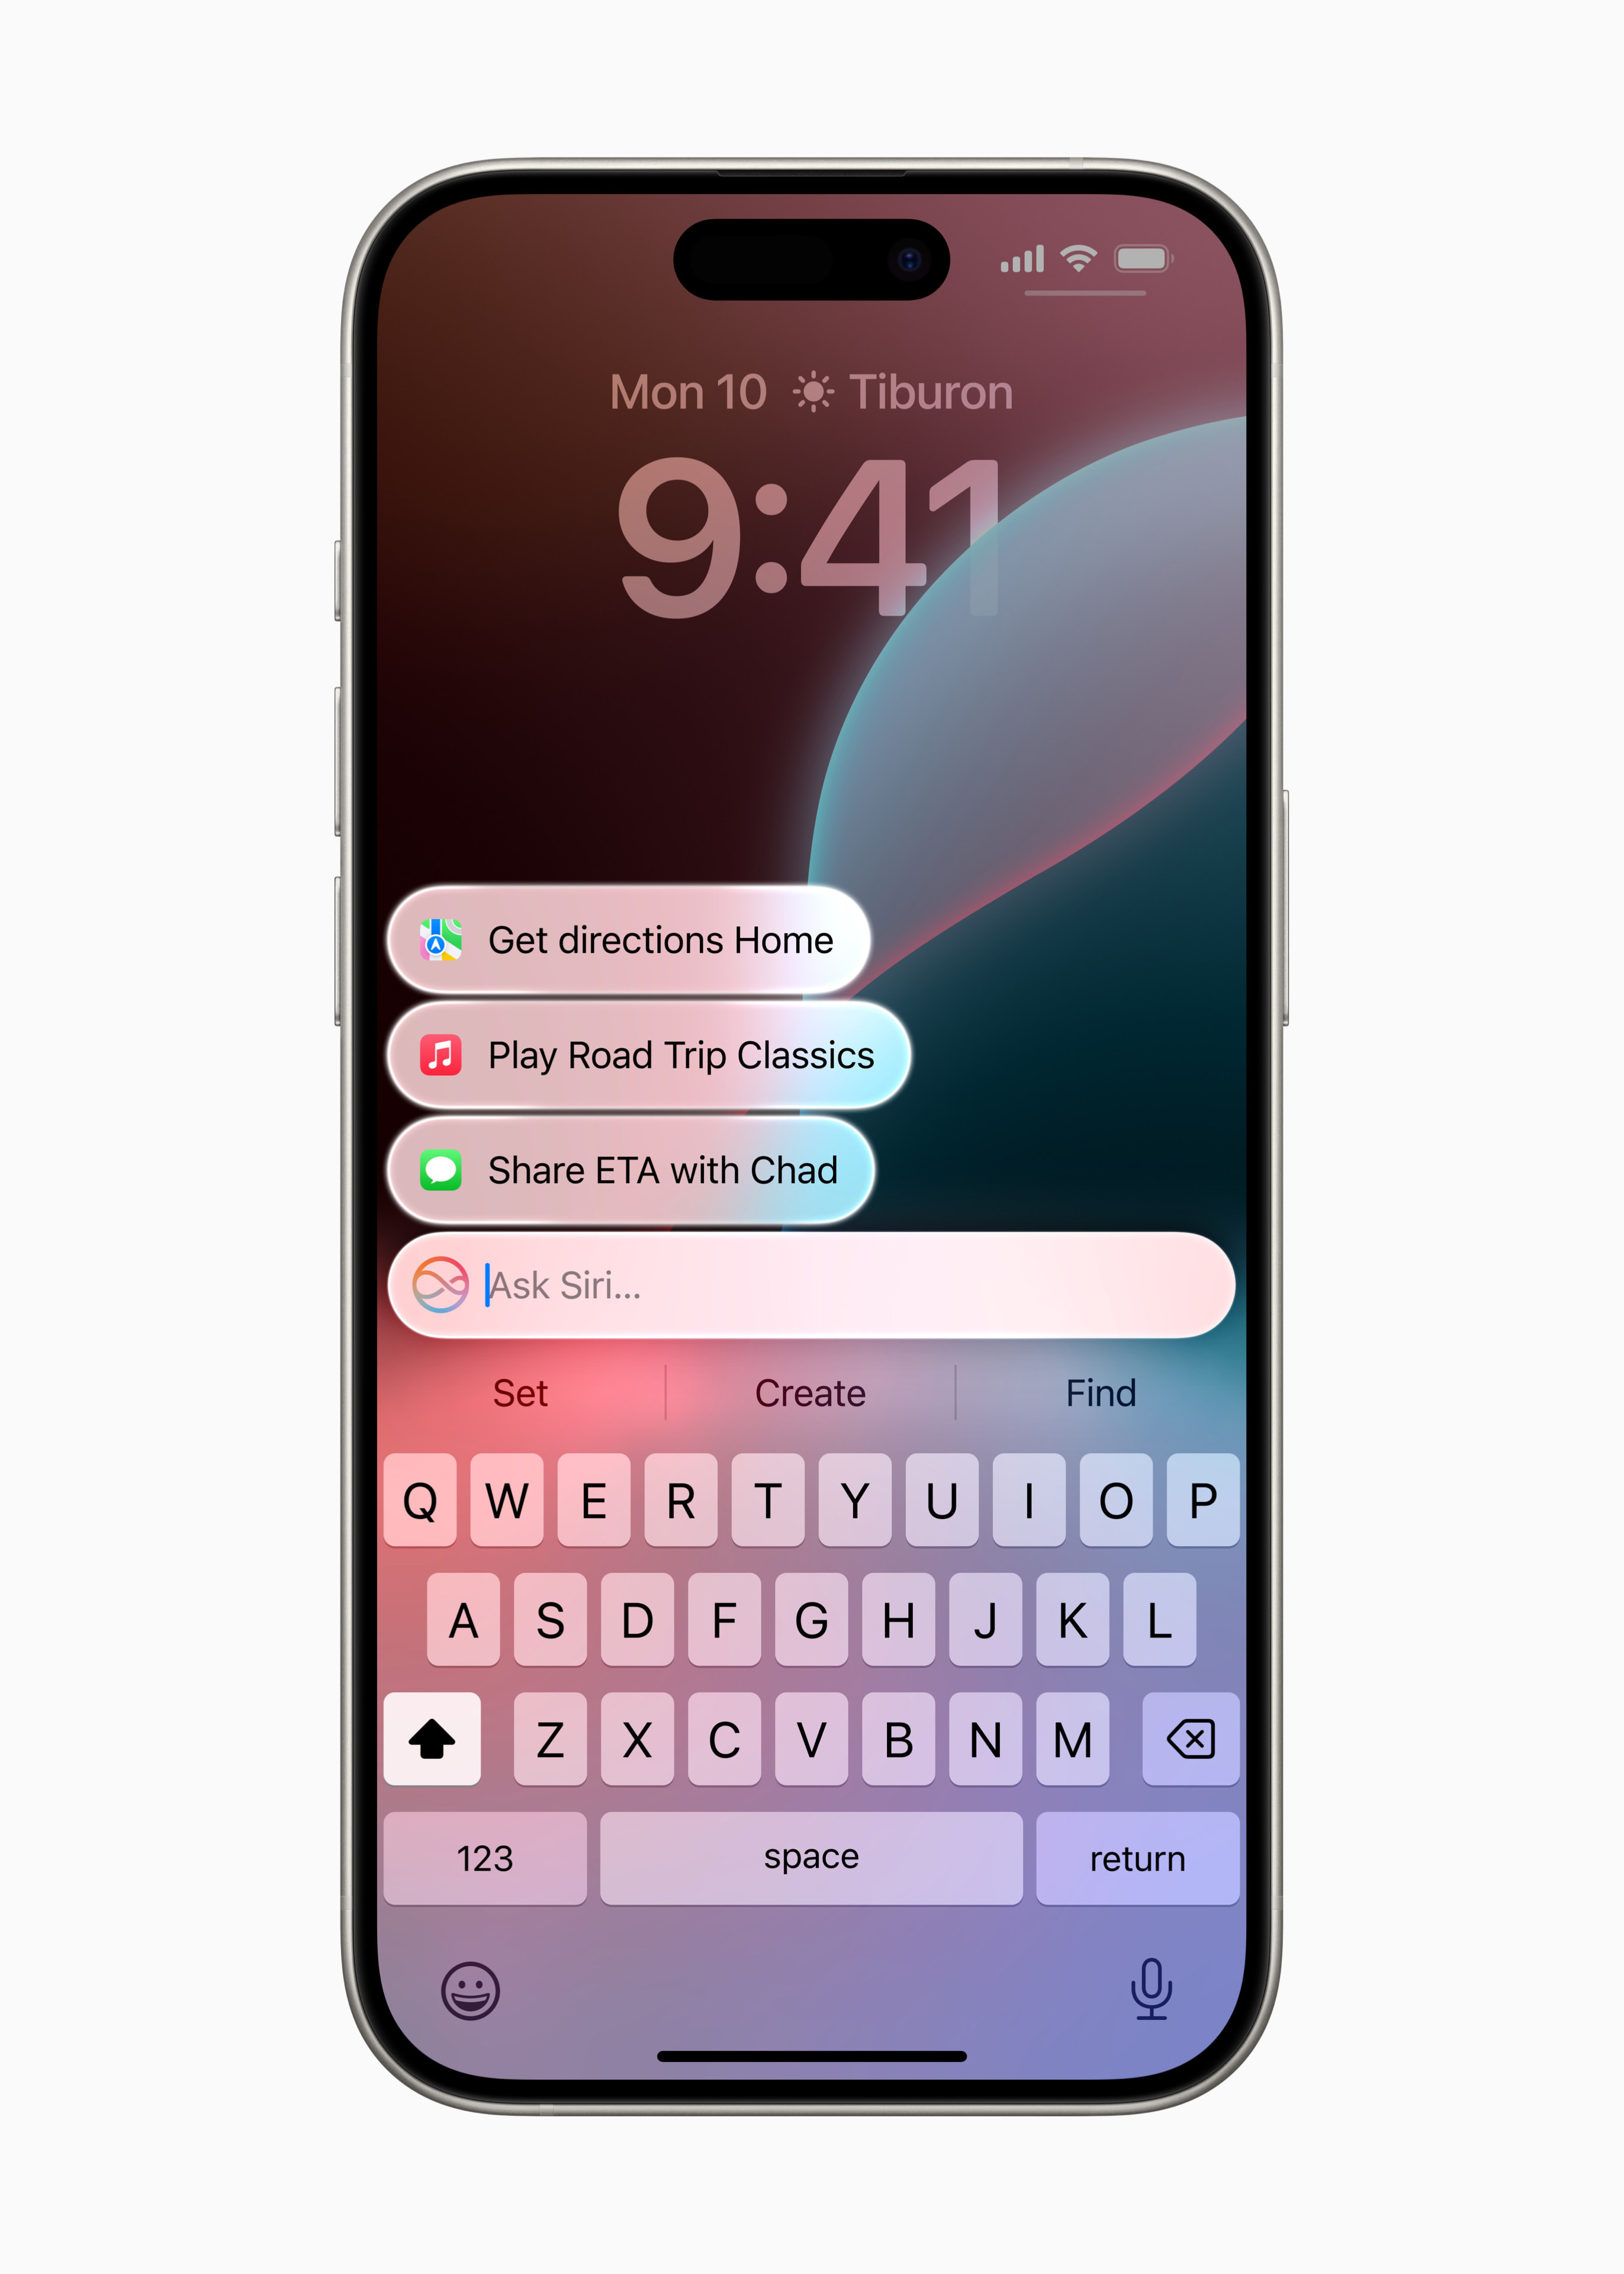
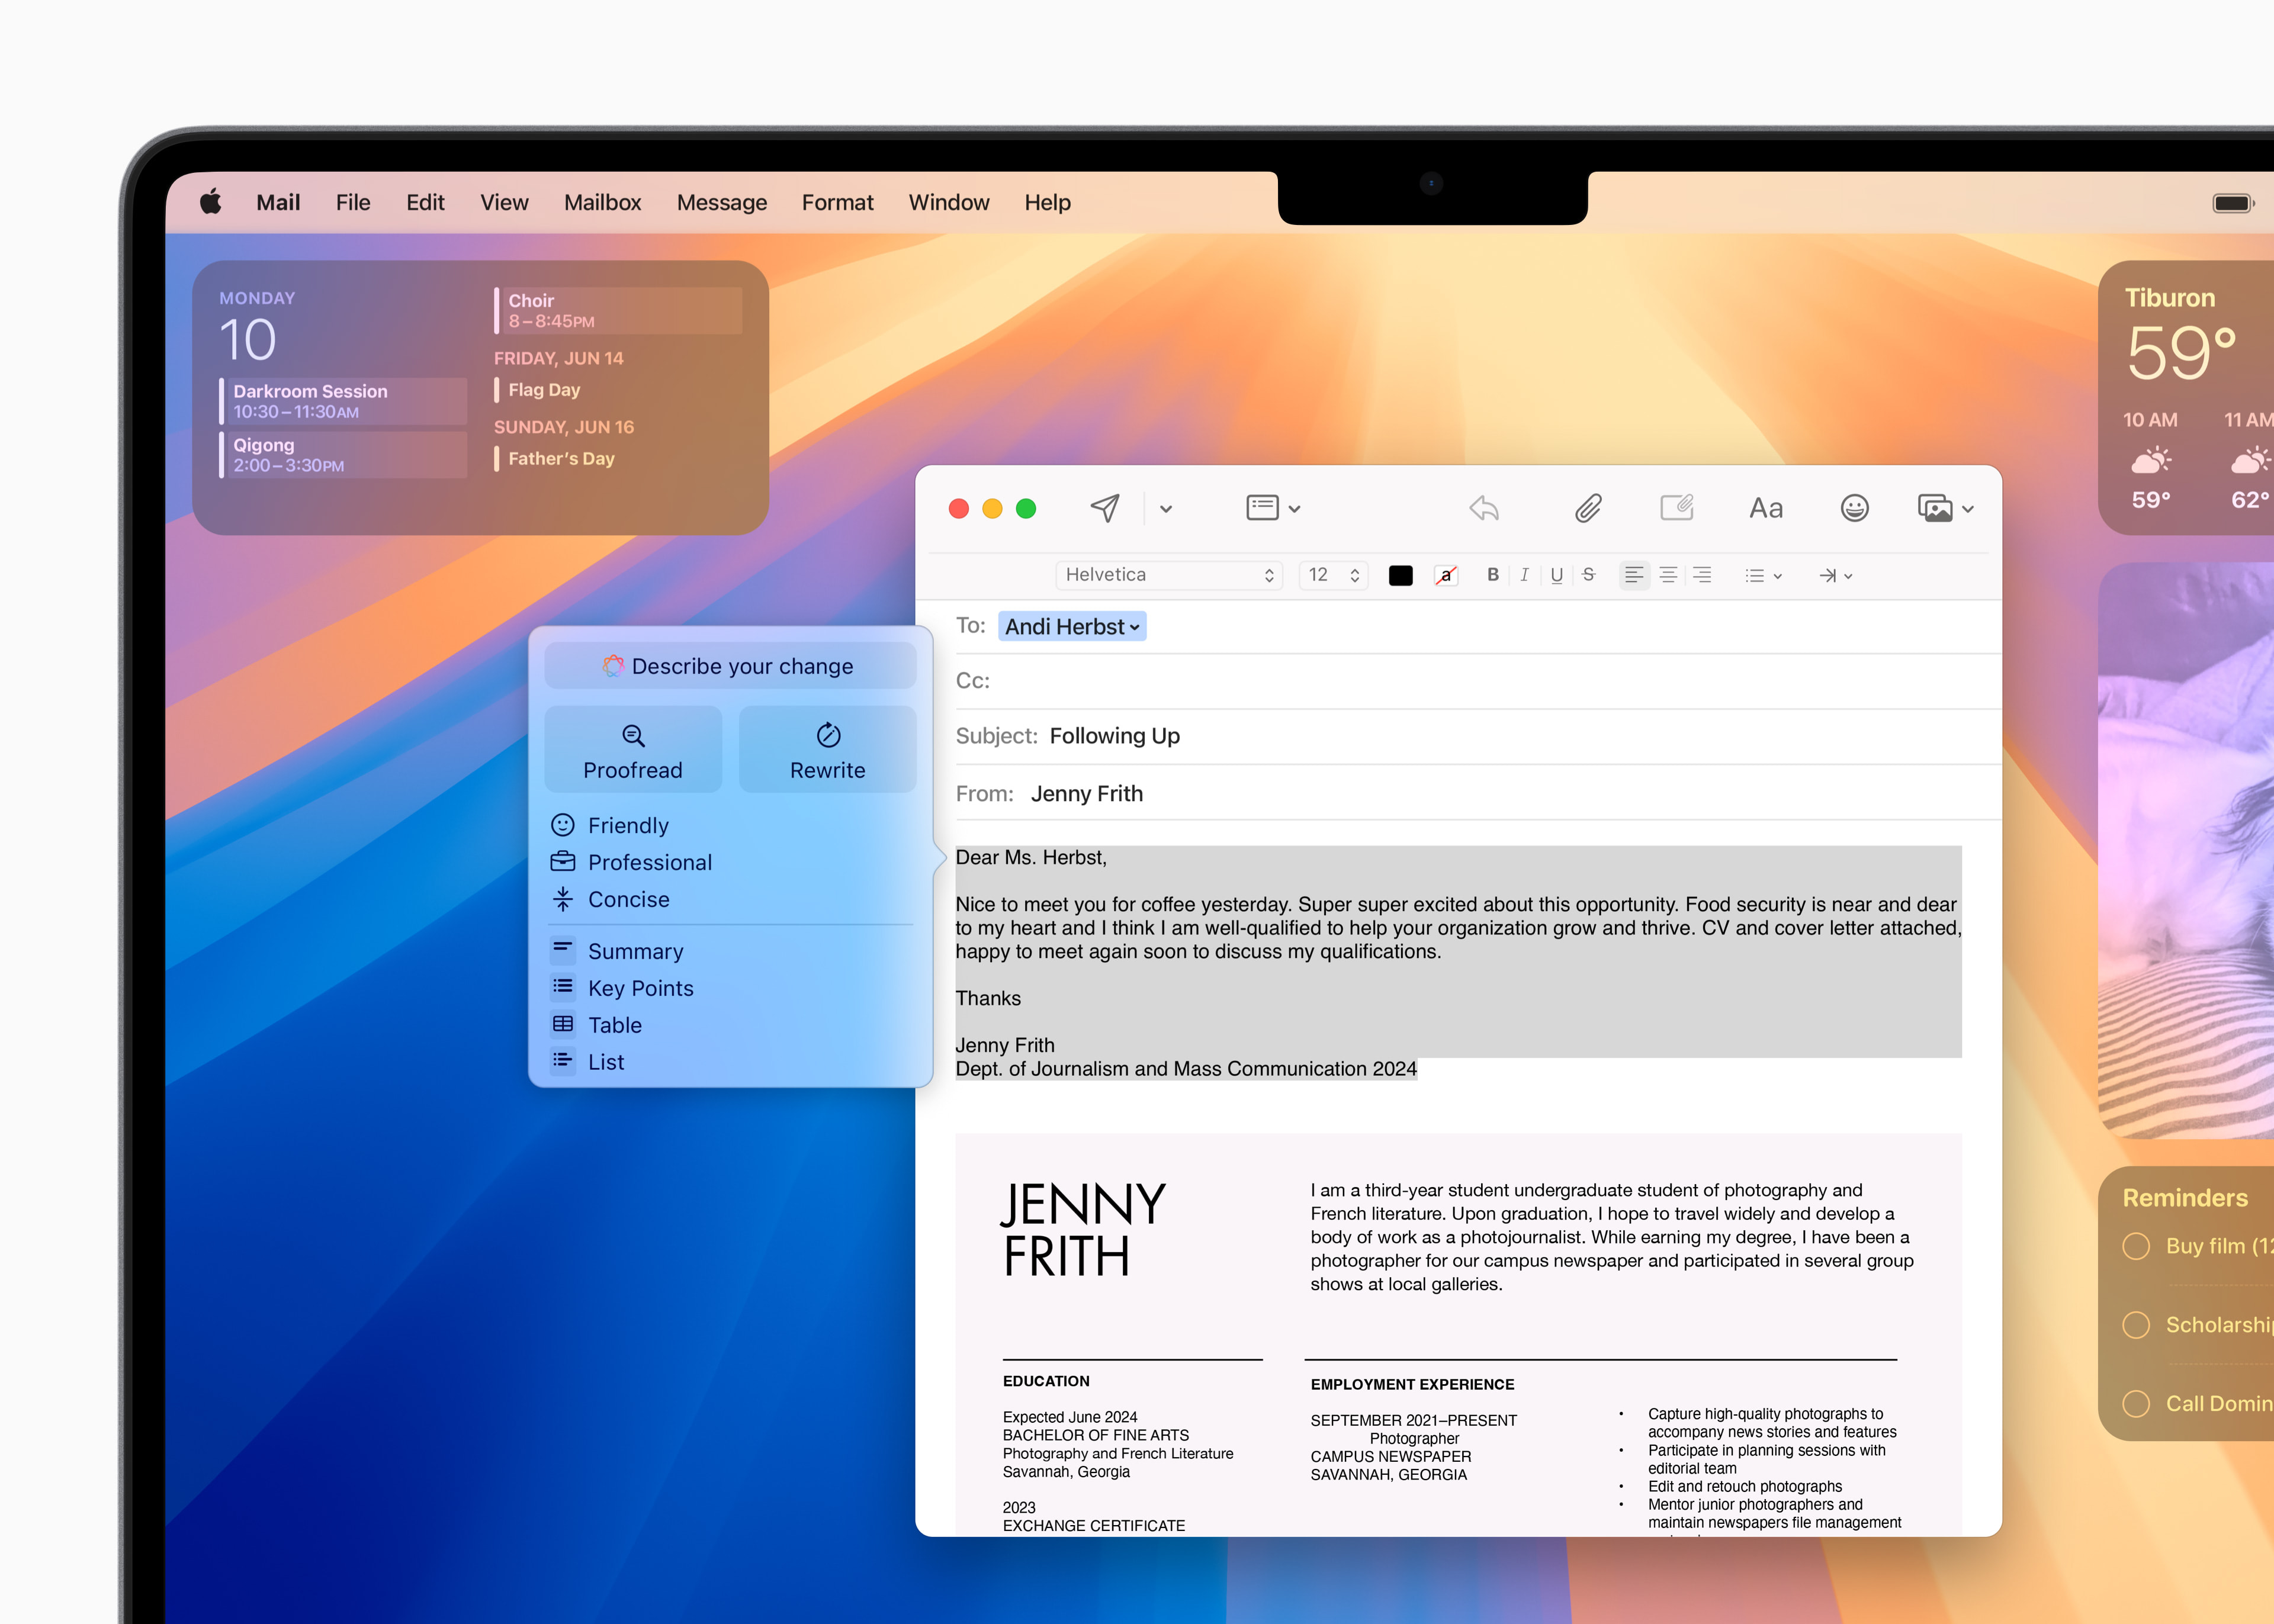
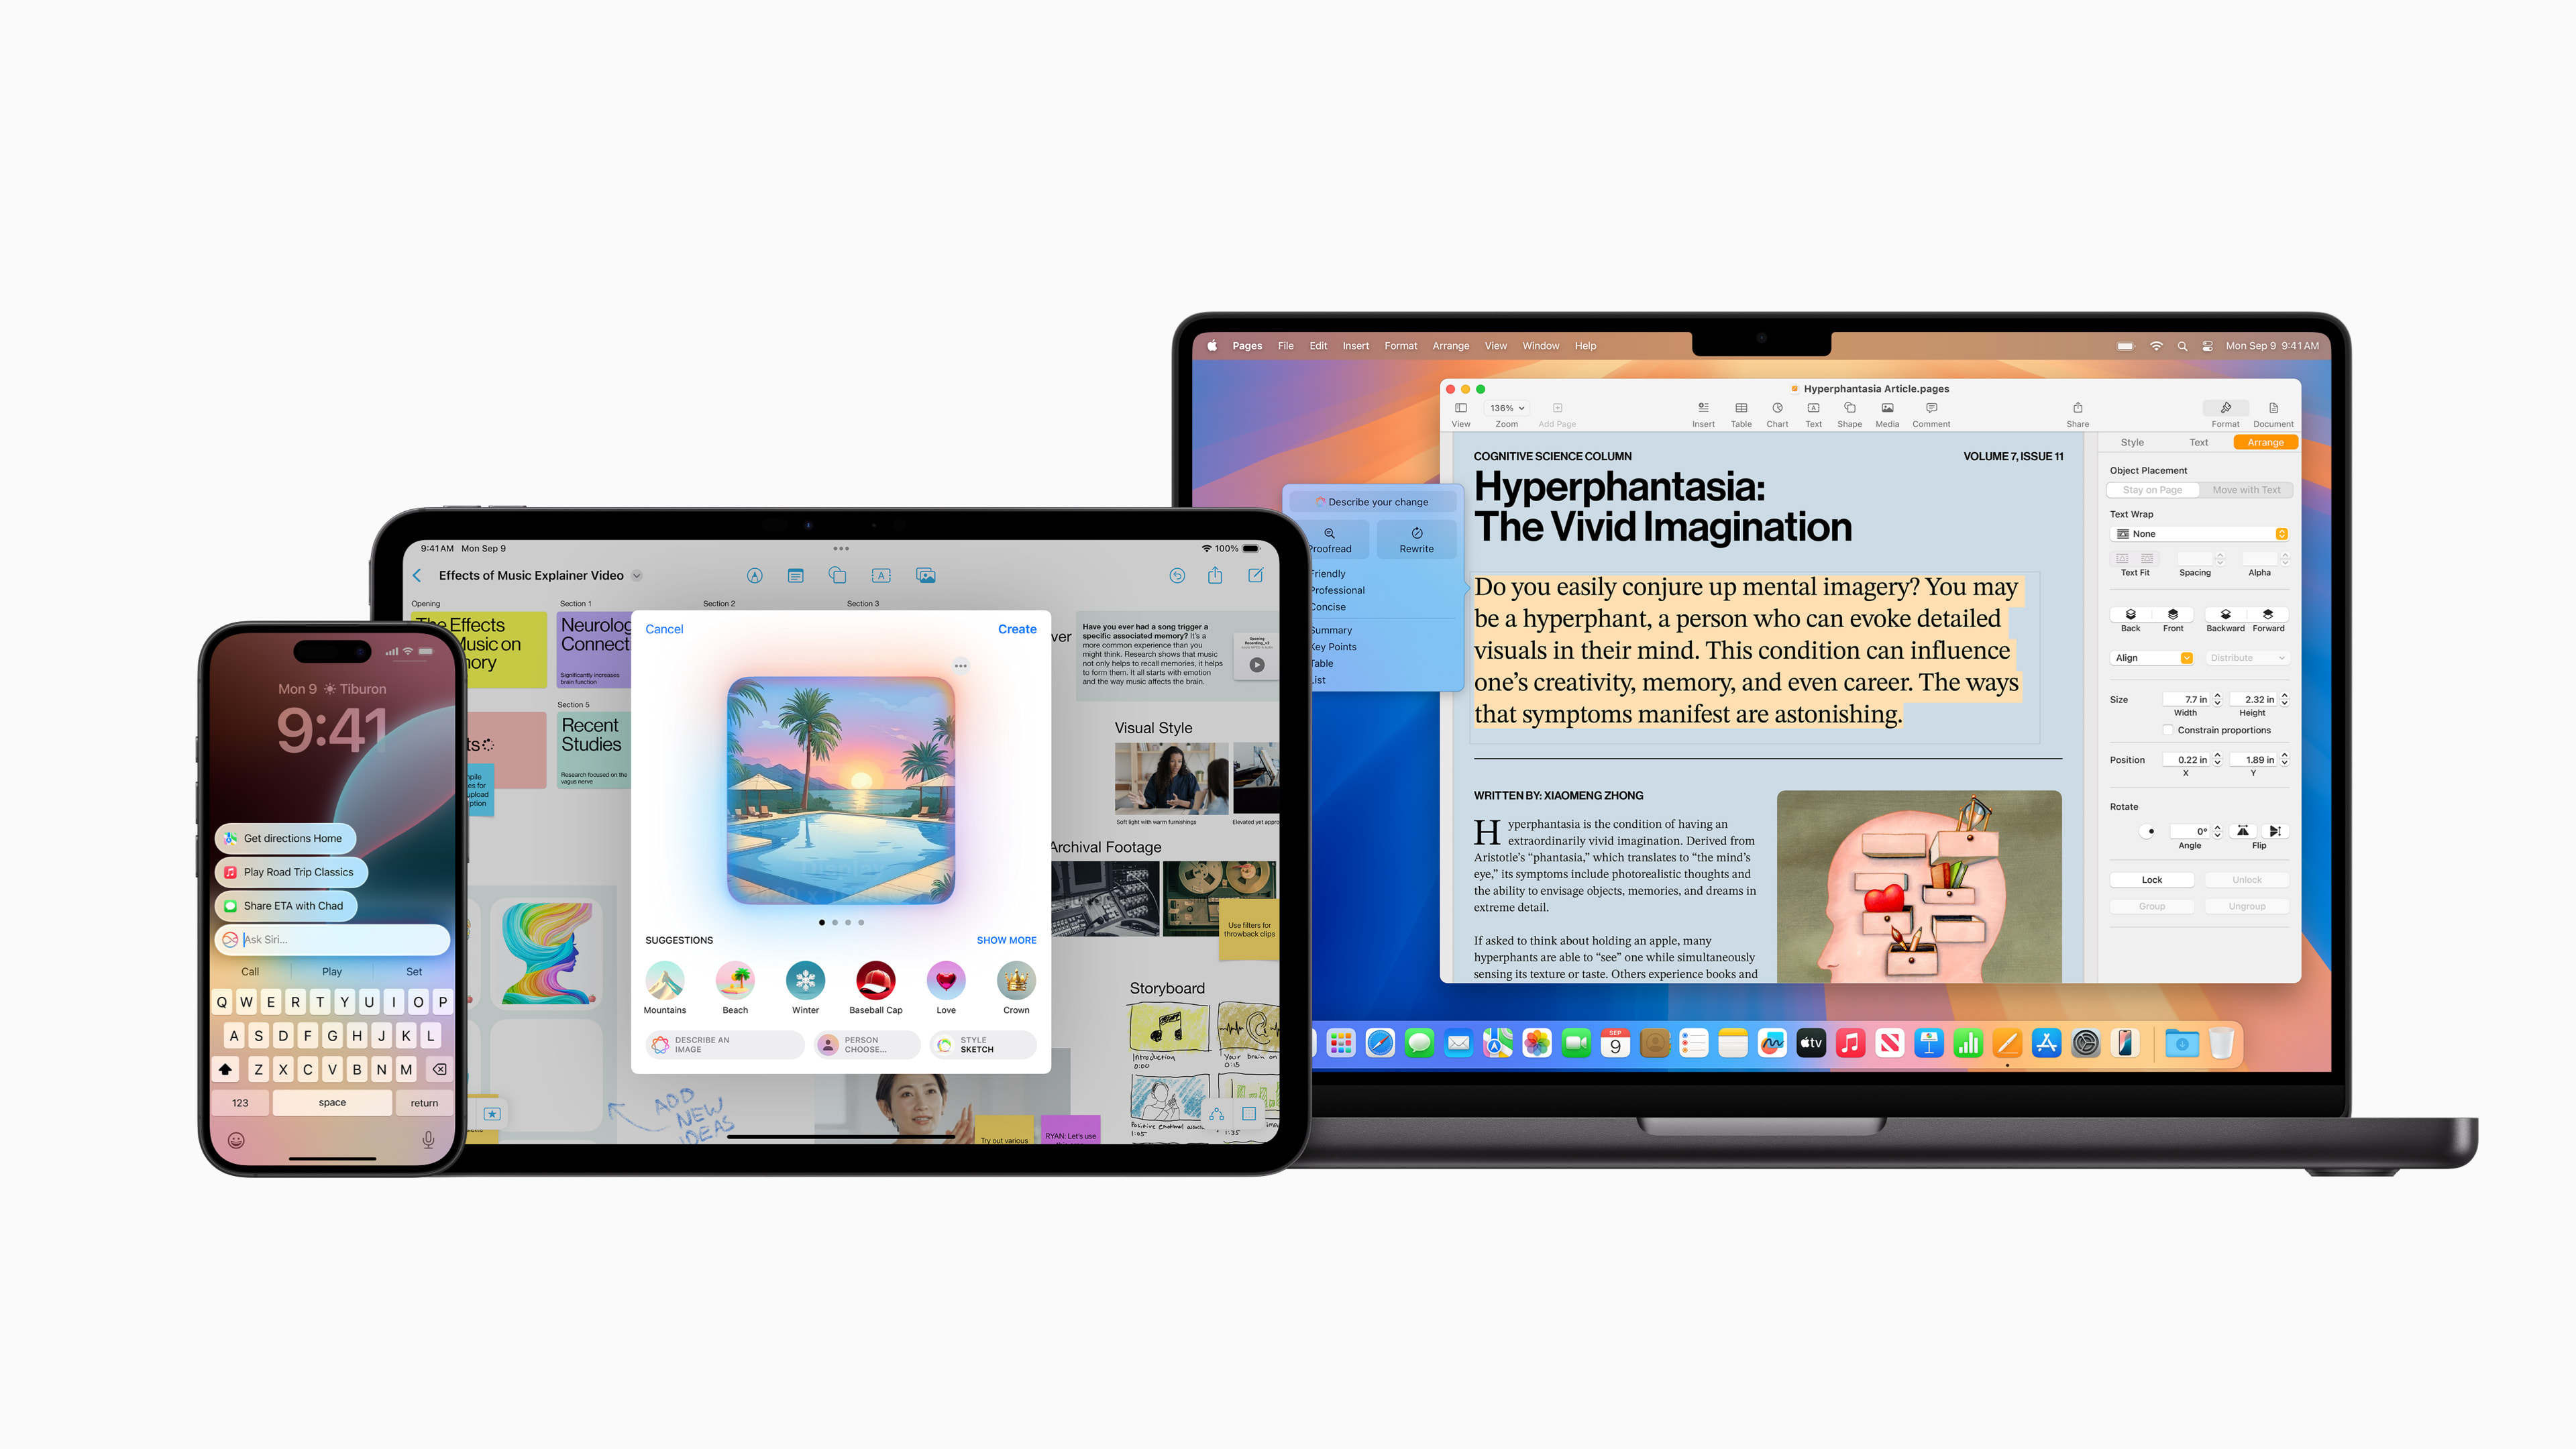
¿Qué pasa entonces? Apple Intelligence y modelos que se utilizan para su funcionamiento, Apple dice que en este caso todo se basa en datos con licencia, incluidos datos seleccionados para mejoras particulares de funciones específicas. Para un producto que es comercial, no hay peligro de controversia con el uso de datos obtenidos especialmente.



Ahora en. Pero se meten muy bien en el culo.