Apple steht vor einer neuen Sammelklage wegen angeblichen Missbrauchs urheberrechtlich geschützter Werke beim Training seines Sprachmodells für Apple IntelligenceDie Klage wurde von den Schriftstellern Grady Hendrix und Jennifer Roberson vor einem Bundesgericht in Kalifornien eingereicht.
Apple Intelligence vor gestohlenen Daten?
Nach Angaben der Agentur Reuters se Apple stützte sich angeblich auf einen Datensatz namens Books3, das auf den Inhalten der „Schattenbibliothek“ von Bibliotik basiert. Laut der Klage enthielt sie Tausende Raubkopien von Büchern. Books3 war kurzzeitig auf der HuggingFace-Plattform verfügbar und wurde später Teil des RedPajama-Datensatzes, der in OpenELM-Modellen verwendet wird. Diese Apple im Jahr 2024 verfügbar gemacht.
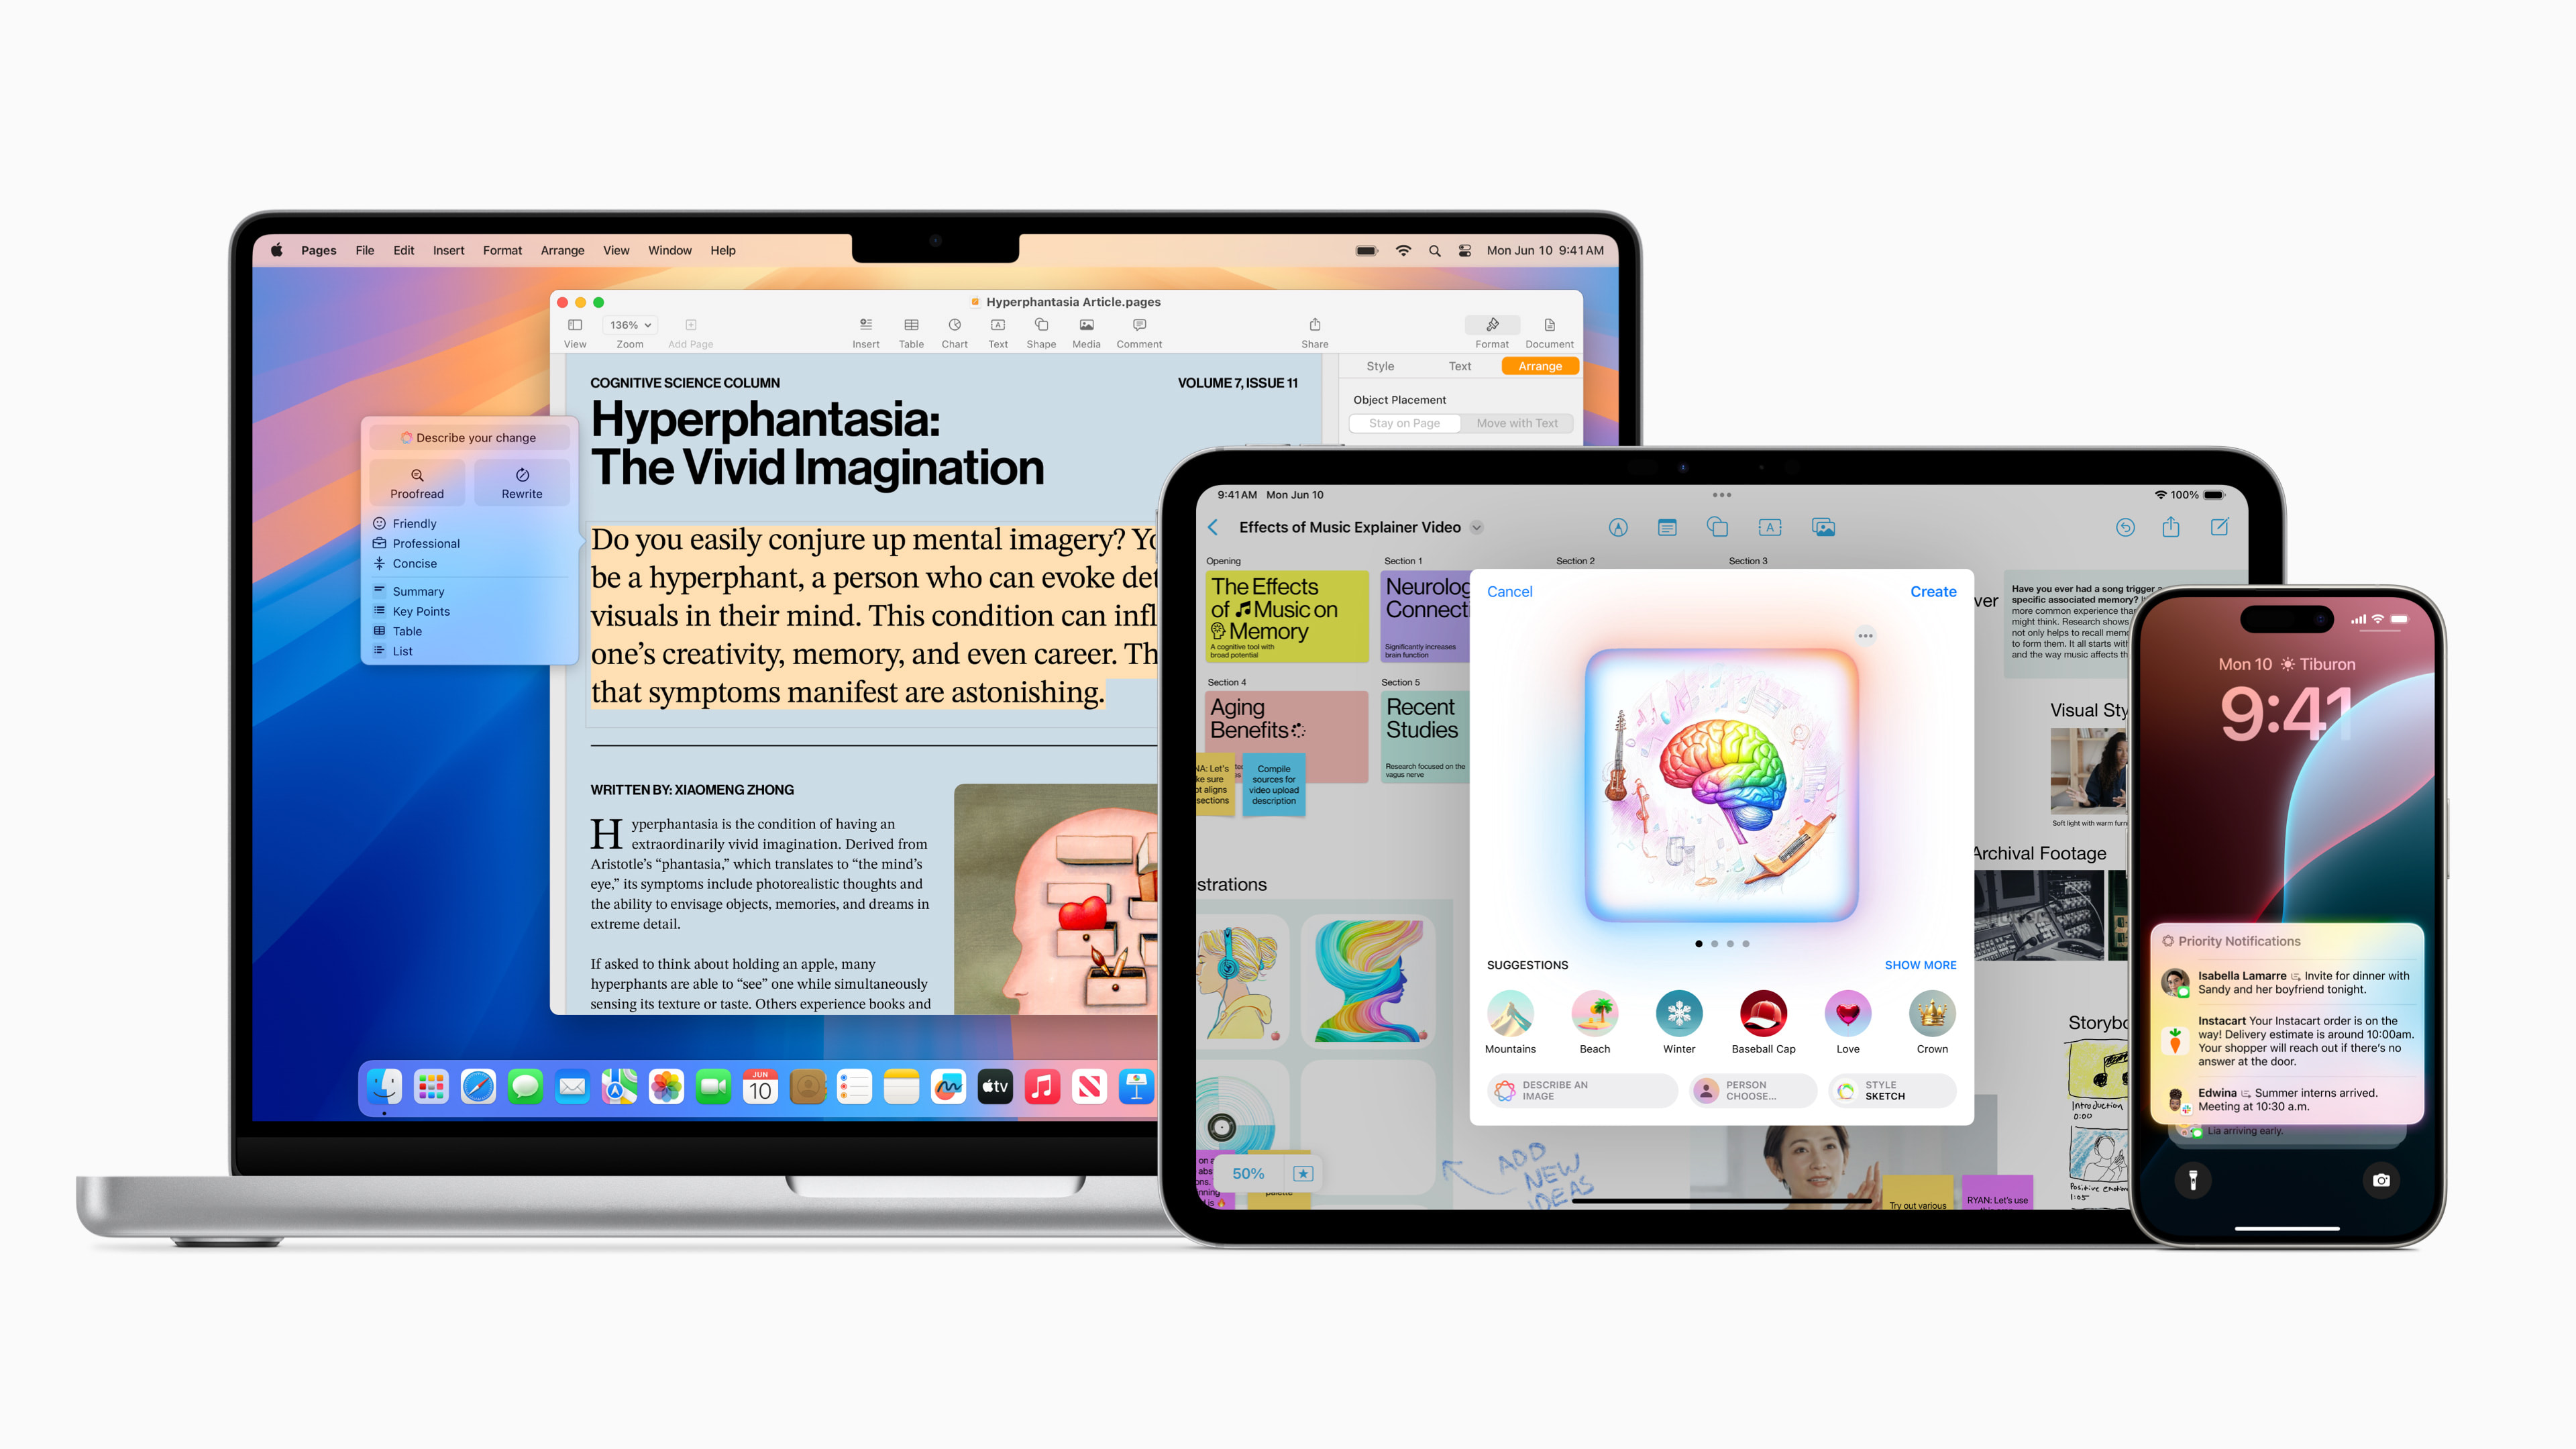
Die Kläger argumentieren, dass, wenn dieser Datensatz zur Entwicklung von OpenELM verwendet wurde, es sehr wahrscheinlich ist, dass dieselben Verfahren Apple auch für die Entwicklung seiner Stiftung verwendet Language Modelmit denen sind die Basis Apple Intelligence.
Fotogalerie
Die Autoren weisen auch darauf hin, dass Apple hat nicht versucht, die Autoren der Bücher, deren Inhalte zum Trainieren der Modelle verwendet wurden, zu kontaktieren oder zu entschädigen. Sie fordern ein Schwurgerichtsverfahren, Schadensersatz, die Vernichtung der mit diesem Datensatz erstellten Modelle und die Erstattung der Anwaltskosten.
Apple kümmert sich um Datenschutz und Ethik
Apple hat sich bereits als Unternehmen präsentiert, dem die Ethik der künstlichen Intelligenz besonders am Herzen liegt. So hat das Unternehmen bereits Vereinbarungen mit Verlagen und Shutterstock getroffen, um die legale Nutzung von Texten und Bildern für Schulungszwecke zu gewährleisten. Das Unternehmen hat sich zudem öffentlich dazu verpflichtet, die Robots.txt-Regeln zu respektieren und Website-Inhalte nicht ohne Zustimmung der Eigentümer zu analysieren.
Aber ob Apple tatsächlich verwendete Raubkopien von Inhalten, werden nun einer gerichtlichen Überprüfung unterzogen.