Apple overraskede tech-miljøet ved at udgive et massivt forskningsdatasæt, Pico-Banana-400K, der indeholder 400.000 billeder beregnet til træning af AI-modeller med fokus på fotoredigering baseret på tekstinstruktioner. Måske endnu mere overraskende er dets oprettelse Apple brugte modeller Gemini-2.5 fra Google.
Datasættet har en ikke-kommerciel forskningslicens, hvilket betyder, at det frit kan bruges af akademikere og forskere over hele verden – men ikke til kommercielle formål. Det indeholder også en videnskabelig artikel offentliggjort på arXiv, der beskriver hele projektet i detaljer.
Fotogalerie
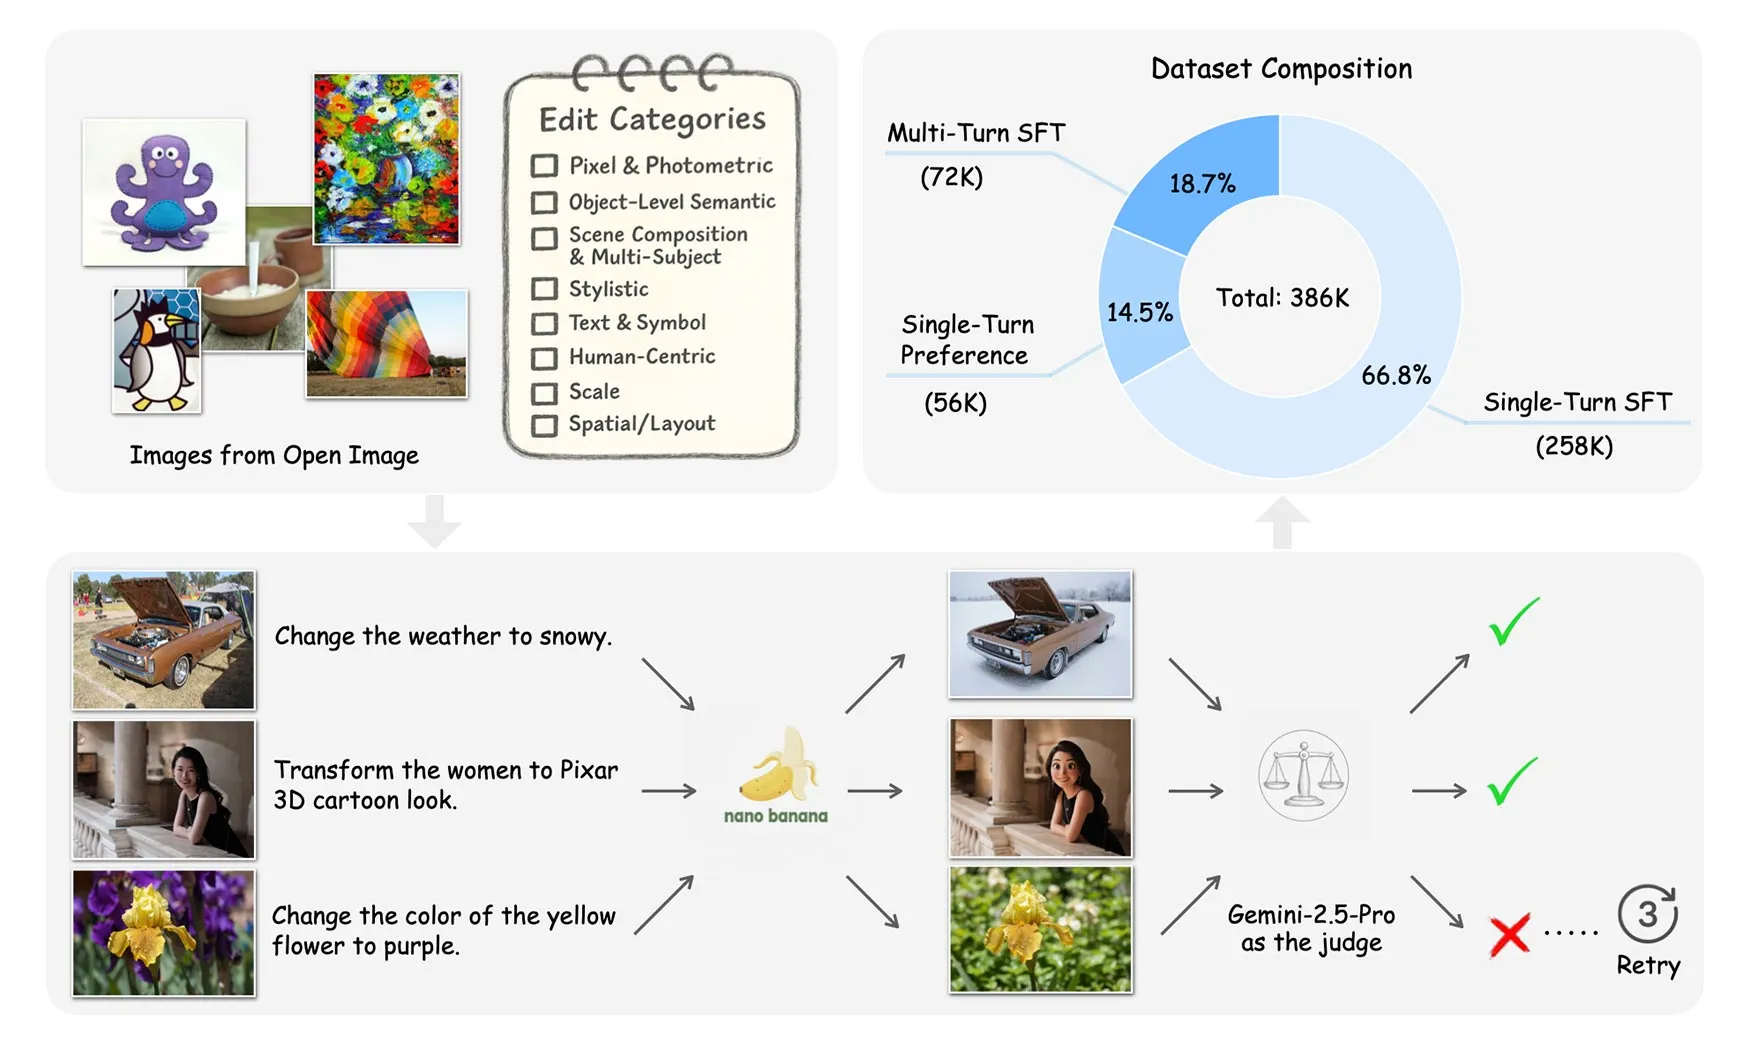
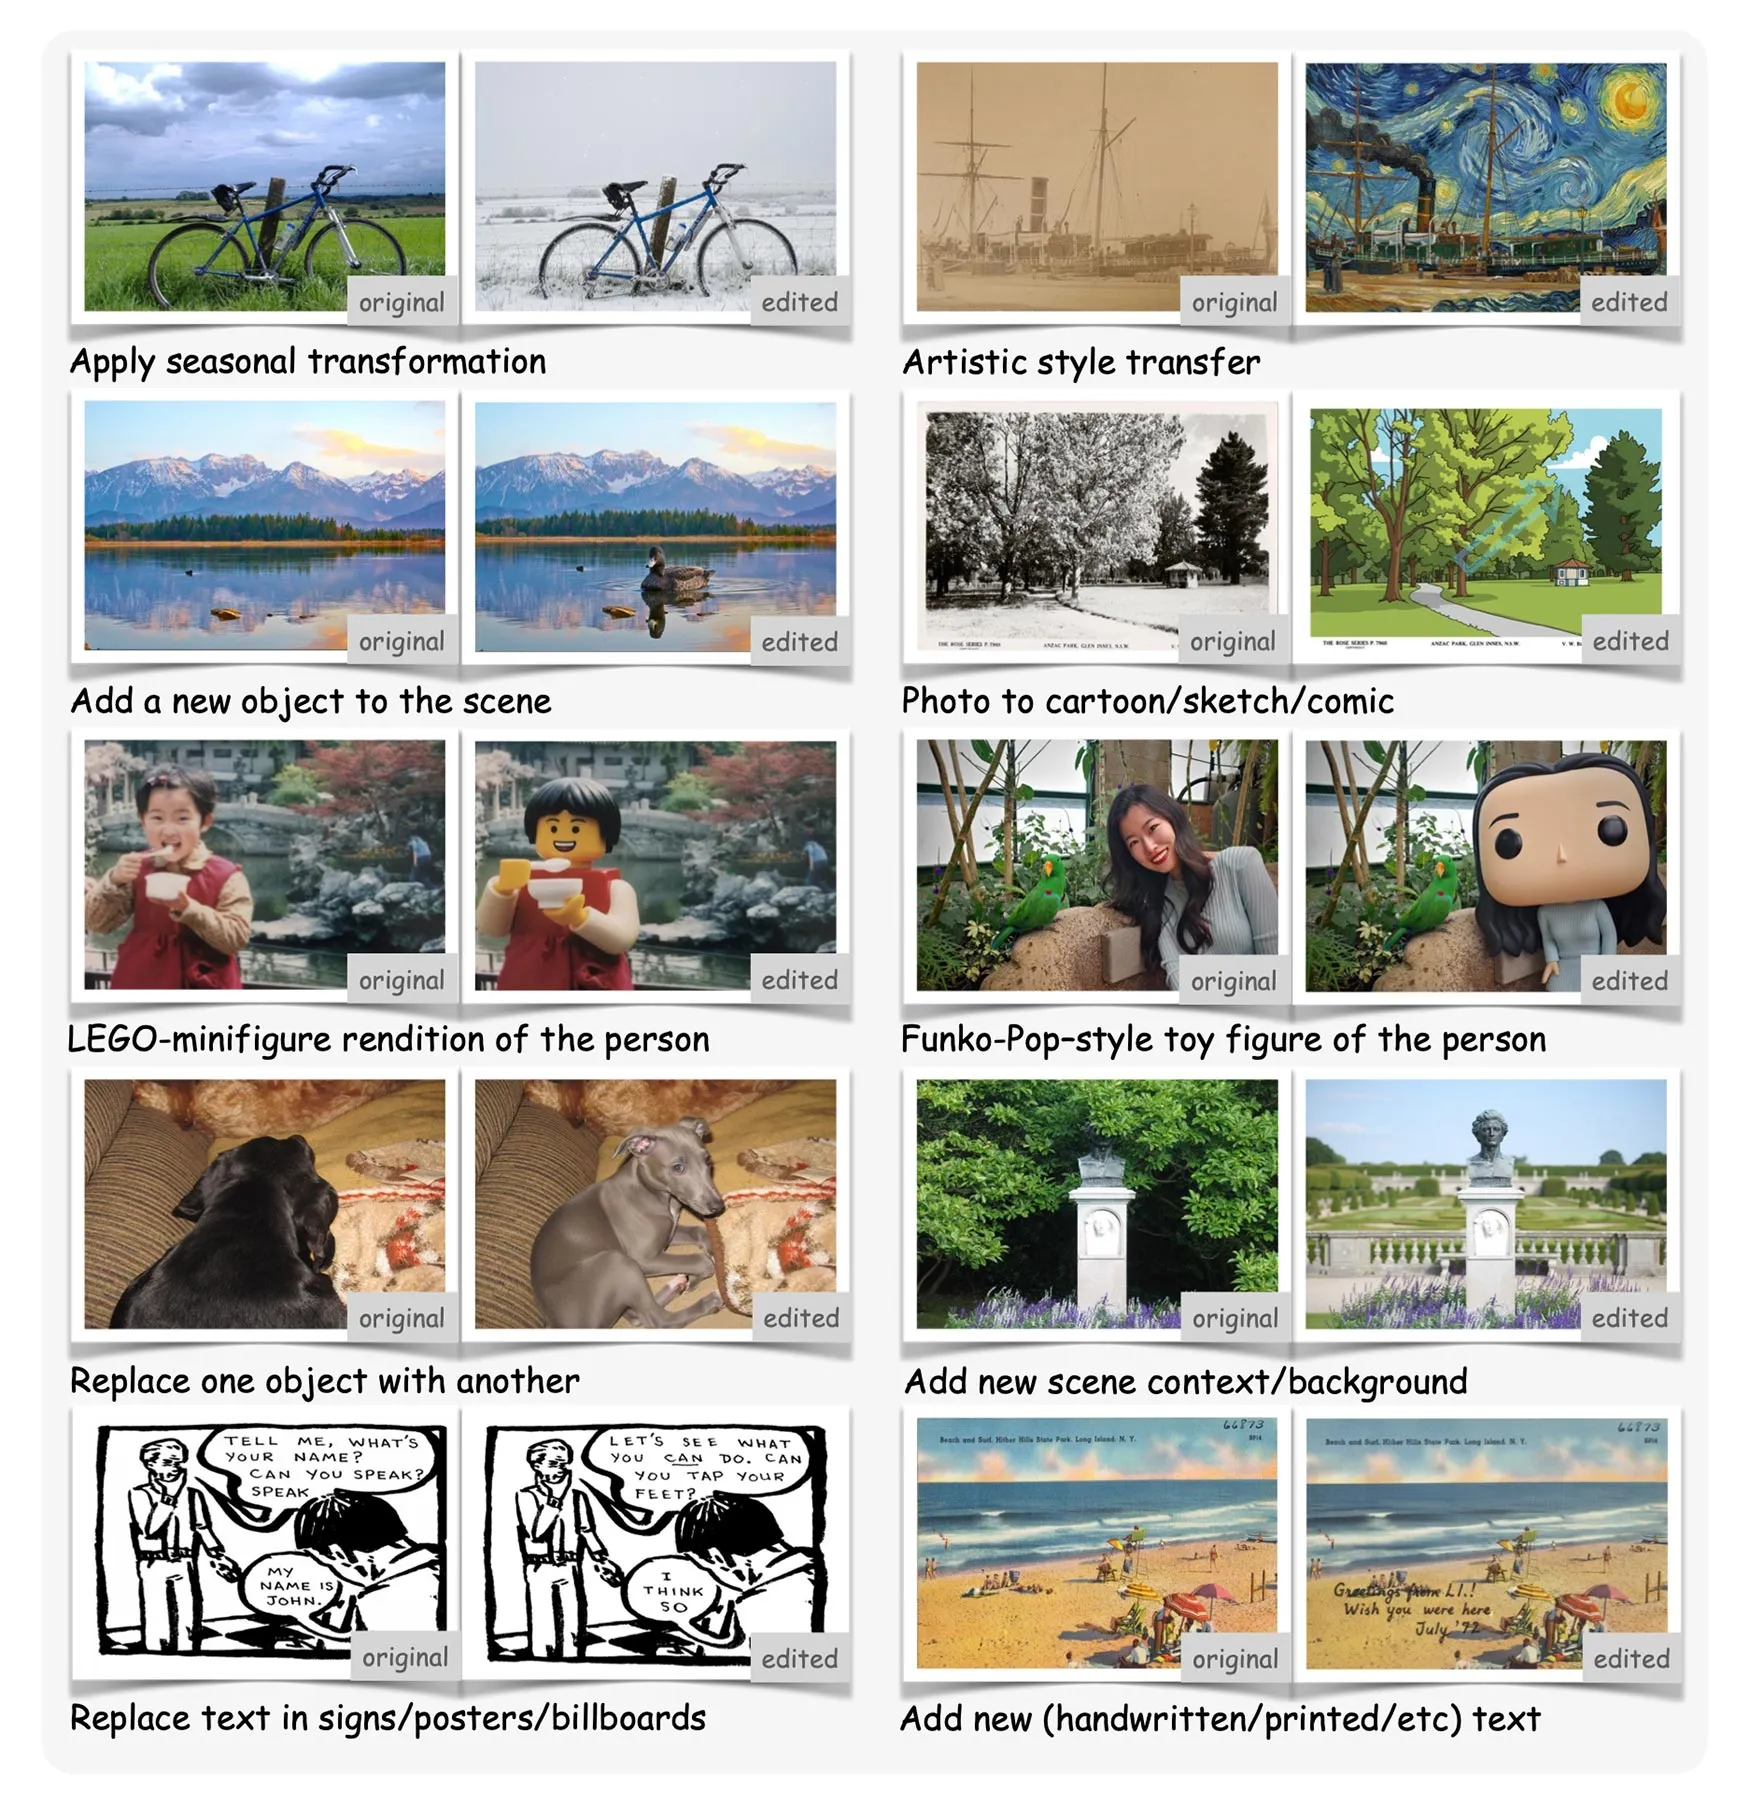
Formålet med projektet var at eliminere manglerne ved eksisterende datasæt, som ofte lider af inkonsistens, ubalance og lav kvalitet. Apple Han udvalgte rigtige fotos fra det offentlige OpenImages-datasæt og foreslog 35 typer redigeringer opdelt i otte kategorier – f.eks. ændring af vejret, tilføjelse af en filmeffekt, flytning af et objekt eller stilisering af en person.
Hvordan Pico-Banana-400K blev skabt
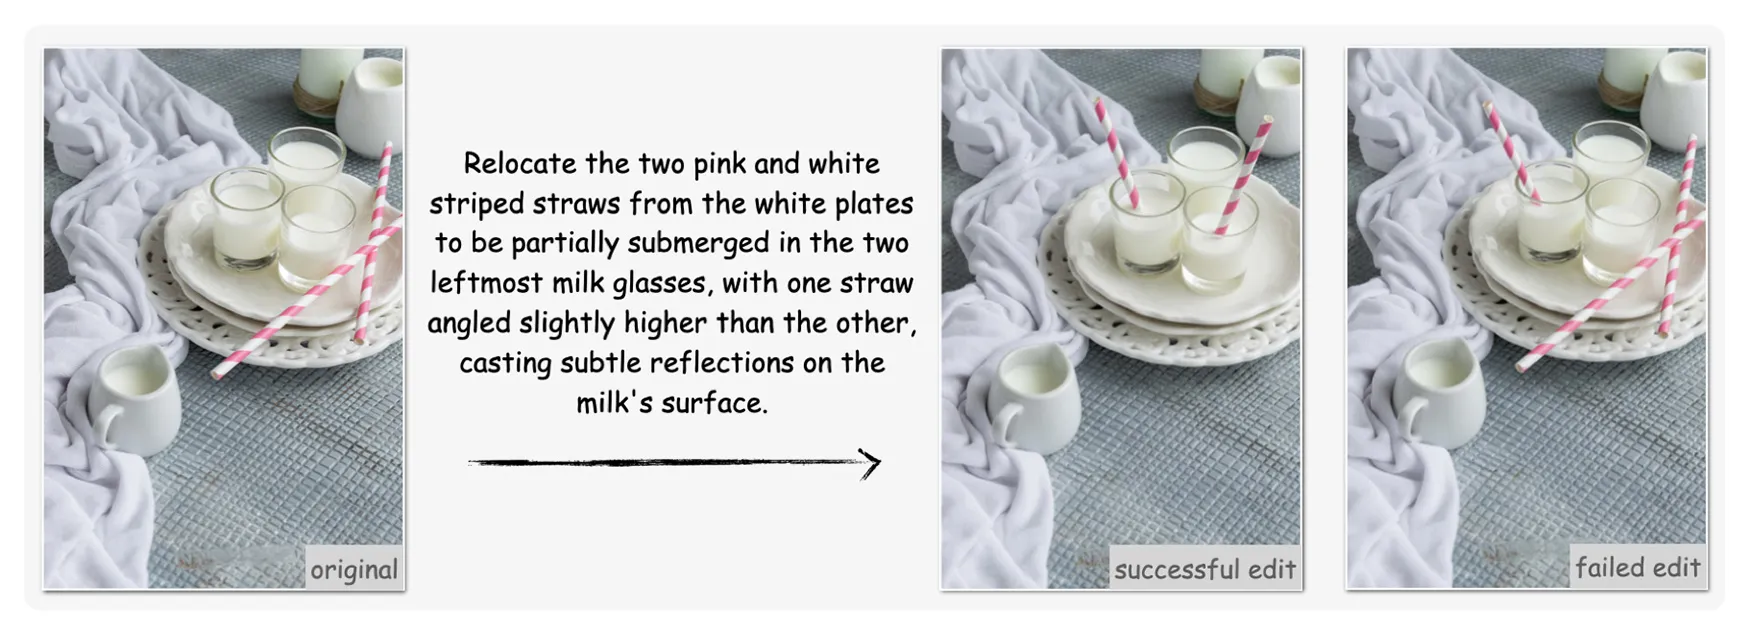
Forskerne indlæste hvert billede i en "Nano-Banan"-model (det interne navn for Gemini-2.5-Flash-Image) sammen med en af modifikationerne. Outputtet blev derefter analyseret af modellen Gemini-2.5-Pro og besluttede, om den givne redigering opfyldte kravene og var af visuel kvalitet. Dette resulterede ikke kun i vellykkede redigeringer, men også eksempler på mislykkede forsøg, som vil blive brugt til at træne AI'en til at genkende og undgå fejl.
Apple håber, at Pico-Banana-400K vil blive hjørnestenen i en ny generation af modeller, der redigerer billeder baseret på tekstuelle signaler med større nøjagtighed og konsistens. Datasættet er nu tilgængeligt på GitHub og kan i betydelig grad fremme AI-udviklingen inden for grafik og visuel skabelse.